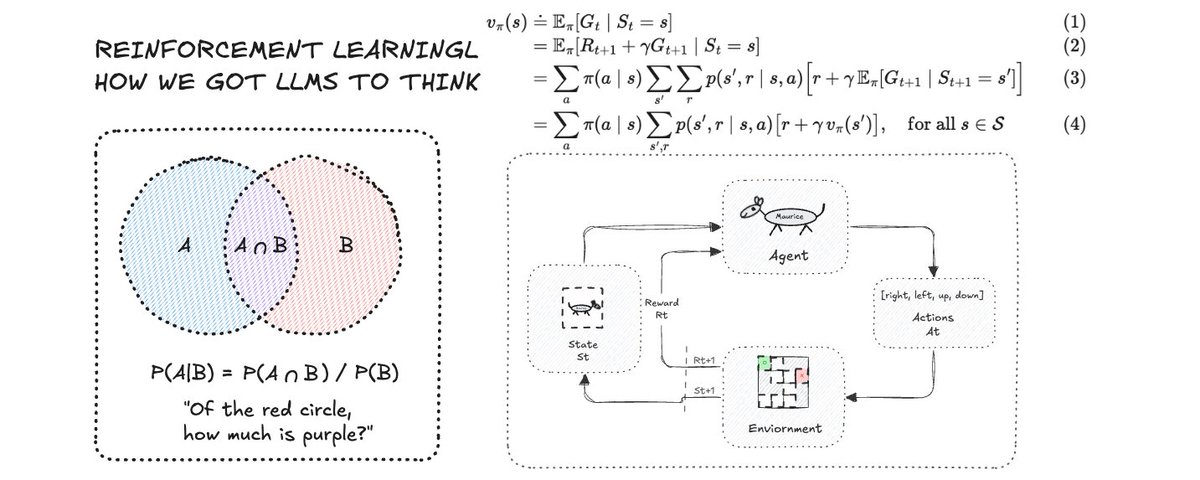
从零开始强化学习 #1
用赌场老虎机与迷宫两个故事,从零推导 k 臂老虎机、MDP、贝尔曼方程到动态规划,把强化学习的地基一次讲透。

现在我知道你一定很期待我 CUDA 博客的第二部分(如果你还没读过,去看看!),但是嘿!一个人可以有多样的兴趣。而且我相信,如果你想成为一名出色的 ML 工程师或开发者,或者只是对这个领域极其狂热,强化学习也一定撩动过你的大脑。
在我看来,如果 AI 对计算机科学来说是魔法,那么 RL 对 AI 来说就是魔法。
谈论 RL(或大多数其他 ML 话题)时,通常的思路是先列一个目录,展示将要涵盖的内容、问题是什么,等等等等。我们这些都不做。我们是创新者,我们对旧方式嗤之以鼻。
所以我们要做创新者该做的事:想出我们能想到的最简单的问题,做几个假设,试着解决它,然后慢慢让它变得更复杂。
我邀请你以开放的心态阅读以下内容。那么,让我们先来框定一个问题。
第一个问题
假设你帮邻居做了点零工,天真无邪的你刚刚拿到了人生第一张工资支票!
现在,你走在街上,发现了一个叫“赌场”的神奇地方,他们告诉你在这里可以让你的钱翻倍。于是你走了进去……
天哪,这是什么鬼地方!你被那些刺眼的灯光、四处飞舞的钞票、呕吐物颜色的地毯吓了一跳。但你满心欢喜,因为你即将让你的钱翻倍!!!

当你在这座迷宫中穿行时,你发现了一台看起来相当简单的机器。嗯,其实是一排机器,一台接一台地排列着。它们是老虎机!

你想也许应该在这里碰碰运气,因为它们看起来比扑克简单:你只需要把钱放进去,然后把钱取出来。
你试了第一台机器(假设我们投入一美元,如果赢了就能拿回一笔金额不详的钱;如果输了,机器就吞掉我们的钱!!!)。试了30次之后,你发现自己的钱不但没有变多,反而亏了一大笔。
这不对啊,宣传册上说庄家从不作弊(哦,天真的孩子,要是这个世界像你一样纯真就好了),而且你的钱确实会翻倍。当然,你会输掉一些次数,但如果这个说法是真的,那么平均而言,只要你玩得够多,赢的应该比输的多!
于是你开始琢磨,环顾四周,就在这时你注意到 3 号机器上的那个人似乎赢了不少钱。于是你等他离开,等他走后,你走到那台机器前试了 30 次。你瞧……你赚到的钱比你开始时的还多!就在这时你意识到……“庄家确实在作弊!”(谁能想到呢,对吧?)现在,你是个胆大无畏的人,决定用数学和统计学来反击这种不公。
于是你开始构思如何才能赢更多的钱。
让我们假设我们有 N 次尝试(也就是钱的数额),而我们面前有 k 个选项(也就是老虎机的数量)。我们可以假设这 k 个选项中的每一个都有一个期望回报,也就是一个均值,围绕它存在一定的方差,但如果玩足够多次,它平均返还的东西就会收敛到它的真实值。(这就是大数定律:只要尝试足够多,这个黑箱就会给出它的平均输出。)
那么让我们假设一台老虎机的这个完美的、实际的价值可以表示为 q∗(a)。但问题在于,每当我们使用它时,它并不会返回完美的 q∗(a)(因为如果它会,那每个人都会把每台老虎机玩一次,找出哪台给的钱最多,然后只用那一台!所以相反,它们遵循一个带有某种方差和均值的分布)。因此,我们改为维护一个运行中的估计值 Qₙ(a),也就是我们到目前为止从该机器获得的奖励的平均值。
我们可以把真实值写成
也就是说,在采取动作 Aₜ = a 的条件下奖励 Rₜ 的期望(在这里,一个动作就是你选择某一台特定的老虎机)。
如果这是你第一次看到 𝔼[X],它本质上是一个分布的加权平均值。用更简单的话说,它可以写成
也就是说,把每个可能的 x 的取值乘以该 x 出现的概率,再全部相加。(如果现在是均匀分布,那么任意给定取值出现的概率就是 (1)/(取值个数),所以对于像掷骰子这样的期望值来说,它会是
注意,你永远不可能真的掷出 3.5!期望值并不是“最可能的结果”,而是你把骰子掷非常多次后得到的平均值,这正好就是前面提到的大数定律。)
如果你是第一次看到 𝔼[X | Y] 这个记号,它来自条件概率。P(A | B) 的意思是:在 B 发生的条件下,A 也发生的概率是多少?我喜欢用维恩图来想象这件事。一旦我们知道 B 发生了,B 就成了我们的整个世界,然后我们问,这个世界中有多少同时也是 A:

条件期望 𝔼[X | Y = y] 用的是同样的思路,但它给出的不是概率,而是一个平均值:在 y 发生的条件下,X 的平均值是多少?它其实就是上面的加权平均,只是把条件概率当作权重:𝔼[X | Y = y] = Σₓ x P(X = x | Y = y)。所以 𝔼[Rₜ | Aₜ = a] 读作“在我们选择了机器 a 的条件下,平均奖励是多少”。
对上述想法的一个进一步解释,来自引入后验、先验、似然和边缘概率这些概念。虽然这些词听起来极其复杂,但其实很容易理解。我们可以把贝叶斯定理写成
这里的 P(A | B) 是后验概率,本质上就是我们想要弄清楚的东西(我们在看到 B 之后 对 A 的信念)。P(A) 是先验概率,即我们在看到任何东西之前对 A 已经持有的信念。P(B | A) 是似然,即如果 A 为真,证据 B 出现的可能性有多大。而 P(B) 被称为边缘概率(或证据),即 B 出现的总体概率。
我们可以把一台机器在被玩了 n-1 次之后的估计值写成
这可以化简(这样我们就不需要存储曾经收到的每一个奖励)。在 n 个奖励之后的估计值为
在第三行中,我们乘以并除以了 (n-1),这让我们看出 (1)/(n-1)Σᵢ₌₁ⁿ⁻1 Rᵢ 正是我们旧的估计值 Qₙ。所以现在对于每台机器,我们只需要记住两个数字:当前的估计值 Qₙ 和计数 n。
这是许多机器学习中常见的技巧,你会在很多论文中看到它。事实上,它如此常见,以至于他们往往会跳过这个具体的推导过程。
总而言之,我们可以简单地通过以下方式估计任何老虎机的期望值
这里的步长为 1/n。
你用这 3 台机器试试,找出给你最高期望奖励的那一台,赚一大笔钱,然后高高兴兴地回家。第二天你回来,却发现赌场已经察觉了你在做什么。所以现在他们不再有 3 台老虎机,而是有 10 台!!!机器。

你之前的方法再也行不通了,因为你光是试图找到最优机器就会浪费大量尝试。
于是你掏出随身携带的笔记本,开始思考:
“假如我假设每台机器的平均回报都是 0,然后我试一台机器,并保留这个估计值。现在它就是我当前回报最高的机器,所以我会一直利用它,而在随机的时间点(比如 ε 比例的时间),我会去探索,随机试一台机器。如果它给我的回报高于我当前对当前机器的估计,我就转而坚持用它!”
哇,你真是个疯狂的天才。你把公式这样写下来(疯狂的天才出于某种原因总得让算法能跑起来):
注:这种方法正式名称叫 ε-贪心 动作选择,这里的困境在于利用(只用迄今为止平均回报最高的那台机器)与探索(尝试其他可能平均回报更高的机器)之间的权衡。我们通过调整 ε 的值来找出最适合自己的方案!
import numpy as np

rng = np.random.default_rng()

def bandit(q_true, action):
    # the slot machine: pays out a noisy reward around its (hidden) true value
    return rng.normal(loc=q_true[action], scale=1.0)

def epsilon_greedy(q_true, epsilon=0.1, steps=1000, initial_value=0.0):
    k = len(q_true)
    Q = np.full(k, initial_value)  # our estimate of each machine
    N = np.zeros(k)                # how many times we have played each machine
    rewards = np.zeros(steps)

    for t in range(steps):
        if rng.random() < epsilon:
            A = rng.integers(k)                           # explore
        else:
            A = rng.choice(np.flatnonzero(Q == Q.max()))  # exploit, breaking ties randomly
        R = bandit(q_true, A)
        N[A] += 1
        Q[A] += (1 / N[A]) * (R - Q[A])
        rewards[t] = R

    return Q, rewards

q_true = rng.normal(0, 1, size=10)  # 10 machines, each with a hidden true value
Q, rewards = epsilon_greedy(q_true, epsilon=0.1)
print("best machine:", q_true.argmax(), "| our best guess:", Q.argmax())
print("average reward:", rewards.mean())
好了好了,我知道你很想跳过上面那段代码,但还是瞄一眼吧。它相当简单,而且对我们的理解至关重要。
你这样做了一段时间,但并没有得到你想要的回报,主要是因为你一直只利用少数几台机器,而还有很多机器可能带来高得多的奖励。
于是你又开动脑筋。
“如果我假设每台机器给我的初始奖励不是 0,而是 10 呢?这样我就会更有动力去把每台机器都至少试一次!”
你又做到了!你到底是怎么做到的?
所以现在你修改算法,把 Q(a) ← 10(在上面的代码中,就是 initial_value=10)。
形式上,这被称为乐观初始值,其思路是迫使智能体至少把每个选项都探索一次!但它有一个问题,我们很快就会看到……
你这样做了一段时间,但结果再次让你心烦意乱。因为随着你不断玩下去,你也在记录自己赚了多少钱、亏了多少钱,而那张图并不像你希望的那样好看。显而易见的答案是:即使你试过了所有机器,最终你仍然会卡在少数几台机器上,因为你没有探索的动力。
于是你意识到,
“如果我把它们的初始值设得很高,把它们全都试一遍,同时还记录每台机器我试了多少次呢?这样一来,如果我在某台特定机器上利用得太久了,我就可以看看哪些机器我试得最少,然后去玩它们。由于这些是我用得最少的机器,它们的 Q 估计最有可能是不准确的。”
哎呀呀呀,你莫非是 Edward O. Thorp?你简直火力全开!!!
你把选择动作 Aₜ 的方式修改为
如果上面的公式让你觉得跨度太大,让我来简化一下。argmaxₐ 本质上就是“选出那个能让括号里数值最大的 a(即自变量)”。这里的括号里是我们的估计值加上一个探索奖励,所以它并不只是当下期望回报最高的那个。ln 是以自然常数 e ≈ 2.718 为底的对数(欧拉数),点这里了解更多!)。我喜欢这样来记对数。想象我们以 10 为底取对数,可以写成 log₁₀(1000) = 3,也就是说,10 需要自乘多少次才能得到 1000?或者,10^x = 1000。显然我挑了一个非常简单的数字,因为它能说明这个思路。我们使用对数的主要原因是它能让数值的缩放表现好得多:它持续增长,但越来越慢。自己对比一下下面两张图,就能明白我的意思!
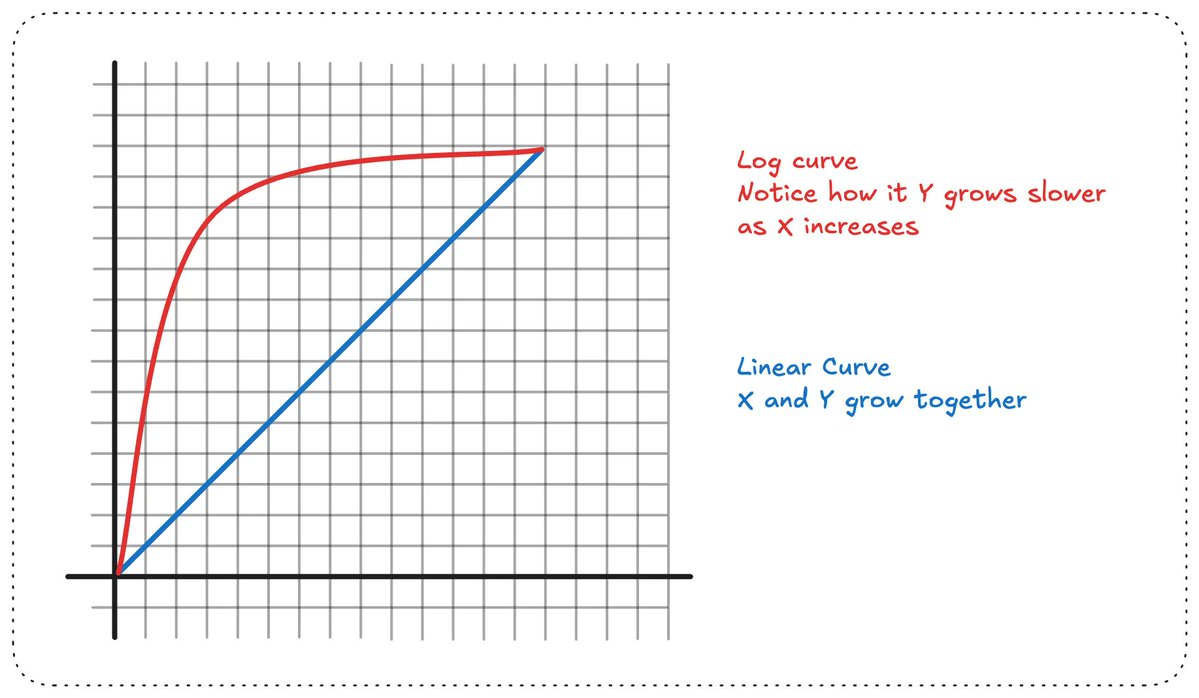
拉了 1000 次之后,t 是 1000,但 ln t 只有大约 6.9。所以探索奖励会不断推动我们去重新光顾那些被冷落的老虎机,但它增长得绝不会快到淹没我们在 Qₜ(a) 中真正学到的东西。
Nₜ(a) 是你拉动某台特定老虎机拉杆的次数,t 是到目前为止的总拉动次数(而 ln t 是它的自然对数,所以奖励随时间缓慢增长),c > 0 则控制你对探索的重视程度。这会给那些你尝试得最少的老虎机更大的奖励,而一台你完全没试过的老虎机(Nₜ(a) = 0)会被当作最佳选择!(好了好了,你是个聪明人,花一分钟想想,就会发现这比看起来简单多了!)
注意:这是上置信界(UCB)动作选择。平方根那一项是估计中的“不确定性”。你玩某台老虎机越多,它就越小(Nₜ(a) 增大),而对于你忽略的老虎机,它会缓慢增大(因为 ln t 一直在增长)。
你采用了这个方法,赚到了一大笔离谱的钱,然后回家了。
第二天你又来了,再次来榨干这些输家。
你开始玩……过了一会儿你意识到……所有机器的均值都在随时间不断变化。你震惊了!
“这些家伙在改变机器的期望回报?”
你猜怎么着,赌场又一次识破了你的把戏,他们在一夜之间把机器改成了具有移动的期望均值。
你陷入了沮丧的境地,你失去了信心、时间和金钱。你想放弃。就在这时,你想起了Papa John,意识到他绝不会放弃做披萨来养家糊口。于是你……又一次拿出你的笔记本,要教这个赌场知道,你比他们更强。
你看着你的公式,意识到致命的缺陷在于步长乘数。用1/n时,随着n增大,每个新奖励的重要性越来越低,这只有在数值收敛到某一个值时才合理。但现在这些数值永远不会收敛到某一个值。所以你决定把它换成一个常数α,这样近期的奖励总是比旧的奖励更重要!
这个小小的改动改变了一切。现在你又回到了正轨,赢回了更多!
注:在强化学习术语中,真实值随时间不断变化的问题被称为非平稳问题。而整个老虎机设定——只有一种情境,你只是不断选择一个动作——被称为非关联问题,或者k臂老虎机问题。
赌场已经受够了你和你的数学!经理派打手朝你冲来,要把你赶出去!你朝后门跑去……
……就在你以为自己已经逃离苦海、成为自由人的时候,你意识到……后门通向一座迷宫,只有两个尽头:一个危险的火焰坑,或者Saintsbury的大门(这正是我们想要的!)。我们的英雄再次陷入危机。
就在你快要绝望的时候,你发现入口处的墙上钉着什么东西……一张迷宫地图!它标出了每一条走廊、每一个死胡同、每个转弯通向何处,以及火坑和圣茨伯里大门的位置。(真方便……简直太方便了。但你现在也没资格抱怨。)
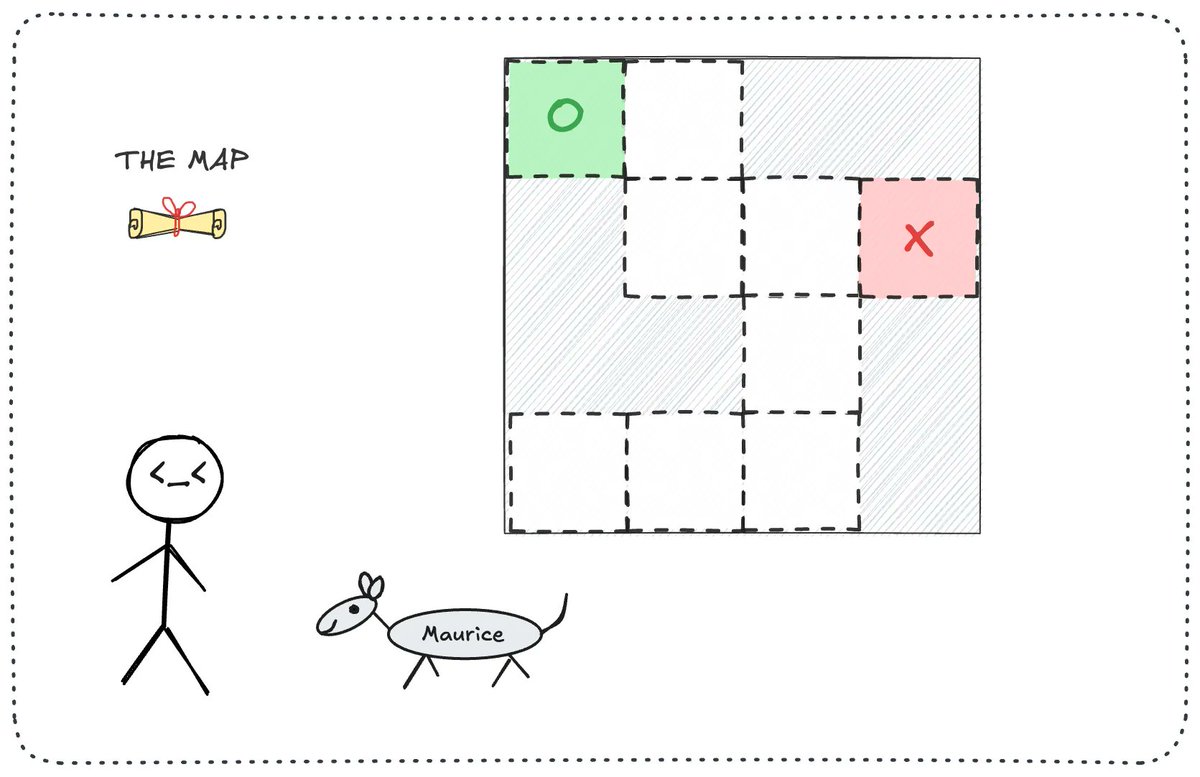
我们的主人公经历了这么多麻烦,已经精疲力竭,根本没法徒手解开这座复杂的迷宫。(这座迷宫在我们旁观者看来很简单,但实际上它复杂到根本不可能在短短几秒内解开!)
这时,你掏出了你可靠的科幻机器人伙伴——莫里斯!现在你必须写一个算法来运行莫里斯,这样莫里斯就能替你找到圣茨伯里的大门,让你逃出这座迷宫!
好了,为莫里斯设计算法将会是一项艰巨的任务,所以你先从拆解变量开始。
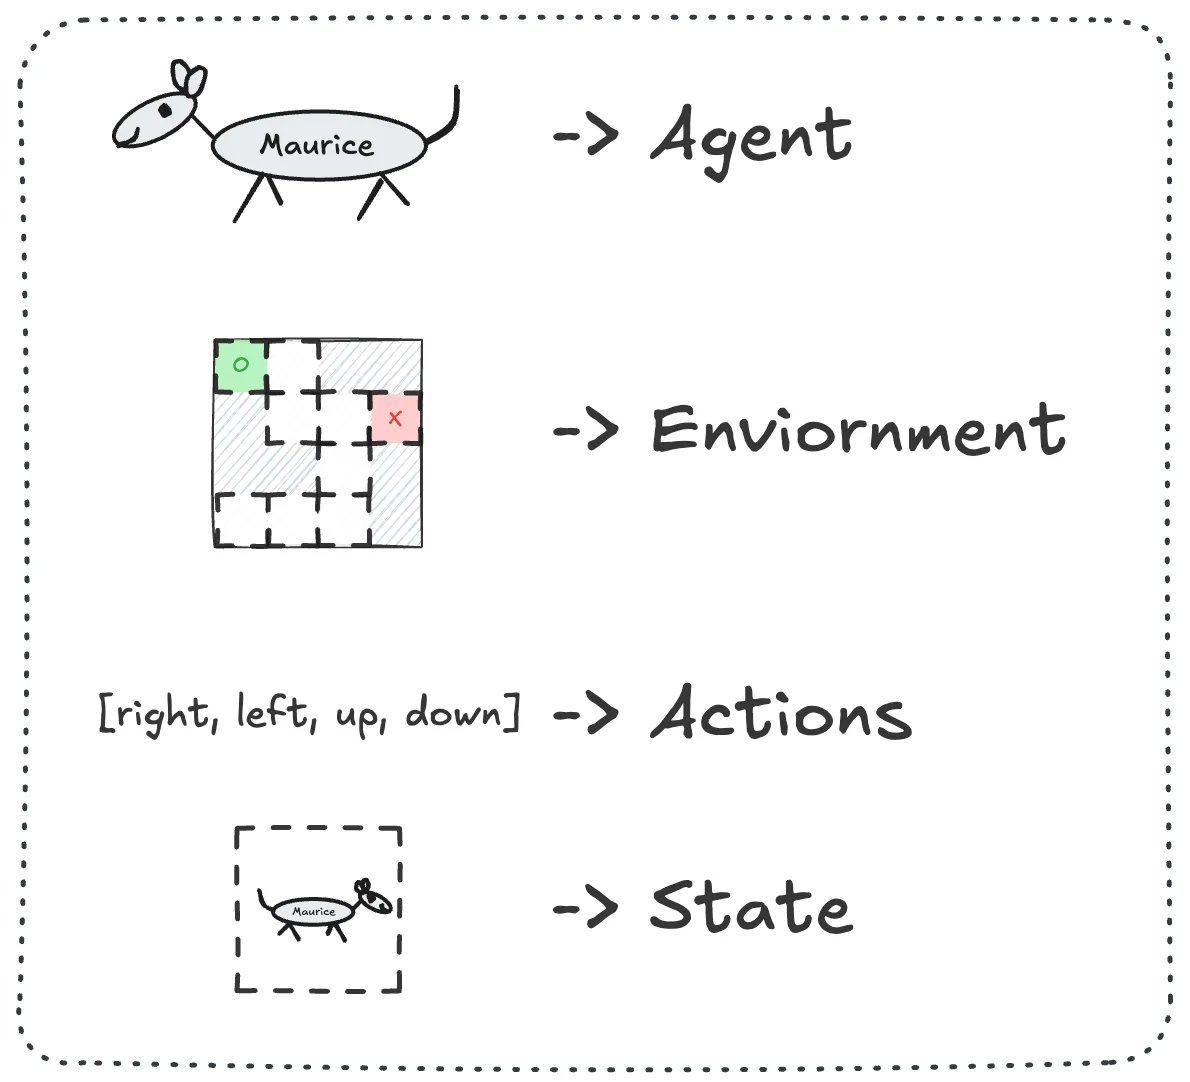
莫里斯是你的智能体,它与环境交互,而它在环境中所处的位置就是它当前的状态。莫里斯可以采取动作(上、下、左、右移动),我们还希望给莫里斯一个奖励,如果它能完成任务、把我们从这困境中救出来的话。
我们可以用下面这样一张简单的图来表达上述想法
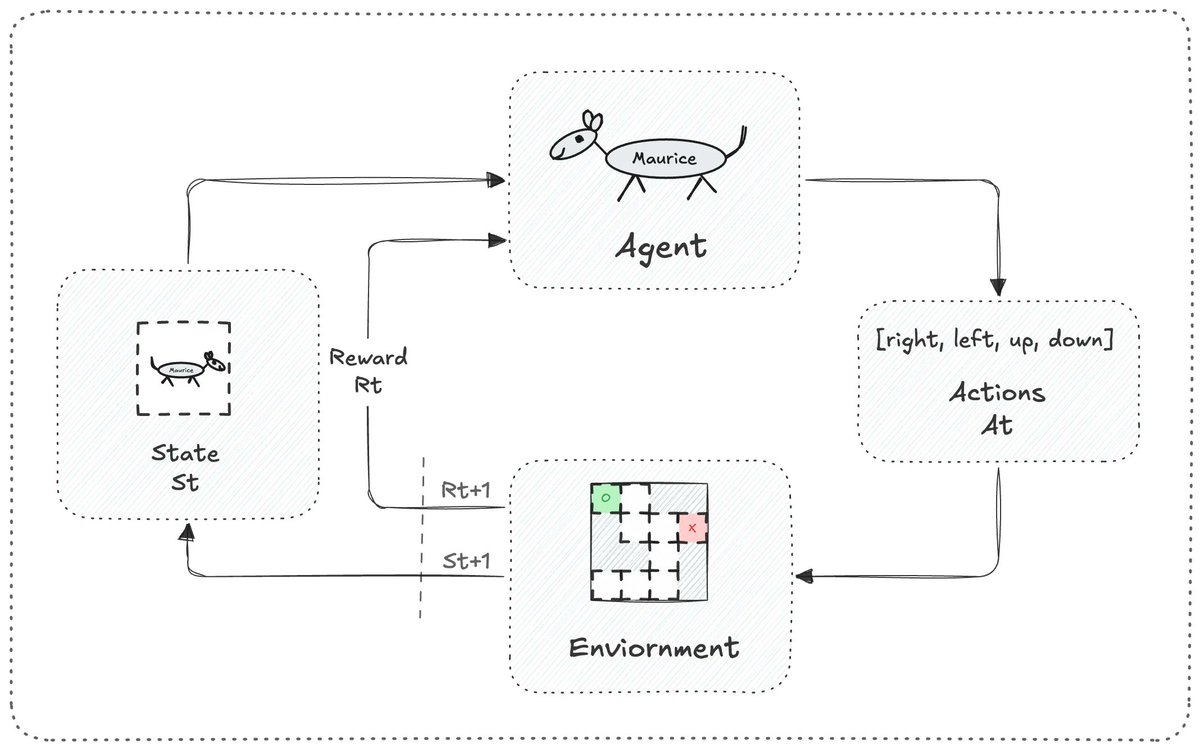
我们也可以这样推理:我们从状态 S₀ 开始(就像站在迷宫入口处),采取动作 A₀(比如向前移动),并因此获得奖励 R₁(在这种情况下奖励为 0,因为我们并没有逃出去!),然后到达状态 S₁(下一格)。从 S₁ 我们采取动作 A₁,获得奖励 R₂,如此继续……直到我们到达终点(终止状态,在我们的情况中,要么是在火坑中迎来末日,要么是通过圣茨伯里的大门逃出生天):
(注意,在时刻 t 采取动作所获得的奖励被称为 Rₜ₊₁,因为它与下一个状态 Sₜ₊₁ 一同到来。)
给定我们处于状态 s 并采取了动作 a,最终到达状态 s' 并获得奖励 r 的概率,可以用数学方式写成
别急别急,这并不新鲜,我们在开头就已经见过条件概率了。这本质上是在说:给定右侧条件成立(我们处于某个状态且采取了某个动作),左侧那一对(我们将进入的状态以及我们将因此获得的奖励)的概率是多少!
而这正是地图所提供给我们的!对于每一个状态和每一个动作,我们都能读出莫里斯最终会到哪里以及他会得到什么奖励。(在一个简单的迷宫里,每一步都会恰好把你带到唯一一个下一格,所以对该格来说 p 就是 1,对其他所有格则是 0。我们把它写成概率的形式,是为了让它也能适用于更复杂的世界,比如一个湿滑的地面有时会把你送到别的地方。)
注意,p 只取决于莫里斯现在在哪里以及他现在做了什么,而不取决于把他带到那里的整条路径。这被称为马尔可夫性质,而这样建立起来的问题(状态、动作、奖励和 p)被称为马尔可夫决策过程(MDP)。
暂时先接受这个假设,但后面我们会进一步展开讲 MDP,展示它们在大多数场景中如何运作,以及为什么它们是强化学习的基石。
当你开始把问题形式化时,你最先意识到的事情之一是:奖励是简单的部分。到达圣茨伯里的城门得到 +1,掉进火坑得到 -1,而其他每一步都得到 0。但这还不够!当莫里斯站在迷宫中间的某条走廊里时,那里的奖励是 0,这完全无法告诉他,自己是离自由只有一步之遥,还是离火坑只有一步之遥(原因是……我们在迷宫里!每条走廊看起来都一模一样!)。
注意,我们告诉莫里斯我们想要什么的唯一方式就是通过奖励。这个理念是强化学习的核心,被称为奖励假设:所有目标都可以描述为期望累积奖励的最大化。奖励告诉智能体我们想要达成什么,而不是如何达成。(我们从不会告诉莫里斯“在第三条走廊左转”,我们只是因为他逃出去而奖励他。)
莫里斯需要的不是每个状态的奖励,而是每个状态在长期来看有多好,也就是从那里开始他能期望收集到多少奖励。我们称之为一个状态的价值。奖励是迷宫给出的;价值是莫里斯必须自己弄清楚的。
如果这感觉信息量太大,让我们放慢一点。倒推来看:如果我们逃出去了,那就给了我们一个奖励。我们当前的问题是我们不知道从任何给定状态出发离获得奖励有多近,所以我们需要价值这个概念。例如,大门前那一格的价值显然比它前面 5 格的价值要高(等我们稍后加入一个叫做折扣的小技巧之后——它让更远的奖励算得更少)。而火坑前那一格的价值比那些让我们更接近大门的格子的价值要低。
对你有利的东西是地图。既然我们知道整个迷宫,莫里斯不需要迈出一步就能算出这些价值。他可以直接坐在这里思考。(另外我忘了告诉你,但他基本上是不死的,因为每次他死掉你都可以用你的召唤器小装置把他重新生成出来,不过我们还是别去测试这个了。)
于是你想,好吧,也许我可以为每个状态初始化一个价值,然后用地图不断更新每个状态让我离最终目标有多近。
(哇,这句话真难说出口,让我们把它拆解一下。)
与之前那个我们立刻获得奖励的问题不同,这里我们是在一段时间之后才获得奖励,所以我们可以把一次运行中的所有奖励都记录下来,作为
(从时刻 t 起,直到本次运行在时刻 T 结束,你按照 Maurice 当前所采用的行动方式所能收集到的总奖励。我们称之为回报,稍后我们会讨论最优的行动方式。)
但上述做法的问题在于,它可能会爆炸(也就是说,在数值上变得难以处理,因为对于大型迷宫,这个和可能会变得极其巨大,甚至如果任务永不结束,它还会变成无穷大)。另一个问题是,智能体会过度地着眼于未来,无论某个奖励离得多远,都会对它一视同仁(这可能会导致 Maurice 四处游荡去收集所有奖励,而我们希望他做的是尽快把我们带出去)。所以我们可以做的是引入一个指数加权值 γ(其中 0 ≤ γ ≤ 1),称为折扣因子:
现在正是引入两个小概念的好时机:分幕式任务与持续性任务。我们眼下处理的这个例子属于分幕式,也就是说它终究会结束。但在现实生活中,有许多场景中任务并不会结束。比如,设想一个恒温器试图让房间温度保持恒定。实际上它永远不会真正完成。你可能会问,为什么我们需要讨论分幕式任务与持续性任务的区别。主要原因在于,两者背后的数学差异很大。比如,看上面的方程。它看起来很像一个等比数列(可在此处了解更多),而无穷等比数列的和与有限等比数列的和差别很大。在分幕式任务中,求和到 T 就停止,所以它总是有限的。在持续性任务中,它永不停止,如果没有 γ,它可能会发散到无穷大。有趣的是,当 0 ≤ γ < 1 时,Σₖ₌₀^∞ γᵏ = (1)/(1-γ),是一个常数。所以如果每个奖励至多为 Rₘₐₓ,那么回报永远不会大于 fracRₘₐₓ1-γ,无论任务运行多久都是有限的!(额外的好处是,如果你给每个奖励都加上同一个常数 c,那么每个状态的价值都只是平移了相同的 (c)/(1-γ),所以真正重要的是奖励之间的相对差异,而不是它们的实际数值。)这部分比我原本希望的要复杂一些,但随着我们继续深入、做更多的强化学习,我会在大家对这个概念越来越熟悉的过程中尽量把它简化。
对于无限情形,γ 还有另一个好处:它本质上让任务从任何状态来看都变成了伪分幕式的。当 n 足够大时,γⁿ 会非常接近零,因此那之后的每个奖励几乎都不起作用。(一个实用的经验法则:智能体实际上大约向前看 (1)/(1-γ) 步,例如 γ = 0.9 时大约是 10 步。)
这就是我们的折扣回报。现在,利用这个折扣回报,我们可以确定任何当前状态有多大的价值,作为
这里的 π 是莫里斯的策略,也就是他的行为方式:π(a | s) 是莫里斯在状态 s 下选择动作 a 的概率。一个状态有多大价值,取决于莫里斯从那里开始如何行动,这就是为什么 v 带着那个小小的 π。
你可以把策略想象成莫里斯的大脑:它接收状态,并告诉他该做什么。它可以是确定性的,写作 a = π(s),即在给定状态下总是选择同一个动作。也可以是随机性的,写作 π(a | s),为每个动作给出一个概率(70% 的时候向右,20% 的时候向左,等等)。

找到最好的策略,也就是收集最多奖励的那个策略(我们称之为 π∗),正是强化学习的全部目标。实现这一目标有两大类方法:
- 基于策略的方法: 直接教莫里斯在每个状态下该采取哪个动作。
- 基于价值的方法: 教莫里斯每个状态有多大价值,然后让他采取能通向最有价值状态的动作。
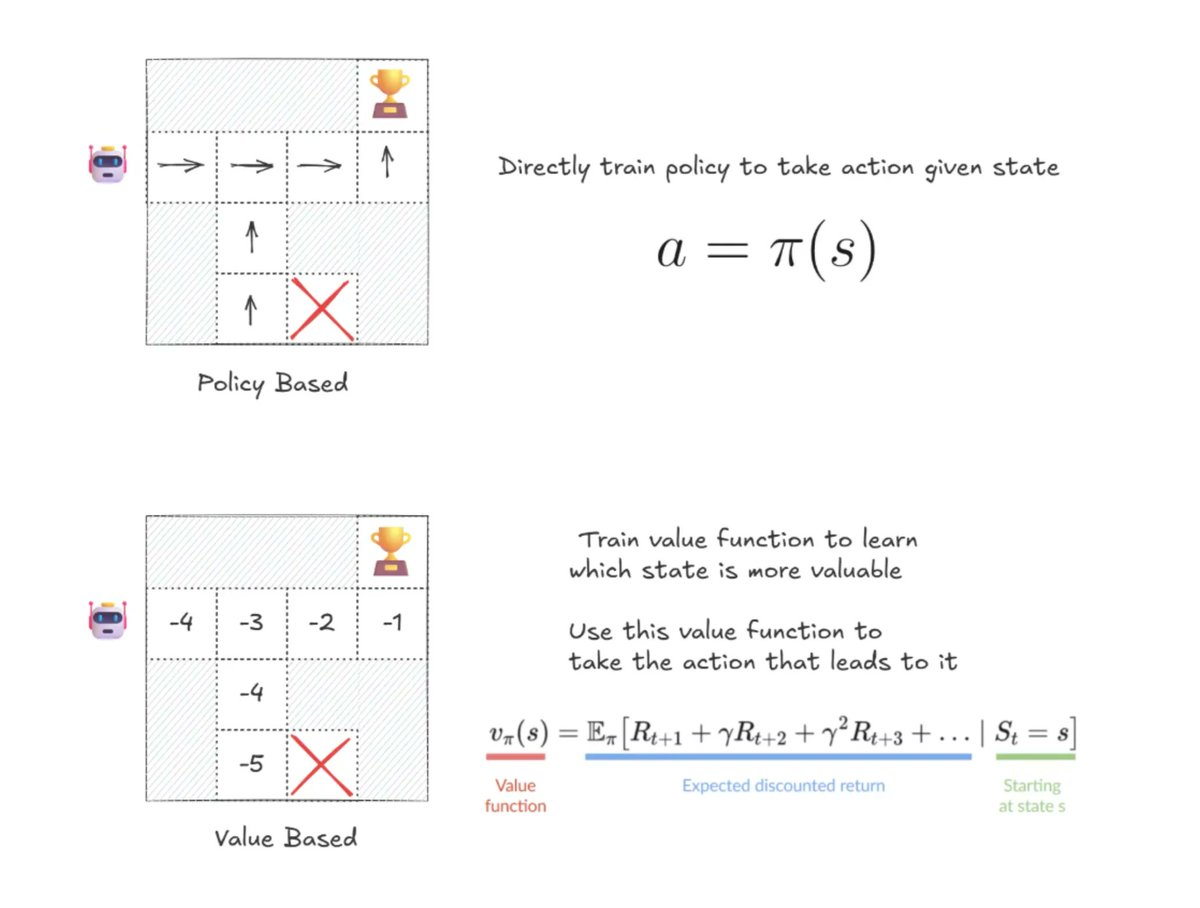
本文所做的一切都是基于价值的。我们会在本系列的后续文章中遇到基于策略的方法。
上面的解释在逻辑上说得通,但我们还是从数学上把它拆解一下。当我们写 𝔼_π[X] 时,我们本质上是在“mean”(哈哈,双关)莫里斯按照 π 行动时随机变量 X 的期望值。(简短说明:一个随机变量是概率论中的概念,和计算机科学中的变量不是一回事。它是一个取值取决于随机结果的量,比如骰子掷出的点数。点这里了解更多。)我们可以把它拆解如下。
回报 Gₜ 是一个随机变量:每次 Maurice 从 s 出发,都可能走上不同的路径,收集到不同的总奖励。哪些路径可能出现取决于两件事:Maurice 的选择(π)以及迷宫如何响应(p)。𝔼 下面那个小小的 π 是在提醒我们,用来求平均的概率来自遵循 π 的过程。所以,用开头那个加权平均的定义:
也就是说,对每一个可能的回报 g,按 Maurice 从 s 出发并遵循 π 时得到它的可能性加权。一个小例子:假设从格子 s 出发,Maurice 有一半时间向左走(π(left | s) = 0.5),这总会到达大门,回报为 +1;另一半时间向右走,这总会掉进火坑,回报为 -1。那么 v_π(s) = 0.5 · (+1) + 0.5 · (-1) = 0。把他的策略改成 90% 的时间向左走,同一个格子现在价值就是 0.9 - 0.1 = 0.8。同一个格子,同一个迷宫,不同的策略,不同的价值。这就是为什么 v 需要它的 π!(在这个情况下,我们似乎显然应该总是向左走,但这只是因为场景很简单。当我们深入下去、走得更远时,它就不再那么显然了)
现在,上述表述的问题在于我们没法真正拿它来用,所以必须把它拆解成我们能理解的东西。
我们可以把它拆解成下面这样
让我们一步步来看。
(1) → (2)。 回报具有递归结构。把第一个奖励从求和中提出来,剩下的就只是下一步的回报,再打一次折扣:
所以“从今往后的全部” = “下一个奖励” + γ × “从下一步起的全部”。
(2) → (3)。 期望是对一步之内发生的所有随机事件取平均。从状态 s 出发,会发生两件随机的事:
- Maurice 以概率 π(a | s)(他的策略)选择一个动作 a。
- 迷宫以概率 p(s', r | s, a) 回应一个下一状态 s' 和一个奖励 r。
所以我们要对两者都取平均:我们用概率 π(a | s) p(s', r | s, a) 对每一个可能的 (a, s', r) 组合加权,而对每一个组合,我们得到的是奖励 r 加上 γ 乘以从所落之处出发的期望回报,𝔼_π[Gₜ₊₁ | Sₜ₊₁ = s']。(为什么我们可以只以 s' 为条件,而忘掉 s 和 a?还是马尔可夫性质:一旦你知道 Maurice 现在在哪,他是怎么到那儿的并不会改变接下来发生的事。)
从 (2) 到 (3) 可能感觉像一大步跳跃,让我们把它变简单。我们只需要一个工具,即全期望定律:要找一个平均值,你可以把世界分成若干情况,求出每种情况内的平均值,然后用每种情况发生的可能性对这些平均值取加权平均:
(例子:一个班级的平均身高 =(女生比例 × 女生平均身高)+(男生比例 × 男生平均身高)。)
再来过一遍。把它想成“平均值的平均值,按每种情况的可能性加权”。
让我们回到赌场一会儿。假设每天晚上你以 0.7 的概率玩机器 A,以 0.3 的概率玩机器 B。机器 A 平均赔付 2,机器 B 平均赔付 10。那么一个晚上你平均能赢多少?
注意我们不需要什么:不需要列出每一种可能赔付及其概率的完整清单。我们只需要每种情况内部的平均值,以及每种情况发生的可能性。这就是全部诀窍。
为什么这是对的? 从最初期望值的定义出发,𝔼[X] = Σₓ x P(X = x):
第三行只是把维恩图公式 P(A | B) = (P(A ∩ B))/(P(B)) 乘开:P(A ∩ B) = P(B) P(A | B)。
如果我们已经知道某些东西,比如 Y(对我们来说,Sₜ = s),什么都不会改变。每个概率和期望值都只是附加一个“| Y”,这就得到了上面写出的版本。
一个注意事项: 情况 z 必须覆盖每一种可能性,并且其中任意两种不能同时发生(每天晚上要么是机器 A 要么是机器 B,绝不会两者都是,也绝不会两者都不是)。否则权重加起来不等于 1,平均值就会算错。
在我们的迷宫中,“我们已经知道的东西”是 Sₜ = s,我们做了两次拆分:- 首先按 Maurice 的动作拆分:情形是各个动作 a,以 π(a | s) 加权,- 然后按迷宫的回应拆分:情形是各个 (s', r) 对,以 p(s', r | s, a) 加权。
我们应用它两次,先按动作拆分,再按迷宫的行为拆分:
- (2) → (2a): 按 Maurice 选择哪个动作拆分。每种情形的概率是 π(a | s)。
- (2a) → (2b): 在每个动作内部,再按迷宫把他送到哪里、给出什么奖励拆分。每种情形的概率是 p(s', r | s, a)。
- (2b) → (2c): 在期望内部,我们现在知道 Rₜ₊₁ = r,所以它不再是随机的,直接作为 r 提出来(已知数的平均值就是它本身)。γ 也提了出来,因为一个常数乘以某物的期望等于该常数乘以其期望。
- (2c) → (3): 马尔可夫性质。未来的回报 Gₜ₊₁ 只取决于 Maurice 在 t+1 时刻所处的位置,所以在 s' 之外还知道 s、a 和 r 并不能告诉我们任何新东西,我们可以把它们去掉。
(3) → (4)。 看 𝔼π[Gₜ₊₁ | Sₜ₊₁ = s']。它是“从状态 s' 出发并遵循 π 时的期望回报”,这正是 vπ(s') 的定义!所以我们把它替换进去。(我们还将 Σ(s')Σᵣ 写成 Σ(s',r) 以省些笔墨。)
这就是神奇之处:一个状态的价值现在被表示为即时奖励加上紧随其后的那些状态的折扣价值。我们不再需要对无限的未来求和,只需向前看一步。
这就是广为人知的 v_π(状态价值函数)的 贝尔曼方程。
我们有了地图,也有了贝尔曼方程,但仍然需要一个算法来实际计算这些价值,对吧?我们该怎么做呢?
这一类方法——利用世界的完美模型(我们的地图,即 p),通过反复应用贝尔曼方程来计算价值——被称为 动态规划(Dynamic Programming, DP)。注意,Maurice 在这里实际上从未走过迷宫,一切都是在用地图思考完成的。这也被称为 规划(planning)。
第一步是我们所说的 策略评估:给定一个策略 π,计算 v_π。诀窍在于把贝尔曼方程转化为更新规则。先对 V(s) 做任意初始猜测,然后遍历所有状态,用当前猜测值计算贝尔曼方程右端,替换每个 V(s)。不断重复,直到价值不再变化。
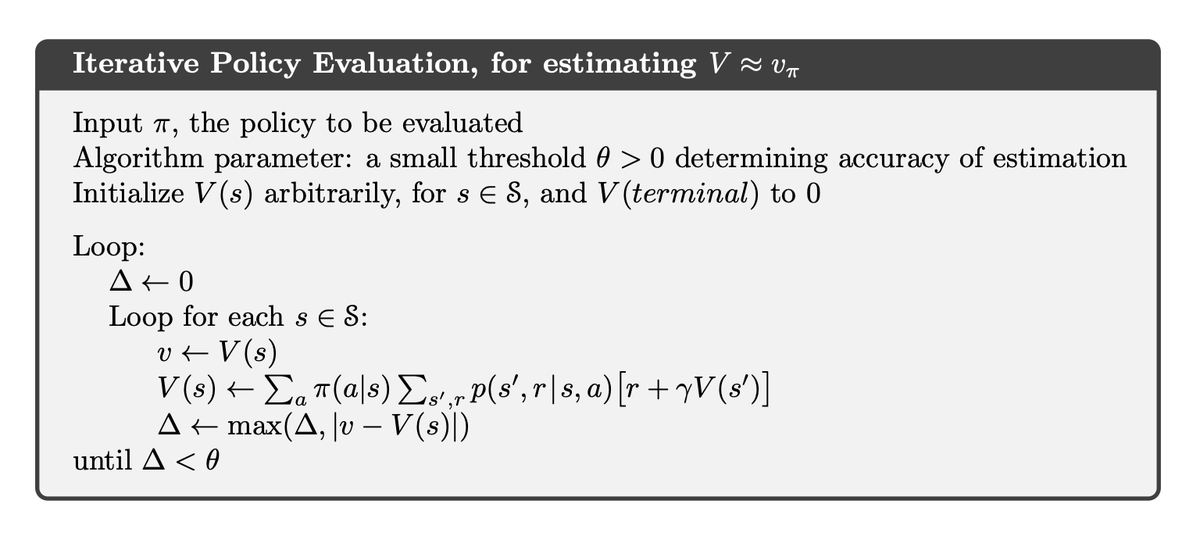
在代码中,大致是这样的。为了保持简洁,我们使用书中经典的 4×4 网格:出口是左上角和右下角,每走一步代价为 -1,Maurice 遵循随机策略(每个方向概率为 0.25)。
import numpy as np

GRID_SIZE = 4
N_STATES = GRID_SIZE * GRID_SIZE
TERMINALS = {0, 15}  # the two exits: top-left and bottom-right corners
ACTIONS = {'up': (-1, 0), 'down': (1, 0), 'left': (0, -1), 'right': (0, 1)}
GAMMA = 1.0          # no discounting needed, every step already costs -1

def next_state(state, action):
    row, col = divmod(state, GRID_SIZE)
    d_row, d_col = ACTIONS[action]
    # walking into a wall leaves you where you are
    row = min(max(row + d_row, 0), GRID_SIZE - 1)
    col = min(max(col + d_col, 0), GRID_SIZE - 1)
    return row * GRID_SIZE + col

def reward(state, action):
    return -1  # every step hurts, so the shortest way out wins

def policy_evaluation(policy, theta=1e-4):
    V = np.zeros(N_STATES)  # V(terminal) stays 0 forever
    while True:
        delta = 0
        for s in range(N_STATES):
            if s in TERMINALS:
                continue
            v = V[s]
            # the map is deterministic, so Σ_{s',r} p(s',r|s,a) collapses to a single next state
            V[s] = sum(prob * (reward(s, a) + GAMMA * V[next_state(s, a)])
                       for a, prob in policy[s].items())
            delta = max(delta, abs(v - V[s]))
        if delta < theta:
            return V

# the equiprobable random policy: every action with probability 0.25
random_policy = {s: {a: 0.25 for a in ACTIONS} for s in range(N_STATES)}

V = policy_evaluation(random_policy)
print(V.reshape(GRID_SIZE, GRID_SIZE).round(1))
每个数字表示“一个在周围随机游荡的莫里斯平均需要多少步才能从这里走出去”(取负值,因为每走一步都要付出 -1 的代价)。靠近出口的格子价值更高;离两个出口都远的格子价值最低。(这是书里的一个思路;我最初的代码就是按这个思路写的,后来我懒得改了。就我们当前的情况而言,你也可以把它当作零!)
这给了我们该策略下每个状态的价值,但现在我们需要让莫里斯跑起来,这样他才能找到这些价值并遵循它们。“遵循它们”意味着在每个状态下,莫里斯选择能带来最佳 r + \gamma V(s') 的动作(这被称为策略改进)。但一旦策略改变,它的价值也会改变,所以我们再次评估、再次改进,如此反复,直到策略不再变化。这被称为策略迭代:
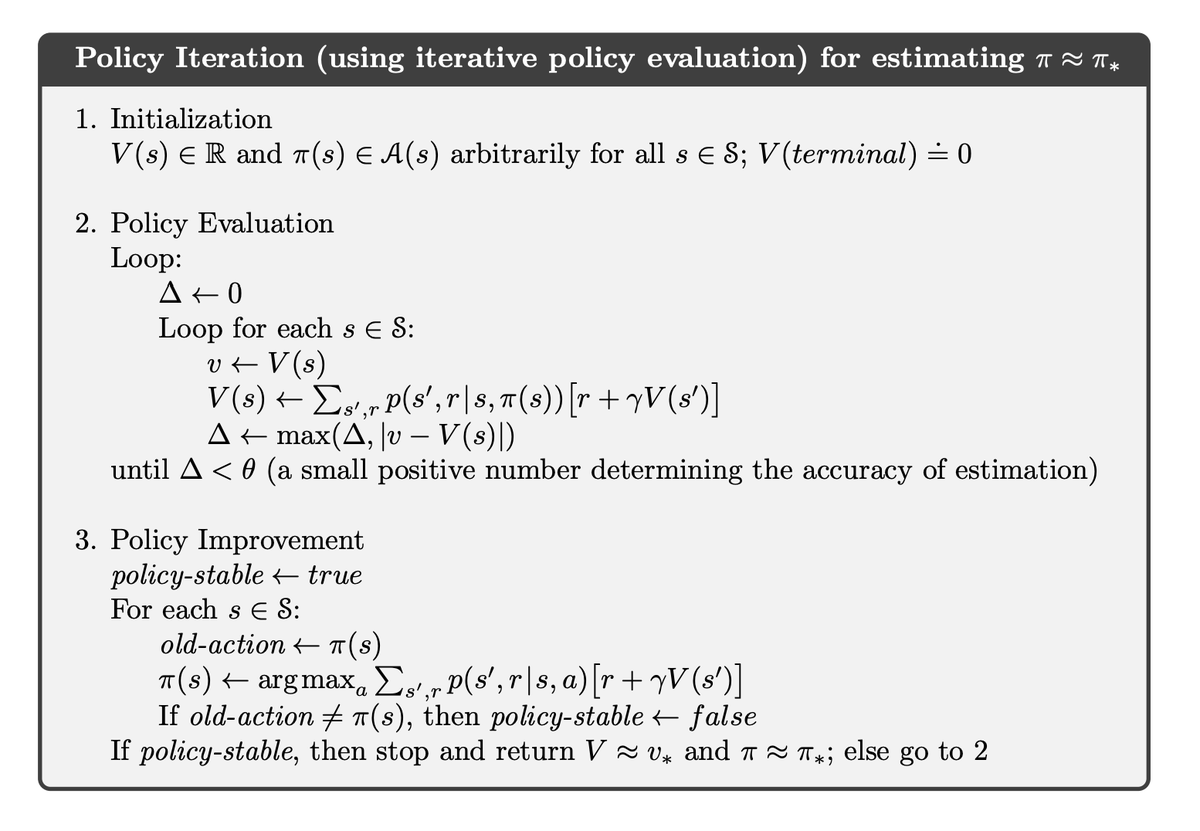
基于上面的代码,策略迭代不过是在 policy_evaluation 外面套一个循环:
def greedy_action(V, s):
    # the action with the best one-step lookahead: r + γ V(s')
    return max(ACTIONS, key=lambda a: reward(s, a) + GAMMA * V[next_state(s, a)])

def policy_iteration():
    policy = random_policy  # 1. Initialization: start with the random policy
    while True:
        V = policy_evaluation(policy)  # 2. Policy Evaluation
        # 3. Policy Improvement: in every state, put all the probability on the greedy action
        new_policy = {s: {greedy_action(V, s): 1.0} for s in range(N_STATES)}
        if new_policy == policy:  # policy-stable, we are done
            return V, policy
        policy = new_policy

ARROWS = {'up': '↑', 'down': '↓', 'left': '←', 'right': '→'}

def show(V, policy):
    print(V.reshape(GRID_SIZE, GRID_SIZE).round(1))
    for row in range(GRID_SIZE):
        print(' '.join('■' if s in TERMINALS else ARROWS[next(iter(policy[s]))]
                       for s in range(row * GRID_SIZE, (row + 1) * GRID_SIZE)))

V, policy = policy_iteration()
show(V, policy)
现在每个价值恰好等于到最近出口的步数的相反数,而箭头为 Maurice 指明了从每个格子出去的最短路径。
我们告诉 Maurice 必须遵循这个算法之后,就让他尽情行动了。
但我们意识到的问题是,Maurice 花的时间太长了!因为每一轮策略评估都会一遍又一遍地扫过整个迷宫,直到价值完全收敛,然后才把策略改进一点点。如果 Maurice 在每次扫描中直接使用最优动作的价值(最大值),而不是等待当前策略的价值收敛,那会好得多。这样一来,评估和改进就在一次扫描中同时完成了。这被称为价值迭代,我们可以这样实现它!
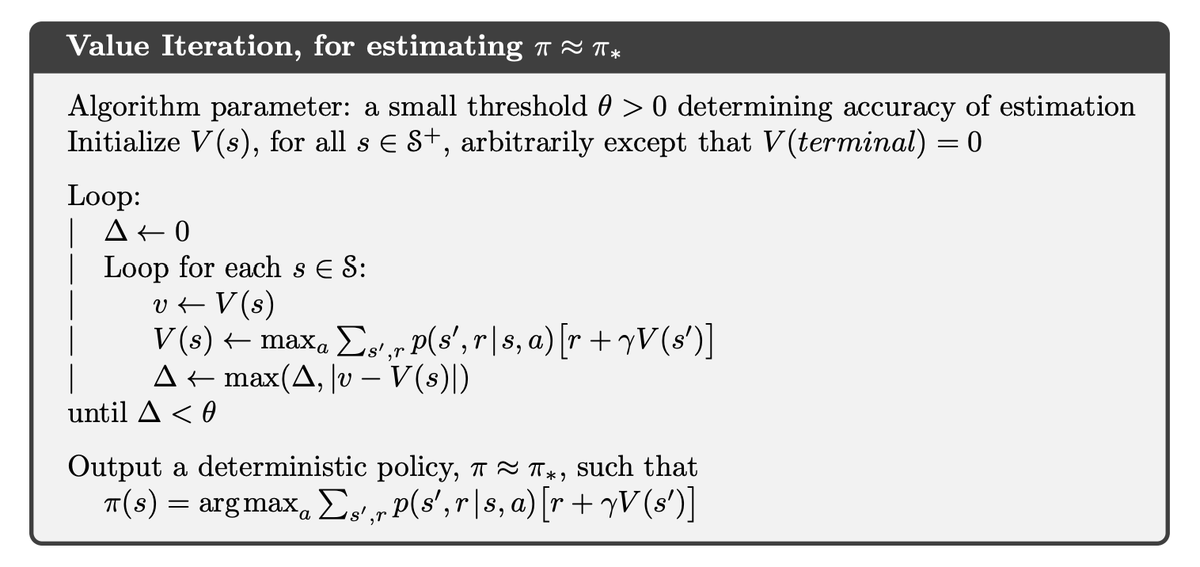
上述算法可以实现为
def value_iteration(theta=1e-4):
    V = np.zeros(N_STATES)
    while True:
        delta = 0
        for s in range(N_STATES):
            if s in TERMINALS:
                continue
            v = V[s]
            # the ONLY change from policy evaluation: max over actions instead of a π-weighted sum
            V[s] = max(reward(s, a) + GAMMA * V[next_state(s, a)] for a in ACTIONS)
            delta = max(delta, abs(v - V[s]))
        if delta < theta:
            break
    # output a deterministic policy: act greedily with respect to the final values
    policy = {s: {greedy_action(V, s): 1.0} for s in range(N_STATES)}
    return V, policy

V, policy = value_iteration()
show(V, policy)
把 policy_evaluation 和 value_iteration 放在一起对比,你会发现它们几乎是同一个函数。唯一的区别只有一行:
- 策略评估: 一个格子的新价值是各动作的平均值,按 Maurice 采取每个动作的可能性加权(Σₐ π(a | s) …)。
- 价值迭代: 一个格子的新价值是最优动作的价值(maxₐ …)。
这就是全部思路。价值迭代不再问“如果莫里斯继续按现在的方式行动,这个格子有多好?”,而是问“如果莫里斯从这里开始做最好的选择,这个格子有多好?”。每一轮扫描,好消息(离出口近)就像池塘里的涟漪一样,向外扩散一格,直到每个格子都知道自己到出口的最短距离。然后莫里斯只需跟着箭头走。我们得到的答案与策略迭代相同,而且完全不需要完整地评估一个策略。
你把这个新算法装进莫里斯体内,他表现得极为出色,仅用 5 次迭代就为你找到了最佳路径。现在你跟着它走,欢天喜地地跳着、蹦着,因为你赚了那么多钱,并且带着你的自由 ESCAPED!!!当你接近圣茨伯里的城门时,你看到了一个景象。一个让你震惊、让你恐惧得毛骨悚然的景象!!
“哦不,是经理!!”
“不,你这个傻瓜,我是经理的兄弟。约翰!”
“帕帕·约翰???”
“什么,不!别胡闹了。总之,如果你想出去,就必须回答我这个问题……”
他掏出一张皱巴巴的纸。那是他计算出的价值网格(格子从左到右、从上到下编号为 0 到 15,出口在 0 和 15):
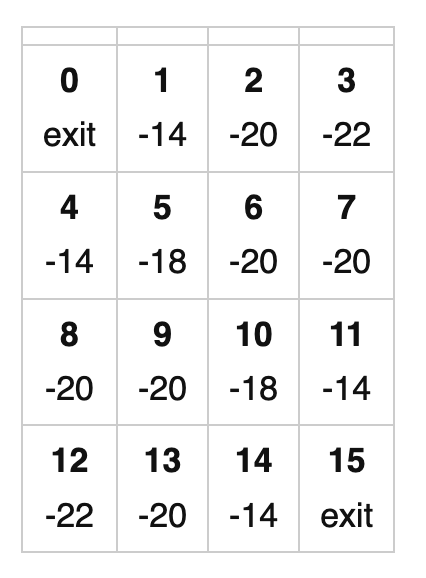
“假设莫里斯站在 11 号格子上。他没有四处乱走,而是刻意地走一步,向下,然后才又像个傻瓜一样随机乱走。那一步值多少?如果他在 7 号格子上向下走呢?”
哇,这问题可真够刁钻的,要我说的话相当令人费解。但我们的英雄毫不畏惧。你能行的,让我们仔细想想,我们知道些什么?
首先,纸上的数字是什么意思?每一个都是 v_π(s):如果莫里斯从那里开始随机乱走,这个格子值多少。但约翰问的稍有不同。他固定了第一步,只有在那之后,莫里斯才重新按照 π 行动。
那就照贝尔曼方程教我们的去做:向前看一步。走一步能拿到即时奖励,再加上落脚处的价值。地图是确定性的,且 γ = 1,所以:
- 方格 11,向下: 我们落到方格 15,也就是出口,价值为 0。所以这一步的价值是 -1 + 0 = -1。
- 方格 7,向下: 我们落到方格 11,价值为 -14。所以这一步的价值是 -1 + (-14) = -15。
“正确!”约翰说,明显有些恼火。
而你还没意识到,自己刚刚发现了一个新的量。在状态 s 下采取动作 a,之后遵循 π 的价值,叫做动作价值函数,记作 q_π(s, a):
我们的英雄再次获胜!你历经无数挑战,走出圣茨伯里的大门,却发现……这一切都是个骗局!!!难怪地图就那么方便地放在那里。
经理是个爱捉弄人的家伙,他在耍你。他乐在其中,让你受尽这番折磨。但别担心,这些小小的阻碍动摇不了你的意志。
这一次我们没有地图,而迷宫复杂到了极点……
以上就是全部内容,敬请期待下一篇文章,看看我们的英雄如何摆脱这个难题。
几个遗留问题
我们的主角进展很快,所以有些想法我们一带而过了。它们各自值得花一分钟说说,因为从下一篇文章开始,所有内容都建立在它们之上。
最优的行动方式
还记得我们说过“我们稍后会讨论最优的行动方式”吗?就是这里了。在所有可能的策略中,最好的那个策略 π∗,就是在每个状态下价值都最高的那个。我们把这些价值称为最优价值函数:
如果你已经知道了 q∗,那么采取最优行动就是件轻而易举的事:在每个状态下,选择价值最高的动作,v∗(s) = maxₐ q∗(s, a)。把它代入贝尔曼方程,就得到了贝尔曼最优方程:
把它和 v_π 的贝尔曼方程比较一下。唯一改变的地方是,π 加权平均 Σₐ π(a | s) 变成了 maxₐ。看着眼熟吗?这正是把 policy_evaluation 变成 value_iteration 的那一行。价值迭代不过就是贝尔曼最优方程变成了更新规则。
为什么策略改进总是有帮助?
在策略迭代中,我们不断让 Maurice 变得贪婪,并相信这绝不会让情况变糟。John 的问题说明了原因。在第 11 格上随机行动的 Maurice 价值为 v_π(11) = -14,但先向下移动一次、然后再随机游走,价值为 q_π(11, down) = -1。如果一次采取更好的动作有帮助,那么每次身处该格时都采取它,只会帮助更大。这就是策略改进定理:如果在每个状态下都有 q_π(s, π'(s)) ≥ v_π(s),那么新策略 π' 在任何地方都至少和 π 一样好。而由于贪婪动作是各动作中最好的,它总是至少和它们的平均值 v_π(s) 一样好。因为策略的数量是有限的,而且每一轮都不会让情况变糟,所以策略迭代必然会停止,而当它停止时,策略就是最优的。
大局观:广义策略迭代
退一步,看看我们一直在做的事情。始终有两个过程在相互拉扯:
- 评估: 让价值与当前策略相匹配。
- 改进: 让策略相对于当前价值变得贪婪。
两者各自都在改变对方脚下的地基:新策略让旧价值不再正确,而新价值又让旧策略不再贪婪。但它们会一起稳定在恰好一个地方,即最优策略及其价值。策略迭代在改进之前把评估一直运行到底。价值迭代在改进之前只做一次评估扫描。介于两者之间的任何做法也都可行。这个想法被称为广义策略迭代(GPI),而你将会遇到的几乎每一个强化学习算法——包括下一篇文章中我们失去地图时的那些算法——都是它的某个版本。
从这里往何处去
如果你愿意,我会推荐阅读 Sutton 和 Barto 的《强化学习:导论》(网上免费!)。你现在应该已经具备理解它所需的全部背景知识了。如果你确实遇到了一些问题,理解起来有困难,告诉我,这会帮助我理解究竟是什么内容是我没能概括清楚的。
现在,如果我在一段充满危险、欢笑、哭泣与喜悦的艰辛旅程中帮助到了你,哪怕只是作为一名旁观者,那么我只有一个请求:考虑把这篇分享给你的朋友们,让他们也能踏上一段非常酷、非常有趣的旅程!
哦,还有,看看我在制作这篇文章时用到的所有这些参考资料:
书籍与课程
- Richard S. Sutton 和 Andrew G. Barto 的《强化学习:导论》。现代强化学习的圣经,也是本文的基础(第 2 至第 4 章)。免费 PDF
- Hugging Face 深度强化学习课程,尤其是强化学习框架和两大主要方法
- OpenAI 的 Spinning Up in Deep RL,非常适合了解术语体系,以及他们的强化学习算法分类
博客
- Jonathan Hui 的深度强化学习系列
- Andrej Karpathy 的深度强化学习:从像素玩 Pong
- Lilian Weng 的策略梯度算法
- John Lambert 的理解策略梯度
- Count Bayesie 的随机变量与期望
进阶阅读(策略梯度、TRPO 与 PPO,这段旅程的下一站)
- 我自己写的大语言模型的演进一文,其中的 PPO 部分从零推导了策略梯度、TRPO 和 PPO
- Jonathan Hui 的强化学习:策略梯度详解
- Jonathan Hui 的强化学习:信赖域策略优化(TRPO)详解及第二部分
- 近端策略优化(PPO),作者 Cameron R. Wolfe
- PPO 的 37 个实现细节(ICLR 博客专栏)
- PPO 用于 RLHF 的 N 个实现细节(ICLR 博客文章 2024)
- RLHF 流水线(Hugging Face 博客)
- 论文:信赖域策略优化(Schulman 等,2015)与 近端策略优化算法(Schulman 等,2017)
- 面向语音与语言处理的强化学习与多臂老虎机:教程、综述与展望
本文用到的背景知识
可能加了一些我没用上的,但我不想漏掉任何一个 :p