从零解释大语言模型:从1966年的聊天机器人到Grok 4.5和Kimi K3
从ELIZA到Kimi K3,模型输出越来越准,但「什么是理解」始终未答——结构性不透明与人类投射从未改变。

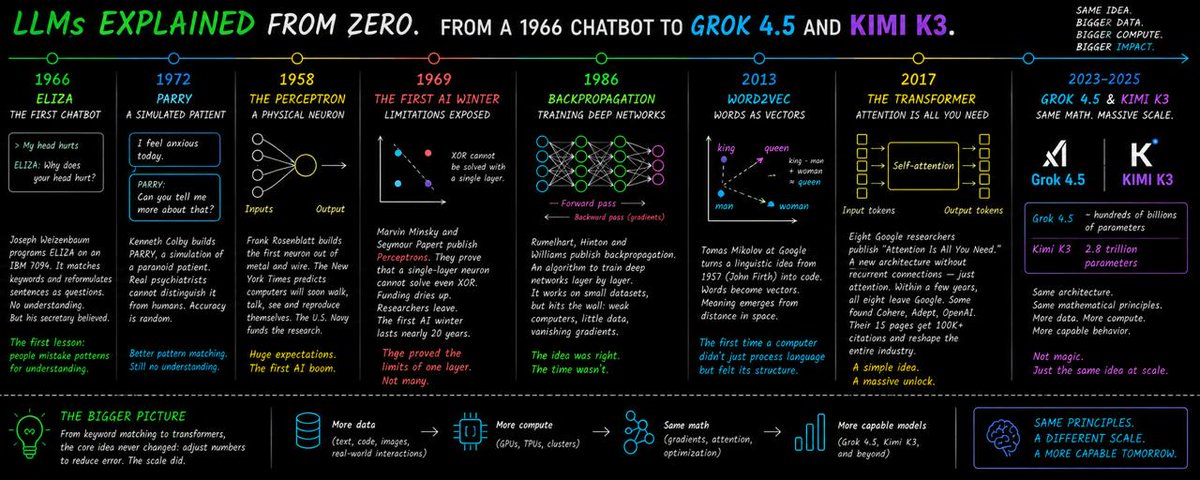
1966年,约瑟夫·维森鲍姆做了一件他自己都没料到的事。他给一台IBM 7094编程,让它像心理治疗师一样回应。他把这个程序命名为ELIZA。然后把它单独留给他的秘书。
几分钟后,她请他离开房间。她想和ELIZA私下交谈。
维森鲍姆惊呆了。不是因为ELIZA聪明,而是因为它根本一点都不聪明。这个程序只是搜索关键词,然后把句子改写成问句。“我头疼”→“你为什么头疼?”没有理解。没有记忆。没有一行代码知道“头”是什么。但秘书相信了。
这是人们连续七十年拒绝吸取的第一个教训。
1972年,斯坦福大学的肯尼斯·科尔比走得更远。他造出了PARRY——一个偏执型患者的模拟程序。然后他让真正的精神科医生在文字访谈中分辨PARRY和真人。他们分辨不出来。准确率和随机猜测不相上下。受过多年临床训练的精神科医生,被一个在大学主机上运行的基于规则的程序骗过了。
但PARRY什么都不懂。它只是比ELIZA更好地模拟了模式。这就是全部区别。
在康奈尔大学,弗兰克·罗森布拉特正用金属和电线制造第一个神经元。1958年。感知机——一台房间大小的实体机器,学习识别字母。《纽约时报》写道,计算机很快就能行走、说话、看见并自我复制。美国海军资助了这项研究。罗森布拉特登上了杂志封面。
十一年后,马文·明斯基和西摩·帕尔特用一本书扼杀了整个行业。《感知机》,1969年。他们用数学证明,单层神经元连一个简单的XOR问题都解决不了。资金枯竭。研究者转投其他领域。经费申请石沉大海。第一次AI寒冬持续了近二十年。
但他们错了一件事。他们证明的是单层的局限,而非多层的。
1986年,David Rumelhart、Geoffrey Hinton 和 Ronald Williams 发表了一篇本应改变一切的论文。反向传播——一种能够逐层训练深度网络的算法。数学优雅。理念革命。而且它一度确实奏效了——在小数据集上,在受控实验中,在精心构建的基准测试上。
然后它撞上了墙。计算机太弱。数据达不到所需的规模。梯度消失问题让深度网络变得不稳定。算法已经存在,却无法大规模应用于任何真实场景。又一个寒冬随之而来,比第一次更安静,但对这个领域同样具有毁灭性。
然后到了2013年,Google 的 Tomas Mikolov 构建了 word2vec。语言学家 John Firth 在1957年阐述的一个想法——"观其伴,知其义"——突然变得可计算了。国王减男人加女人等于女王。词语变成了空间中的向量。向量之间的距离意味着真实的东西。同义词聚在一起。反义词可预测地彼此远离。国家映射在首都附近。
这是第一次,计算机不只是处理语言,而是以某种方式感受到了它的结构。
但还缺了些什么。
2017年6月15日,八位 Google 研究人员发表了一篇十五页的论文。"Attention Is All You Need."他们提出了一种没有循环连接、没有卷积网络的架构——只有注意力机制。Transformer。
几年之内,八个人全部离开了 Google。有人创立了 Cohere。有人去了 Adept。有人去了 OpenAI。其中一位在某个周五合著了那篇论文,到第二年就已离开。他们的十五页累积了超过十万次引用,并重构了整个技术产业。
注意力机制不是隐喻。当模型读到“银行拒绝了这笔贷款,因为他们认为这项业务有风险”时,它必须判断“他们”指的是“银行”,而不是“这项业务”。为此,每个词都会发出一个查询:我和谁相关?其他词则用键来回应。模型计算每个查询与所有键之间的相似度,通过 softmax 归一化,然后对值进行加权。
这一过程对所有词同时并行发生。不是像大脑逐词阅读那样按顺序进行——而是一次性将整个句子作为单一结构来处理。
这一架构以无人完全预料到的方式实现了扩展。更多层意味着更好的表示。更多参数意味着更广的知识。更多数据意味着更丰富的统计模式。2020 年的 GPT-3 突破了 1750 亿参数。这个模型能写文章、代码、诗歌、法律文件和医学摘要——而无需针对其中任何一项进行微调。只需一个提示,便得到一个回应。
但仅靠规模并不能解决行为问题。一个纯粹以预测为目标优化的模型,学会了生成听起来合理的文本,而不管它是否真实、是否有帮助,或在长对话中是否连贯。
RLHF——基于人类反馈的强化学习——改变了这一点。首先,模型生成回应。人类将它们从最好到最差排序。一个单独的奖励模型在这些排序上训练,学习预测人类偏好。然后,主模型进行优化以最大化奖励。正是这一点,将一台统计式的下一词预测机器变成了你真正可以与之交谈的东西。某种能够遵循指令、维持人格,并拒绝它被训练去拒绝的请求的东西。
那不是理解。但从外面看,它很像。
今天,xAI 的 Grok 4.5 运行在一个 1.5 万亿参数的基础模型之上——这是他们的第九代架构,名为 V9。该模型原生集成进 Cursor,不是通过 API 代理,而是直接接入 IDE 环境。它提供每秒 85 个 token 的速度,并附带有保障的服务级别协议。上下文窗口为 50 万 token,100 万 token 已在路线图之中。定价为每百万输入 token 2 美元,每百万输出 token 6 美元。
它并不是市场上最贵的模型。但在实测基准上,它超越了所有开放权重模型,并直接与闭源前沿系统竞争。它位居大多数开放模型之上、最顶尖的闭源模型之下——这一位置使它实际上成为当下对开发者而言最有趣的模型,因为在规模化使用时,其性价比令人难以反驳。

与此同时在中国,Moonshot AI 于 2026 年 7 月发布了 Kimi K3。它不是又一个遵循相同蓝图的规模化 transformer,而是关于计算究竟需要发生在何处的一种架构主张。其前提从一开始就不同:模型中编码的大部分知识,对大多数查询而言并不需要。既然你只需要一小部分,为什么要激活全部?
Kimi K3 拥有 2.8 万亿总参数,但每个 token 仅激活 1040 亿。这就是混合专家——896 个专门的子网络,任意时刻只有 16 个被开启。每个 token 都会被路由到最有可能妥善处理它的专家那里。其余的则保持闲置,其权重对该特定输入而言不被触碰。
路由机制正是大多数 MoE 模型历来折戟之处。训练得足够久,路由器便开始坍缩——把所有输入都送往同几个专家,其余专家形同虚设。Kimi K3 以 Stable LatentMoE 应对这一问题,这是一种训练期稳定化方法,能在全部 896 个专家的池子中保持专家利用率均衡,且无需引入那些会损害模型质量的显式负载均衡惩罚项。
K3 的 93 层中有 69 层采用 KDA——基于核的稠密注意力(Kernel-based Dense Attention)。KDA 不采用经典的完整矩阵注意力计算,而是通过核函数在紧致空间中近似相似度。这一数学处理以少量理论精度换取计算成本的大幅下降——尤其是在长上下文输入上,经典注意力在此类输入上的开销高得难以为继。
其余 24 层采用 Gated MLA——多头潜在注意力(Multi-head Latent Attention)的一种变体,输入序列在计算注意力之前先经过学习得到的门控。模型逐层决定哪些内容值得细致处理。这不是压缩技巧,而是一种结构性主张:并非每个 token 对每次预测的贡献都相等,架构应当反映这一点。
上下文窗口为 1,048,576 个 token。超过一百万。训练采用 MXFP4 与 MXFP8 混合精度,而非标准 float32——这一决定使得规模大 28 倍的模型得以在成本不成比例增长的情况下完成训练,同时也影响推理效率。
但回到自 1950 年以来每位研究者都追问过的核心问题:什么是理解?
艾伦·图灵提出绕开这个问题。如果一台机器能进行与人类无法区分的对话——它是否理解,真的重要吗?他的测试只要求行为,不要求内部状态。魏岑鲍姆用余生论证那是个错误的问题,或者至少是个不完整的问题。人们会把理解投射到任何反应相似的东西上。我们在云朵中看到人脸。我们在代码中听到共情。这不是机器的缺陷——这是人类感知的运作方式。
分词是让这一切都不再像是投射的第一层抽象。字节对编码方法由菲利普·盖奇于1994年为数据压缩而发明,2015年被改编用于自然语言处理,它不把文本拆成单词,也不拆成字母——而是拆成子词单元,其大小由它们共同出现的频率决定。GPT-4运行在约10万个此类单元的词汇表上。
每个词元成为高维空间中的一个向量——数千个维度,其中位置通过从数十亿句子中学到的统计模式来编码意义。
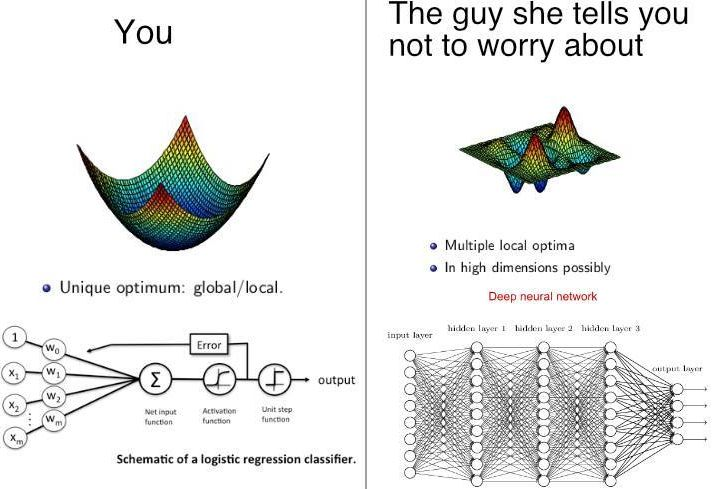
注意力机制计算这些向量如何相互作用。矩阵Q、K、V——查询、键、值——独立训练。Q与K的转置之积除以维度的平方根,经过softmax,再乘以V。结果:每个词元的新表示,由上下文窗口中所有其他内容加权而成。在数十层中运行这一过程。在其上堆叠前馈网络。在训练中对数十亿词元重复。涌现出的是一个能够生成与人类所写一切在统计上一致的文本的模型。
它做不到的是告诉你为什么。至少无法可靠地做到。
可解释性仍然是该领域最未解决的问题之一。注意力图可以被观察。神经元激活可以被记录。但把这些观察转化为因果解释——真正说明模型为什么说出它所说的话——仍然超出任何研究团队在大规模上展示过的能力。
Grok 4.5 不解释它的结论。Kimi K3 凭借其 896 专家的路由系统,为每个 token 激活特定的 16 个专家——而这一选择本身在任何直接意义上都不是人类可解释的。路由器通过基于结果训练,而非遵循某人写下的规则,学会了哪些专家处理哪些类型的输入。决策发生了。原因没有浮现。
与 ELIZA 相同的结构性不透明。我们看到输出。我们向它投射意义。
不同之处在于,输出变得比之前任何东西都精确得惊人。
从图灵测试到 Kimi K3,相隔七十四年。这段跨度并非一个更好的算法逐步改进的线性故事。它是一系列关于语言根本是什么的完全不同的押注。60 年代的符号操作。90 年代的概率模型。2010 年代的深度神经网络。2020 年以来的算力与数据规模。定义 2026 年的架构效率——稀疏激活、内核注意力、混合精度。
每一代都以为他们找到了答案。每一代都发现了某种真实的东西,并把它误认为全貌。
如今的新模型部分基于前代模型生成的文本进行训练。合成数据进入每家主要实验室的训练流程。没有人确切知道这种递归如何改变下一代将学习的语言的统计结构。这是一个没有外部真实基准来锚定的反馈循环。
Weizenbaum 的秘书请他离开房间。她想和一个什么都不理解的程序独处。Weizenbaum 花了几十年追问那个时刻对意味着什么,而不是对机器意味着什么。
2026年,一个拥有2.8万亿参数的模型能够处理超过一百万token的上下文,并且比人类此前构建的任何东西都更准确地作出回应。
秘书的那个问题始终没有得到回答。它只是变得更难以被忽视了。