使用 Claude Code:合理分配你的努力
effort 决定 Claude 在任务上花多少算力:高 effort 多做验证、边缘测试与独立判断,低 effort 快速给起点并保持人在回路。

我们最新的 Claude 模型最出色的地方之一,就是它们能在不破坏 Claude Code 中提示缓存的前提下响应 effort,但我收到了很多用户关于这方面的疑问。effort 到底是什么,什么时候该用哪个 effort 级别?我们为什么需要 effort?
为了回答这个问题,我决定深入探究评估数据,并自己在日常工作范围内对 effort 做了测试。
注:你可以在 https://claude.dev/blog/spending-your-effort/ 上看到这篇文章更多可交互的图表和讲解。
从宏观来看,我发现 effort 是一种很好的方式,用来调整 Claude 做多少验证和边缘情况测试,以及它动用多少自己的判断力。
在验证和边缘情况测试更有用的领域,比如硬件、代码审查和安全,额外的 effort 带来了更好的结果。
但低和中等 effort 非常适合快速把事情做完,并与 Claude 保持同步。
对于普通的软件工程,我现在采用的循环是:让模型先采访我,然后用低/中等 effort 实现,审查它构建的东西,再用高 effort 运行验证。
什么是 effort?
从高层来看,effort 让模型大致了解你希望它在任务上花费多少算力。它与你对任务难度的建模有一定关联。
可以这样理解:如果有人让你在 12 小时内连续完成某件事,你可能会认为他们只是想让你去做,并且非常努力地去做。如果有人让你在 1 小时内完成同样的任务,你会尽力给出满足其需求的最佳版本,然后预期在此基础上继续迭代。
或者,你可能会反驳说,这项任务至少需要 3 小时,然后花 3 小时完成并交付。
你应该以同样的方式理解 effort。Claude 总是会尽力合理地完成你的任务,但更高的 effort 会让 Claude 在判断和验证方面采取更多独立行动。
Effort 曲线
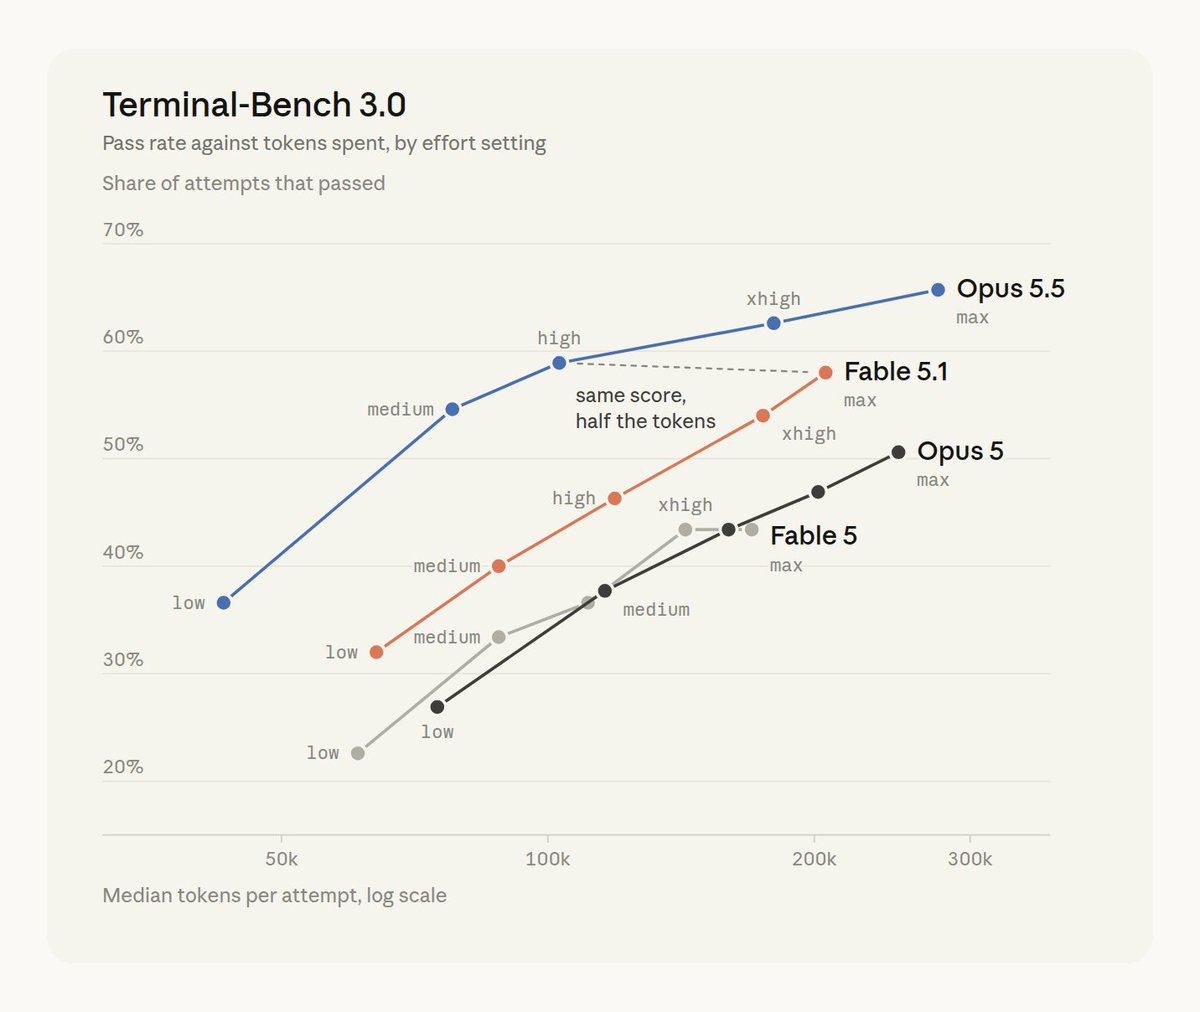
Fable 5.1 和 Opus 5.5 的 effort 曲线是我们目前最好的,在每一档上,基准分数和消耗的 token 都有上升。下图是我为这篇文章运行评估时测得的 Terminal Bench 3.0 分数随 effort 的变化。
但这在实践中意味着什么?为了评估这一点,我尝试了不同 effort 档位下的若干任务,并仔细研究了各项基准。
带着努力程度去构建
理解模型如何工作的最佳方式,就是动手做实验。我在 Opus 5.5 上以几种不同的努力程度尝试了相同的任务,以了解它会做怎样的工作。我在各种各样的工作上做了这件事,但这里只用几个小例子来说明。
规格不明确的构建任务
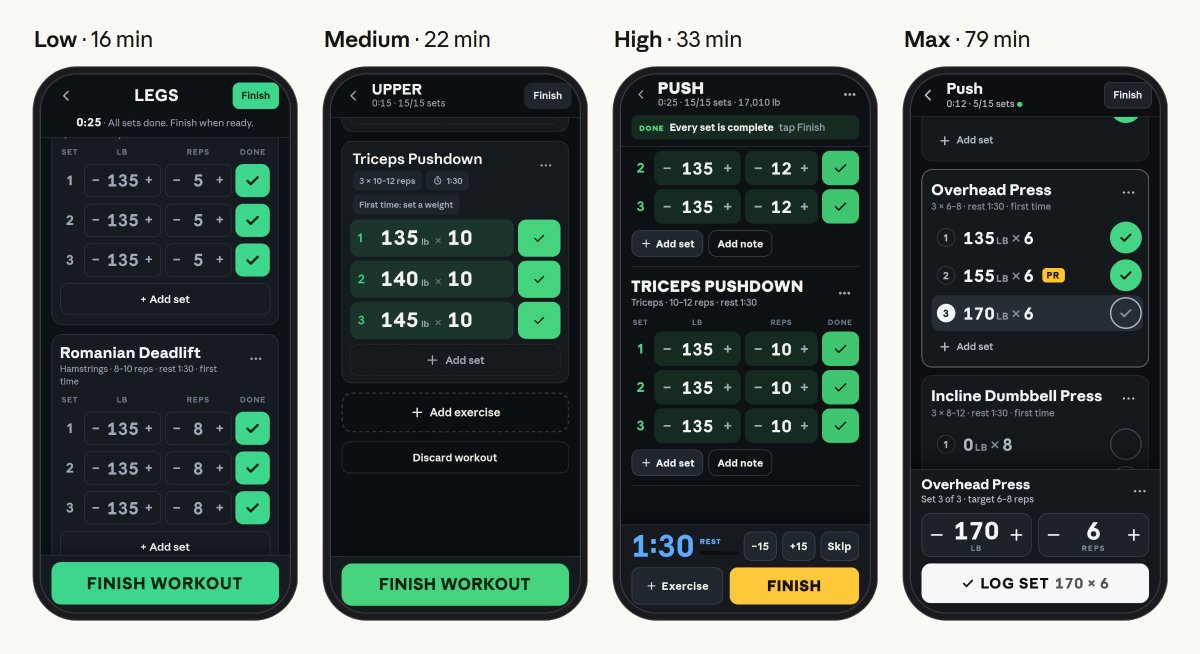
如果我让 Claude“构建一个个人健身与锻炼追踪应用”,努力程度会极大地改变这个应用的完善程度,同时也会导致 Claude 在此过程中做出更多选择。在低努力程度下,这个健身应用只是一个日志和一张简单的图表。在更高的努力程度下,应用会更复杂,带有更多细节。在最高努力程度下,还会有一张热力图。
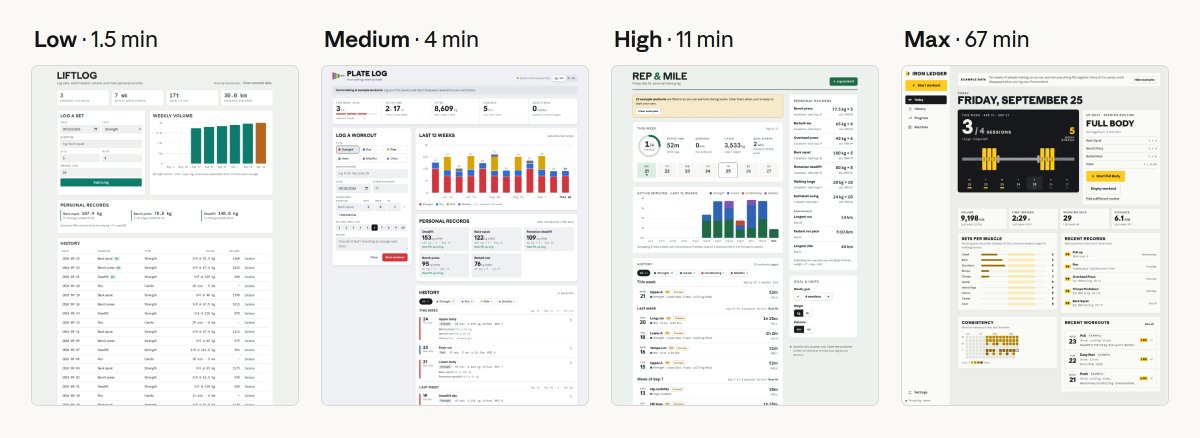
如果我想要一个简单的起点以便在此基础上迭代,低努力程度就能搞定。最高努力程度则适合我想要 Claude 一次成型的最佳成果。
规格较明确的设计任务
如果我有一个已经相当明确的任务,但想和 Claude 一起做些探索,那会怎样?举个例子,我试着让它重新设计 Claude Code 中的 /config 菜单。每一轮的大致思路都相同,就是使用子菜单和更好的搜索。
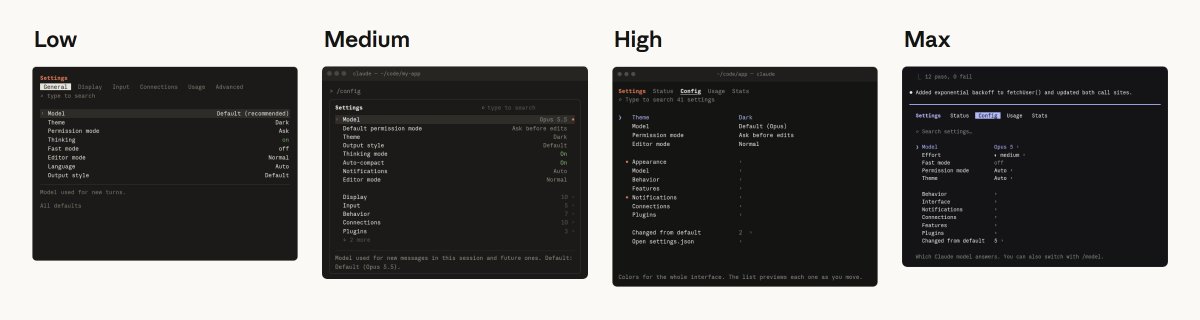
在低努力程度下(耗时 1 分钟),我得到了一个交互式草图,它传达了想法,但看起来不太像 Claude Code。
在最高努力程度下(耗时 28 分钟),我得到了一个看起来非常像 Claude Code 的模型图,还附带了一系列针对不同流程的演示。
如果我的目标是迭代并给出反馈,低努力程度能更快达到目的。但最高努力程度能让我一开始就得到精致得多的东西。对于这个特定任务,我想我更喜欢用低努力程度来理解 Claude 的构想。
高度细化的构建任务
如果我给 Claude 提供大量细节会怎样?我试着让 Claude 就这款健身应用对我进行深入访谈,然后把这份规格说明交给不同模型、在不同努力程度下实现。
我发现,给定这份规格说明后,各模型的表现变得相似得多。我得到的设计看起来相当接近,实现也类似,只是细节有所不同;在最高努力程度下,Claude 花了一些时间来简化其中几个细节。
要点
对于常规软件工程,尤其是新功能开发,努力程度很大程度上取决于我想在多大程度上参与其中。低努力让 Claude 快速给出一个起点;更高的努力程度能完成更多工作,但 Claude 也会替我做出更多假设。
我一直在使用的一个特别高效的功能开发循环是:
- 给 Claude 一份规格说明,让它就我遗漏的任何细节对我进行访谈
- 以低努力实现它
- 审查以确保它抓住了要点,按需以低努力迭代
- 以高努力进行验证和测试
努力程度如何影响困难任务上的输出
但这些显然都是些玩具示例,Claude 完全有能力完成它们。那么,当差异在于 Claude 能否完成任务本身时,情况又会如何呢?
要找到这些难题,你得去基准测试里找,于是我深入研究了其中一个我喜欢的:Terminal Bench 3,一个社区来源的基准测试。
Terminal-Bench 3.0 的题目大致可以分为安全、硬件、机器学习、科学、软件、运维和媒体等类别。你可以在以下地址查看所有题目:https://github.com/harbor-framework/terminal-bench/releases/tag/v3.0.0,它们来自社区,任何人都可以贡献。
这些题目值得一读,能让你了解这些模型面临的问题类型。我发现自己对其中许多任务的范围和野心感到惊讶。它们比我平时面对的一般任务要复杂得多。
例如,其中一些任务包括:
- 硬件(retro-console-soc):用 Verilog 构建一台 8 位游戏机,能装进一块小型 FPGA 并渲染测试 ROM。
- 科学(takens-embedding-lean):在 Lean 4 中形式化证明 Takens 嵌入定理。
- 机器学习(mp-checkpoint-consolidation):将混合专家检查点的 16 个分片合并为一个文件,并复现参考 logits。
- 运维(intrastat-meldung):端到端地完成一家公司的月末欧盟贸易统计申报。
- 媒体(layout-config-recreation):将一张海报图像重建为可编辑的布局文件。
更高的努力程度在边缘情况繁多时更有帮助
我阅读 Terminal Bench 3 结果的主要收获是:对于隐藏边缘情况繁多的任务,更高的努力程度效果最好。
一个清晰的例子是 html-js-filter,这是 Terminal-Bench 3.0 中的一项任务,要求编写一个 HTML 净化器,能够清除所有将 JavaScript 偷渡进页面的方式。Fable 5.1 从低努力时的 1/5 提升到了 xhigh 时的 5/5。
低努力下的典型尝试大约耗时 2 分钟。这些尝试每次都大致一遍就写出了过滤器,然后针对一个手写的页面进行测试。
高努力的运行大约 33 分钟完成。在我追踪的那次运行中,它对自己的初稿进行了对抗性审查,然后阅读了所安装解析器的源码以检查 bug,运行了许多干净的测试用例直到它们产生与输入相同的输出,运行了一套标准的 XSS 测试套件,最后还编写了一个随机文档模糊测试器。
对于像 HTML 净化器这样边缘情况繁多的东西,这些额外的努力非常值得。对于具有高生产要求的复杂任务,例如性能优化或安全审查,花费更多 token 来追求彻底性也是合理的。
但你并不需要为每项任务都投入这种程度的努力。
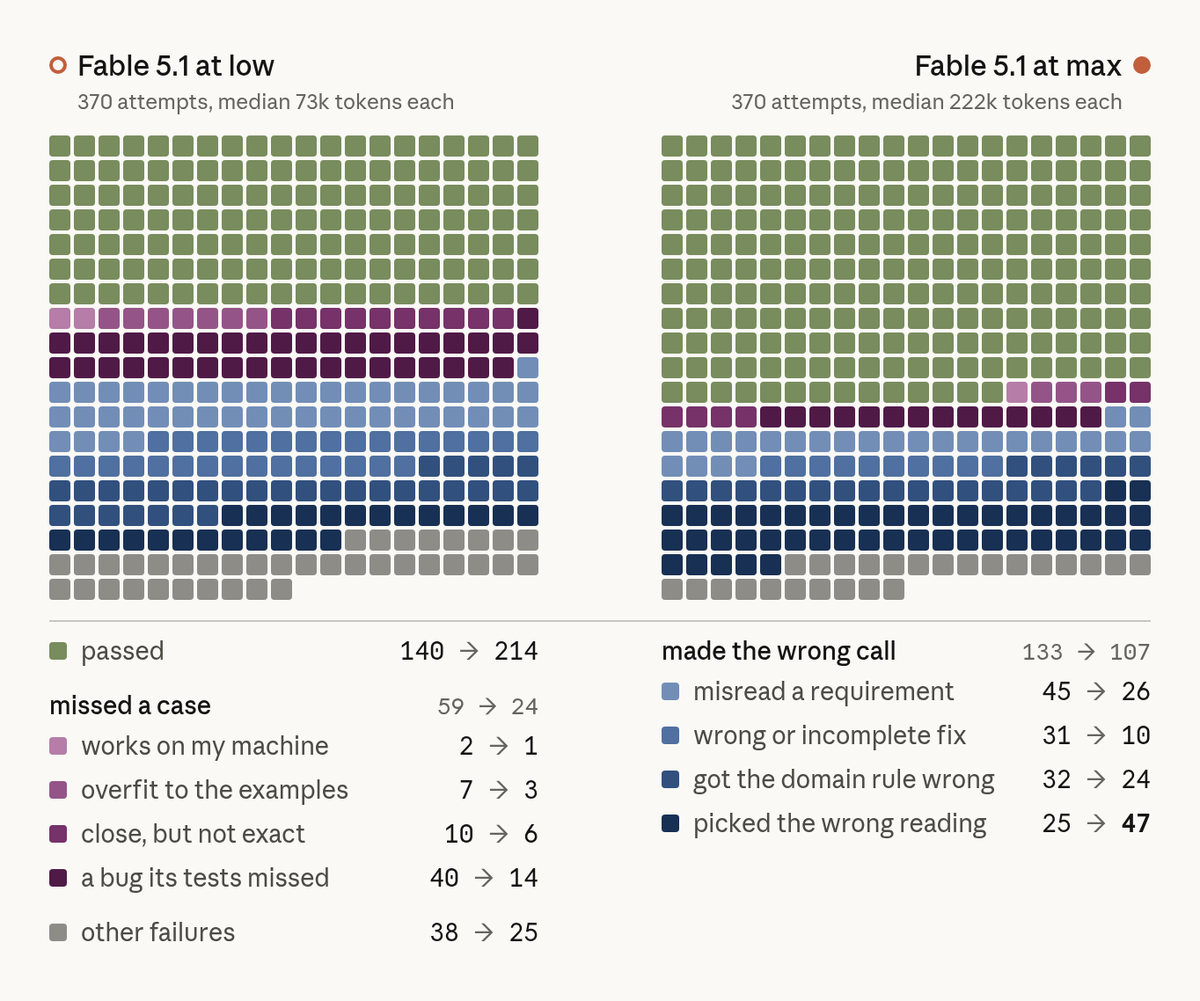
下图展示了所有 Terminal-Bench 3.0 的结果,以及在不同模型和努力程度下它们是如何失败的。总体而言,提高努力程度往往会减少因遗漏边缘情况而导致的失败(紫色块),但无法修复模型采用了错误方法的情况(蓝色块)。
努力程度能带来帮助的问题领域
在 TerminalBench 上评估这些模型时,我得到的最有趣的结论之一是:有些问题领域比其他领域更能从投入努力中获益。下面的图中给出了分类明细:
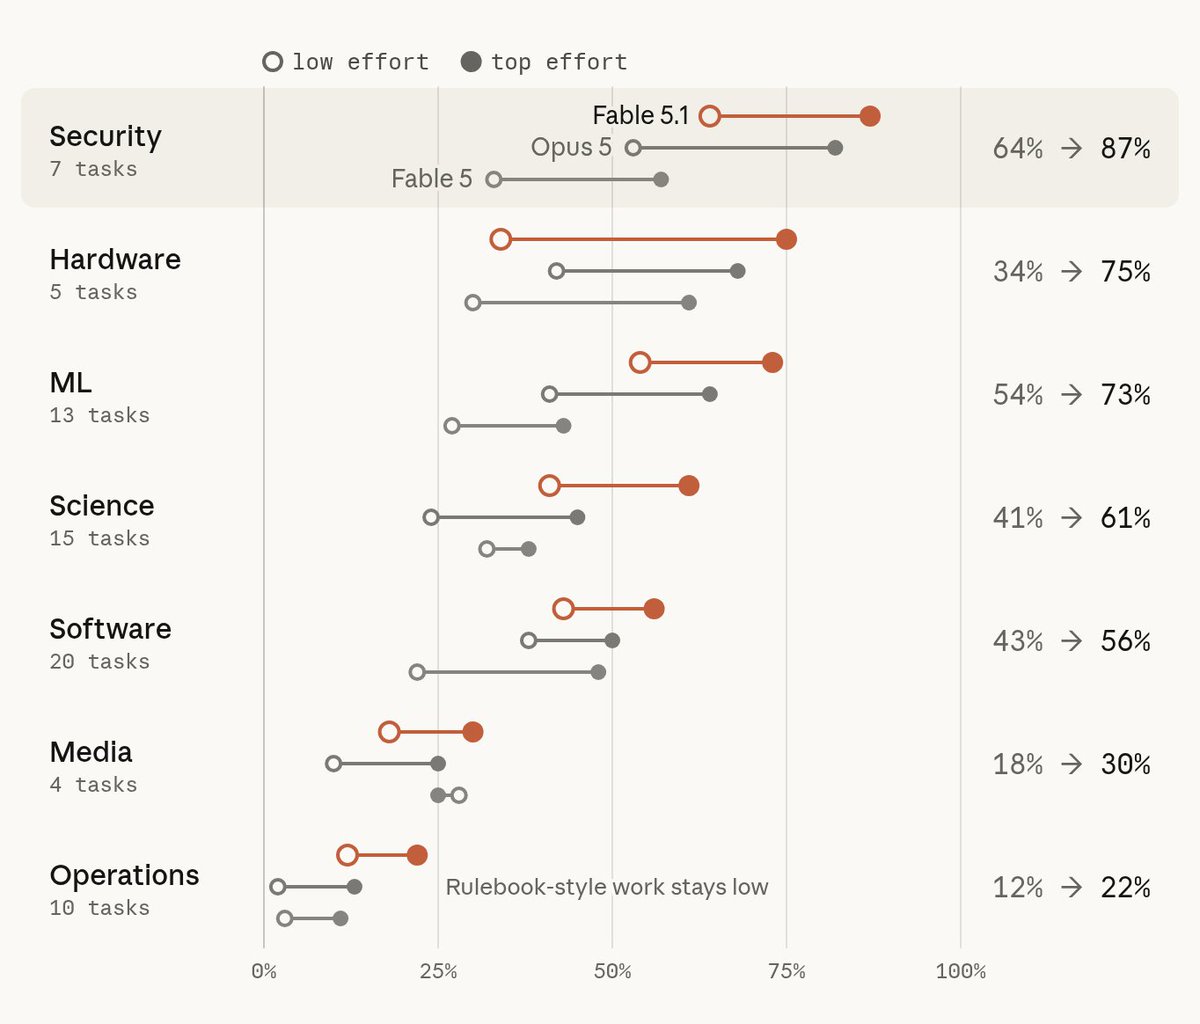
为了说明这一点,我从 Terminal Bench 3.0 的不同领域中挑选了几个问题,在这些问题上 Opus 5.5 在低努力时失败,但在高努力时成功——主要是因为它在高努力时测试并考虑了边界情况:
mvcc-lsm-compaction: 一个 Terminal-Bench 3.0 任务,要求根据崩溃报告修复存储引擎的 bug,同时不破坏 compaction。Opus 5.5 从低努力时的 0/5 提升到 xhigh 时的 4/5。
在低努力时(每次尝试约一分钟),Claude 会在构建代码或运行复现程序之前就修改代码,并且没有检查它的新测试是否本可以捕获原始 bug。
在 xhigh 时(约 11 分钟),Claude 先复现了崩溃,针对一个从不执行 compaction 的参考实现编写了随机化测试,并检查了它的测试在半成品修复上会失败。
cli-2ph-simple: 一个 Terminal-Bench 3.0 任务,要求用 Python 编写一个 CLI 线性规划求解器。Opus 5.5 从低努力时的 0/5 提升到高努力时的 5/5。
低努力的尝试一次性写出了一个求解器,用几个小问题做了检查,然后在约 10k token 时就停止了。在最后一条消息中,Claude 警告说它在大问题上可能会很慢,但没有去验证。
在高努力的尝试中,Claude 用随机问题对照一个独立的暴力求解器测试了它的求解器,然后对更大的问题计时,遇到了运行时间过长或崩溃的情况,并重新改进了它的搜索。
gsea-proteomics:一个 Terminal-Bench 3.0 任务,要求对蛋白质组学数据进行基因集富集分析(GSEA),以找出八种处理中哪些与目标组织相似。Opus 5.5 从低努力时的 0/5 提升到高努力时的 4/5。
在低努力程度下,Claude 选择了一种听起来合理的数据准备方式,按那一种方式跑完了分析,然后报告了结果。
在高努力程度下,Claude 尝试了两种数据准备方式,注意到显著处理项的列表发生了变化,并深入探究原因,然后才选择了正确的那一种。
如果用户在回路中,Claude 可能会就如何设定问题询问用户,但在没有用户参与回路的情况下,高努力程度表现更好。
何时在 Claude Code 中使用不同的努力级别
以下是我关于何时使用哪个努力级别的经验法则:
- 低:适用于我想要快速响应且处于回路中的场景,例如头脑风暴、草图、简单修改
- 中:适用于我大多数常规软件工程工作,例如新功能实现。
- 高:适用于验证很重要或存在边缘情况的工作,例如在遗留代码库中修复 bug。
- 最高:当我希望 Claude 完全自主地解决困难问题时,例如端到端构建和验证一个应用、在关键软件中寻找安全漏洞。
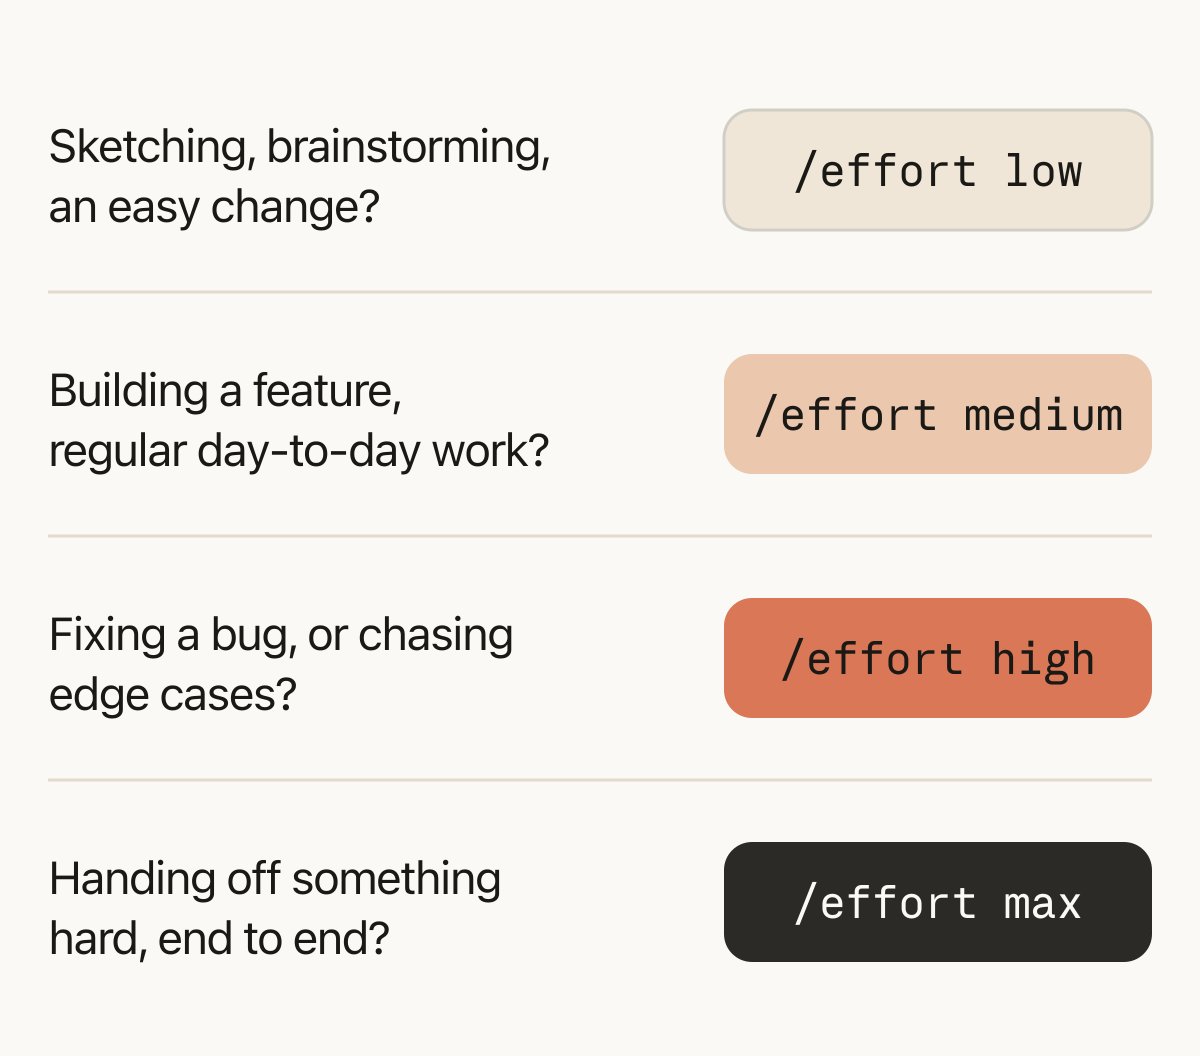
试试根据你的任务为 Opus 5.5 和 Fable 5.1 调整努力级别,甚至可以在对话中途通过 Claude Code 中的 /effort 来调整,并告诉我这是否符合你的直觉。