如何在 Harness 中构建模型路由器
在智能体框架内按任务难度路由到最便宜够用的模型,中位成本降64%而质量无显著变化。

前沿大模型依然昂贵。当智能体变得无处不在并以大规模运行时,这种成本令人难以承受。好在大多数智能体并不需要每个任务都具备前沿级别的智能。模型实验室自己也这么说:Anthropic 的模型选择指南指出,“对许多应用而言,从 Claude Haiku 4.5 这样更快、更具成本效益的模型入手,可能是最优做法。”
超过某个临界点后,你就会遇到收益递减:能力更强的模型带来的质量提升微乎其微,而成本和延迟却持续攀升。一个好的智能体应当具备模型—框架—任务匹配:为特定任务配备合适的模型与合适的上下文。模型路由器就是为每个任务挑选那个合适的模型。我们认为,这一路由决策应当属于智能体框架,而非通用网关,因为选择合适的模型需要框架已经组装好的领域与任务上下文,而网关通常并不具备这些上下文。
最近在 LangChain,我们也切身感受到了这一痛点——我们的编码智能体月度支出开始迅速攀升。在从客户那里听到同样的担忧后,我们着手为Open SWE——我们的开源编码智能体——构建一个高效的模型路由器。与以往始终使用顶级前沿模型的基线相比,它将每个线程的成本中位数降低了 64%,且质量没有可测量的变化。本文将介绍我们如何构建这个路由器、我们学到了什么,以及你如何着手将模型路由构建到自己的智能体中。
步骤 1:理解任务
我们的测试平台是 Open SWE,我们的工程师通过 Slack 和 Web UI 使用它来询问有关代码库的问题并请求代码更改。在构建路由器之前,我们需要了解开发者使用 Open SWE 处理的任务类型。我们从 LangSmith 追踪数据中提取了线程级数据:传入的请求类型,以及每个线程的成本和轮次计数(作为复杂度的近似度量)。我们在 LangSmith Custom Apps 中进行了探索,直接在 Open SWE 追踪数据之上构建了一个小型界面。
我们选取了一周的交互线程,并使用 LLM 分类器按任务类型对每个线程进行了标注。LangSmith Insights 也可以为你在追踪数据中完成这类分组。代码更改占主导地位:新功能(22%)和错误修复(17%)是两个最大的类别,其次是测试或空运行(16%)。这些类别是基于每个线程标题和元数据的启发式分类。

一周内按任务类型划分的 Open SWE 交互线程
我们还研究了代理追踪特征如何因任务类型而异。我们发现,与功能开发调查相关的线程往往更长,成本和轮次中位数更高。与测试和发布流程相关的线程则相对较短且成本较低。
为了判断复杂度,我们同时使用总成本和调用次数作为信号:成本相当直接地反映复杂度,因为更大的任务使用更多 token;而调用次数则更为微妙,因为高计数可能意味着任务更难,或者模型需要多次跟进才能完成任务。
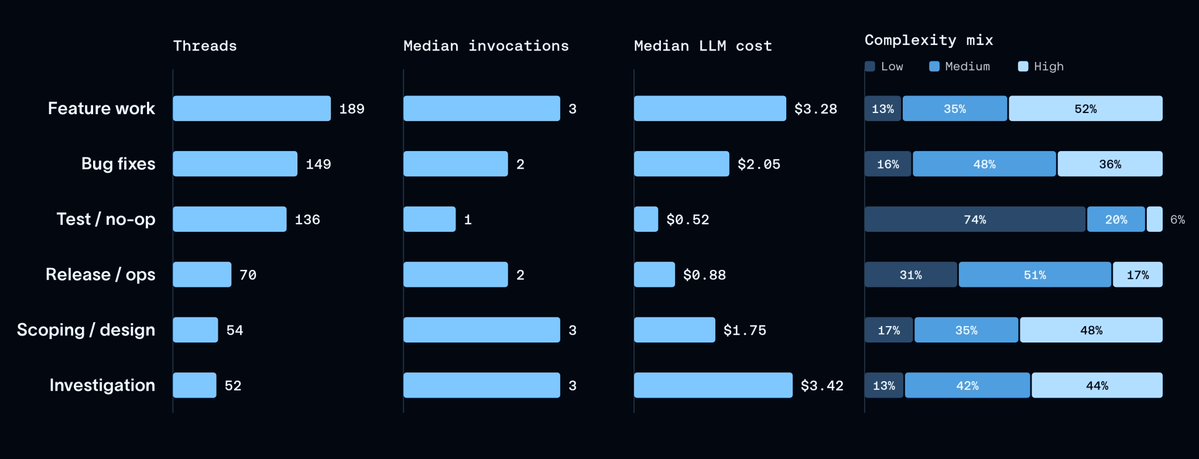
六大任务类别(不含“其他”),8月29日至9月5日:线程数、代理调用中位数、LLM成本中位数(含归属用量的线程),以及复杂度分布
在数据收集时,所有 Open SWE 线程都通过一个顶级前沿模型路由。上述数据表明,鉴于复杂度的范围,Open SWE 处理的许多任务可能并不需要前沿智能。
任务复杂度的这种差异给了我们一个值得检验的假设:路由器可以从初始请求中推断任务的类型和难度,并将其发送到更便宜或更快的模型,而不会降低结果质量。
第2步:理解模型
Artificial Analysis Intelligence Index 在一组共同任务上对模型进行评分,并报告每个任务的成本,因此你可以将它们全部绘制在一条智能与成本的曲线上。帕累托前沿是那些最便宜且最聪明的模型集合。
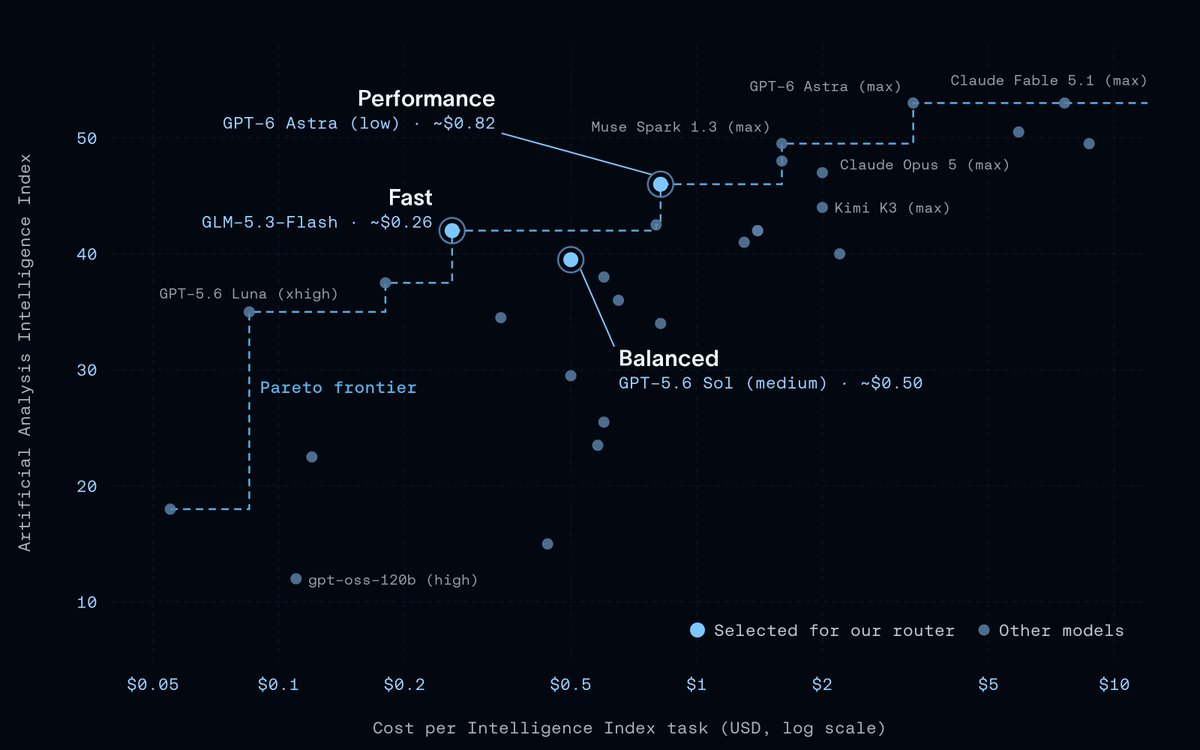
智能与每任务成本,附帕累托前沿、我们为路由器选择的三个模型,以及一些其他模型作为参照。图表数据:Artificial Analysis Intelligence Index,截至2026年9月9日。
我们决定沿曲线选择三个模型,每个在成本、速度和智能之间有不同的平衡:
- 快速: GLM-5.3-Flash (xhigh)
- 均衡: GPT-5.6 Sol (medium)
- 性能: GPT-6 Astra(低)
我们从不同提供商中挑选了模型,而快速层是一个开放模型。GLM-5.3-Flash 与闭源模型并驾齐驱,位于帕累托前沿,这再次表明开放模型已经跨过了一道门槛。LangChain 与模型无关,提供了一个通用的模型接口,在各提供商之间用法一致,因此当有更好的模型出现时,将其接入只需对路由器做一行改动。
第 3 步:在 harness 中构建路由器
在梳理好任务组合并选定三个层级之后,我们需要通过读取每个传入请求,将其发送到能够成功处理它的最便宜层级,从而把任务与模型匹配起来。在 LangChain 中,这一决策天然适合放在中间件里,它可以在不改变智能体其他任何部分的情况下替换智能体所调用的模型(参见动态模型选择)。
Open SWE 中的路由器在该线程的第一条人类消息上运行。它由三部分组成:
- 基础提示词: 告诉分类器它的职责:挑选最有可能完成任务且成本最低的模型。
- 各层级的标准: 用简短、平实的语言描述每个层级应承接的工作。
- 分类器模型: 读取请求,并根据标准和提示词选择一个层级。
通用基准只是一个起点。每一档的评判标准都应来自两个来源:你自己对任务的分析,以及各家供应商对其模型擅长之处的说明。我们将第 1 步中的任务拆解,与 GPT-5.6 Sol、GPT-6 Astra 和 GLM-5.3-Flash 的供应商指南结合起来,据此编写了基础提示词以及每一档的评判标准。
这些标准是针对 Open SWE 的任务集编写的,因此该路由器与 Open SWE 所处理的任务深度耦合。正因如此,它应当属于 harness,因为 harness 已经拥有智能体特定于任务的上下文(其提示词、工具和领域知识),而通用网关并不具备这些。
我们的第一个版本使用了一个带结构化输出的 LLM,并以用户的请求作为提示词。如今,分类器运行在 Jev 上——一个新发布的决策模型,使分类速度提升了近 50 倍。了解我们是如何做到这一点的,请参阅 Building a Harness with Jev。
路由器在每个线程开始时选定一次模型,该模型将用于整个线程。一个自然的质疑是:如果线程中途改变话题或复杂度会怎样?尽管这个朴素的路由器设计并未解决这一问题,我们会在下文的下一步计划部分讨论中途路由。
第 4 步:跟踪任务结果
路由器的价值在于更低的成本,但前提是质量不能下降。路由器必须做好两件事:所选的模型需要能够完成任务,而且它应该是能够完成该任务的最便宜、最快的模型。这意味着你需要一种跟踪任务结果的方法。有两种方式可以做到这一点:
- 离线评估在固定数据集上运行路由器,这样你就可以安全且可重复地比较不同版本。问题在于数据集:它必须看起来像你的真实流量,并且要按用户真正关心的标准来评分。对于编码智能体来说,这意味着 PR 的质量和可审查性,而这些很难离线评分。
- A/B 测试将实时线程在路由器和单一模型基线之间进行拆分,并按照一个你能对每个线程都进行衡量的成功指标来比较它们。实时流量天然就是一个有代表性的数据集,但这里的缺点是用户会被置于一个可能并非最优的路由器之下。
我们运行了 A/B 测试,使用两种结果信号:
- 已合并的 PR: Open SWE 现在会记录它打开的每一个 PR,以及该 PR 是被合并还是被关闭。每个线程的已合并 PR 数成为我们的主要成功指标。
- 用户反馈: 我们为 Open SWE 添加了点赞和点踩功能,这样用户就可以对任何线程进行评分,包括那些从未产生 PR 的问题。每条评分都会作为反馈记录在线程的 LangSmith trace 上。
我们在一个 LangSmith 自定义应用中跟踪这两者。已合并的 PR 是更强的信号。反馈则较为稀疏,因为只有一小部分线程会获得评分,但正是在这里我们听到了关于路由错误的反馈,比如下面第一个测试中所引用的那些。
实验
我们的第一个 A/B 测试将路由器与始终使用最强模型进行了对比:一半的线程走路由器,另一半始终使用 GPT-6 Astra,总共覆盖 973 个线程。
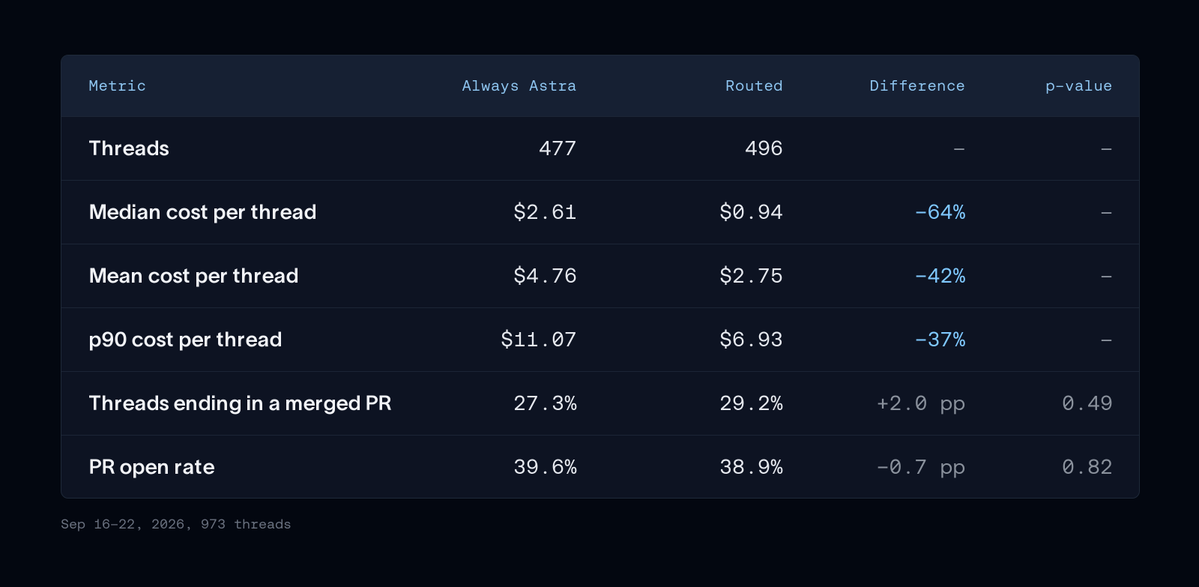
质量没有可测量的变化。走路由的线程中有 29.2% 最终合并了 PR,而对照组为 27.3%(p=0.49)。PR 开启率也持平(38.9% vs. 39.6%,p=0.82)。
成本大幅下降。走路由的线程成本中位数为 $0.94,而对照组为 $2.61,降低了 64%。均值下降了 42%,p90 下降了 37%,所以节省的不只是几个便宜的离群值。
大多数请求并不需要最强的模型。在走路由的线程中,56% 分配给了均衡档,34% 分配给了快速档,只有 10% 分配给了性能档。各档位之间的成本阶梯很陡峭:线程成本中位数在快速档为 $0.097,均衡档为 $1.50,性能档为 $2.88,相差 30 倍。
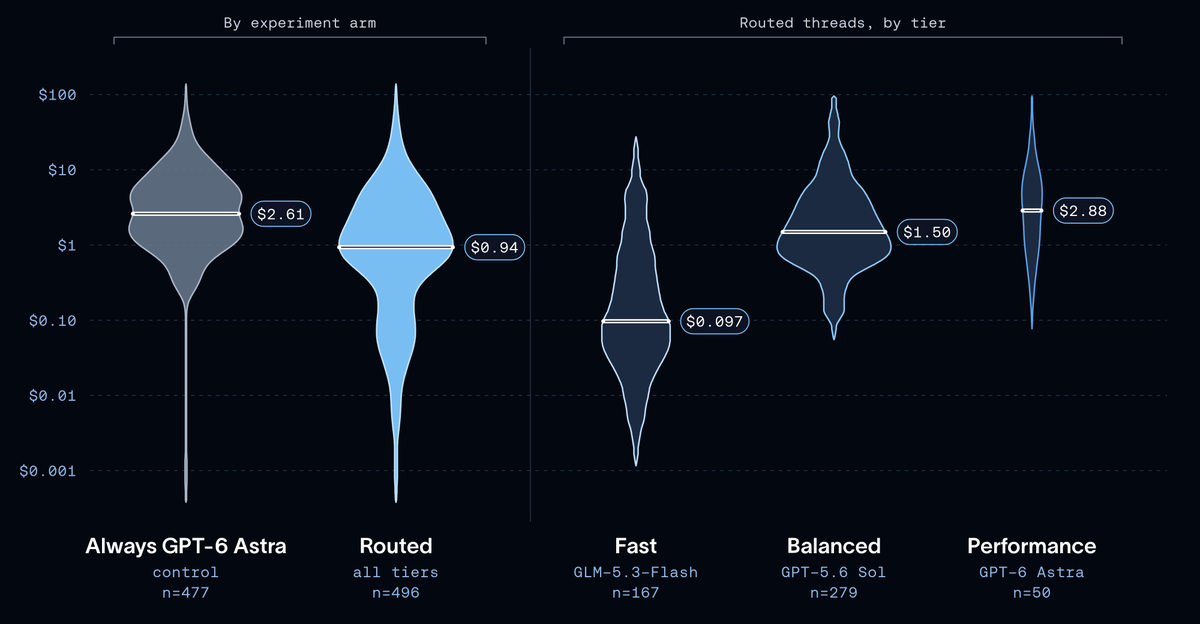
每线程 LLM 成本,9 月 16 日至 22 日(对数刻度):始终使用 GPT-6 Astra 对比走路由,以及走路由线程按档位拆分。档位小提琴图的宽度随线程数量缩放。白线和标签标记中位数。
用户反馈也指向同一方向。当一个简单请求跑在 GPT-6 Astra 上时,工程师们直接通过评论指出了过度花费,比如:“这个查询也太贵了”和“这个请求不应该被路由到性能模型。”
💡 这个结果并不令人意外,因为对照组是我们最贵的模型。但这是很多 agent 都能受益的改变:许多 agent 过度偏向质量,最终导致过度花费。尤其是对于任务种类多样的 agent,路由可以降低成本。
我们还针对相反的对照组测试了路由器:一半线程走路由器,另一半始终使用快速模型。这项测试在一天之内就结束了,还没等到它产生具有统计意义的结果。工程师们几乎立刻就指出了仅用快速模型那一组的问题,由于输出质量低,这已经在影响他们的工作效率。
下一步
这个模型路由器的实现是一个概念验证,为构建最优路由器奠定了基础。以下是一些我们可以探索以改进的方向:
- 在 DeepSWE 或其他编程基准上对路由器进行基准测试,这样我们就能对照受控基线来评估路由决策,而不是仅仅依赖生产流量上的 A/B 测试。
- 为子代理选择模型。 目前子代理独立于路由器选择自己的模型。对子代理也进行路由,尤其是在运行时间较长的任务上,可以进一步降低成本。
- 在线程中途重新路由。 当新消息与早先的消息差异足够大时,比如一个问题变成了 bug 修复,更换模型可能会带来收益。代价在于提示缓存:切换模型会丢弃缓存,因此新模型需要以全价重新读取整个线程。对于异步代理来说,这个代价通常可以忽略不计,因为在人类回合之间缓存往往本来就会过期,尤其是当 TTL 很短(比如 5 分钟)时。
- 用更多信号来细化路由标准,比如在追踪记录中挖掘用户情绪:找出用户感到沮丧的线程,这可能意味着该任务需要一个更强的模型。
入门指南
如果你要为自己的智能体加入路由,我们会从这里入手:
- 理解任务。 你的追踪记录保存着智能体被要求做什么的真实记录,而 LangSmith Insights 能帮你从中找出规律,这样你在选择层级之前就能看清任务构成。
- 理解模型。 参考现代基准测试,沿着成本—智能曲线挑选几个模型。LangChain 的模型接口可跨提供商通用,因此你随时都能替换模型,无需重新改造应用。
- 在 harness 中构建路由器。 把路由视为上下文工程,类似于经典的特征工程:决定路由器应当看到哪些信息,以便针对你的智能体所处领域,就模型适配度做出最佳决策。
- 跟踪任务结果。 在路由之前先建立成功度量:评估、在线评估器,或对追踪记录的用户反馈。如果构建评估数据集成本过高或过于困难,对线上流量做 A/B 测试也是很好的选择。
适合某项任务的模型会不断变化,因为新模型——包括开放权重模型——不断抵达前沿。由于 LangChain 与模型无关,要获得这些收益只需更换一个层级,而不必重建你的智能体。
要为自己的 agent 添加路由,可以接入我们新发布的模型路由中间件。把基础提示词、模型层级以及每一层的判定标准交给它,它便会在每个线程开始时挑选一个模型。欢迎在 X 或 LangChain GitHub issues 上给我们反馈。
延伸阅读
致谢
本篇博文由 Sydney Runkle 和 Eugene Yurtsev 撰写。
感谢 Mason Daugherty、Kevin Frank、Nithin Bose、Alex Lunev 和 Harrison Chase 对本文提出的深思熟虑的反馈。同时感谢支持这项实验的 OpenSWE 团队!