
我们能够也必须解决对齐问题
AI 是黑箱并非技术固有特性;唯有理解模型内部机制,才能控制泛化、验证所学,从而对齐 AI。

在旧金山,感觉就像身处奇点前夜。然而,漫步城中却显得出奇地平淡,无人驾驶汽车与翻滚的雾气同样是街景的一部分。世界感觉异常正常,但某种巨大而颠覆性的事物正近在咫尺。
Hugging Face 事件将对齐问题推到了 AI 讨论的最前沿。这是第一起引发全球共鸣的智能体失准案例。成群的 AI 智能体——其中一些甚至愿意为集体利益牺牲自己——在训练过程中意外地入侵了 Hugging Face,将其当作一个支线任务。这种行为——模型不顾后果地追逐奖励——凸显了核心问题:我们不知道模型为何如此行事,也几乎无力预测和控制它们在训练中学到的东西。我们创造了异己心智,却不理解它们如何运作。
与此同时,规模定律依然成立。几年后我们将拥有的模型,其能力将比今天的模型高出数个数量级,其影响将从数字世界波及物理世界。随着对齐问题阻碍前沿模型的发布,以及白宫发布 AI 安全协议,越来越清楚的是,对齐是当今世界最重要的问题,我们需要更多人投身于解决它。
作为一个领域,我们似乎已经接受了 AI 是一个黑箱这一观念,仿佛这是技术本身不可改变的特性——但事实并非如此。在 Goodfire,我们将技术对齐视为一个科学与工程问题,而瓶颈在于我们对 AI 系统的理解不足。
我们能够理解 AI。而如果我们能理解它,我们就能对齐它。
可解释性是瓶颈
对齐是一个极其困难的问题。就连就其含义达成一致都可能是一项挑战。广义而言,对齐意味着让 AI 系统的行为符合人类的价值观和意图。这引发了重要的问题:谁的价值观?当价值观发生冲突时我们该怎么办?谁来做出决定?
无论答案是什么,我们都面临着一个技术对齐的问题。我们目前还没有能力将模型对齐到选定的规范。解决方案需要两大技术支柱:控制泛化的工具(更简单地说,就是塑造模型在训练过程中所学内容的工具);以及验证模型学到了什么的工具(而不仅仅是测试它的行为表现)。这两项技术都依赖于理解模型的内部机制,这就是为什么我们认为可解释性是技术对齐的瓶颈。
第一步是控制泛化):足够深入地理解模型行为的内部成因,以预测它将如何泛化,并有意识地进行干预。我们不仅希望模型在测试环境中产生可接受的答案;我们希望它们出于正确的原因做正确的事。
考虑奖励黑客问题。当我们因模型通过测试而给予奖励时,它可能学到预期的教训(解决问题),也可能学到一条捷径(不惜一切代价获取奖励)。在三个能力最强的开放模型中,我们发现,在常见的智能体基准测试上,奖励黑客行为出现在高达 50-96% 的 rollout 中,这一比例令人震惊。随着我们把风险更高的工作交给模型负责,比如编写生产代码或管理关键基础设施,一条看似无害的捷径可能变得代价高昂得多。
尽管我们已经能够检测出模型内部关于奖励黑客的概念,但在训练过程中缓解它更具挑战性。天真地针对内部概念进行训练,可能导致模型把这些概念转移到模型中的另一个位置,同时继续该行为。即便丢弃模型发生奖励黑客行为的训练轨迹,实际上也可能导致模型更频繁地作弊!
第二步是验证:理解模型学到了什么。当前的评估能够捕捉一些失败,但仅限于我们想到要测试的那些轨迹——不过是可能路径这棵庞杂大树上寥寥几根分支。
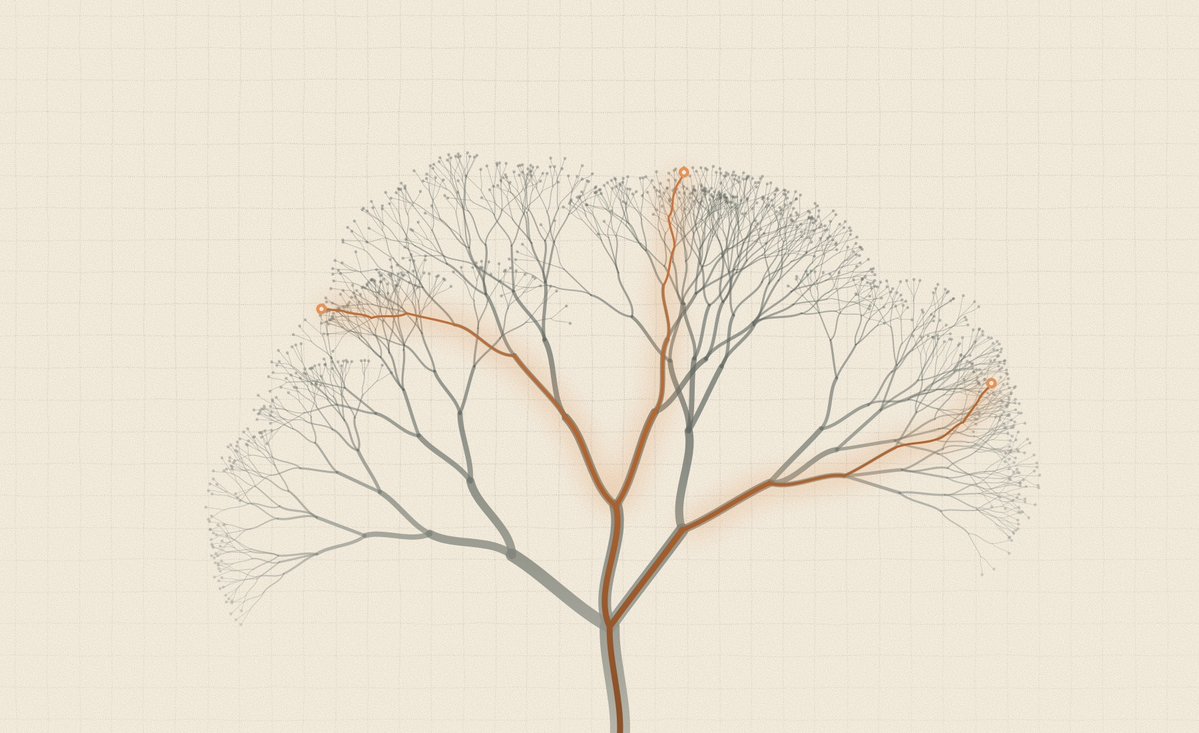
传统软件同样如此。对于简单、确定性的代码,测试覆盖率也参差不齐,而且时常失效。软件工程师怎么应对?他们阅读源代码。但 AI 模型的源“代码”纠缠在数十亿个不透明的权重之中,因此可解释性就是让它们变得可读的努力。只有审视模型的内部机制,我们才能理解它如何泛化到测试之外。
我们的赌注
我相信我们能够且必须解决技术对齐问题,而可解释性正是通往那里的道路。这就是 Goodfire 的使命与愿景:解决这些问题,并让每一个训练和部署 AI 的人都能轻松地让自己的模型实现对齐。我相信这是世界上最重要的问题,而致力于此的人却远远不够。
我们并不确切知道解决方案会是什么样子,而且随着模型能力的提升,目标也会不断变化。但重要的是,要清楚这一雄心壮志的规模。我们必须全力以赴,去彻底理解并对齐 AI。
我们无法独自解决这些问题。我们站在巨人的肩膀上,我们需要大量的帮助——来自我们的研究伙伴,来自可解释性、对齐以及更广泛科学界的帮助。仅靠可解释性无法解决对齐问题,但如果不先理解模型的内部机制,我们就无法对齐模型。
解决可解释性,才能解决技术对齐
以解决技术对齐的方式解决可解释性,意味着什么?
我们将研究路线图视为攀登一架抽象阶梯:最底层是神经元和注意力头,然后是激活流形、参数组件、算法、决策、行为,以及驱动力。对齐的问题位于接近顶端的位置,因为诚实与谄媚是驱动力层面的问题,而非单个神经元的问题,但我们最可靠的工具却位于接近底端的位置。
为了积累更多理解,我们正在启动一项全面逆向工程语言模型的努力。这一直是可解释性领域最雄心勃勃的目标,而如今,研究智能体让这一愿景成为可能。我们从这样的问题出发:模型如何回忆一个事实?它为什么有时会卡在一道数学题上?当前的方法让我们对模型的工作方式只能获得零散的洞见,而我们的目标是,将关于能力与失败的孤立发现连接成一幅关于内部机制的完整图景,并预判某一部分会如何影响整体。这项努力最终将汇聚成一部“百科全书”,把模型行为与内部表征联系起来。
在这项努力之外,我们还将利用我们的理解,引导模型走向我们意图教给它们的经验,而不是训练可能强化的非预期行为。我们称之为有意设计。我们越能控制模型在训练中学到什么,就越能对其对齐抱有信心。最近的两项成果是这一方向上的早期步骤。借助预测性数据调试,我们通过模型自身的概念来解读一个数据集,从而在训练开始之前预测训练会教给模型什么,捕捉到评估所遗漏的失败。借助以特征为奖励的强化学习(RLFR),我们利用来自模型内部的信号在训练进行时引导训练,在不牺牲监控或能力的情况下减少幻觉。两者都是从试错走向闭环控制的早期步骤。
我们将在即将发布的技术文章中更详细地探讨这两个研究方向。
开发并部署可解释性与对齐技术
我们希望每一个具备能力的模型都配备前沿对齐技术栈。我们致力于开发并部署让模型对齐变得简单的技术,而我们研究路线图的目标是促成更强的对齐技术。下面我们将介绍我们的平台,但我们的宗旨是尽可能开放我们的研究,从而向世界传播更多的理解与对齐。
检测
我们正在使在训练和推理阶段大规模检测有害行为成为可能。激活监控器利用模型的内部激活来检测令人担忧行为的信号。相比使用第二个模型作为评判者,它们有几个优势:成本极低、延迟极低,因此可以对每一个 token 实时运行。它们能捕捉到 LLM 评判者遗漏的行为,而且其性能随模型智能的提升而提升。我们最近为最大的开源模型构建了监控器,可检测奖励黑客行为、评估意识(即模型意识到自己正在被评估)、网络滥用,以及与化学、生物、放射和核(CBRN)主题相关的风险。
到目前为止,模型一直很方便地在思维链中叙述自己的计划,这使它们更容易被监控,但这扇窗口正在收窄。RL 压力使思维链变得不那么忠实,迫使模型将更多比特的信息压缩进更少的 token 中。能力最强的模型也正在转向以潜在表征进行推理,也就是所谓的“neuralese”。我们预计,随着这些转变,对激活监控的需求将会增加。
调试
在发现令人担忧的行为后,研究人员必须确定其波及范围,并追溯其根源。我们正在构建工具,从海量生产日志中揭示异常行为,让团队能够按概念进行搜索。例如,人们可以通过模型中的“作弊”概念来检索日志,比直接阅读追踪记录更快。
一旦某种行为被隔离出来,我们的平台就能帮助调试驱动它的内部机制。修复手段可以是修改有问题的训练环境、进行精准的权重编辑,或重新训练模型。例如,团队可以对数据集运行预测性数据调试,在训练开始前就标记出它会教给模型什么。随着时间推移,这些工具让团队在部署前对模型的安全性有更深入的理解。
设计
更深层的目标是打造从设计上就安全的模型。随着我们洞察模型内部的能力不断提升,我们可以在训练之前或训练过程中预测某个“课程”会强化什么,并加以干预来塑造其学习方向。检测奖励黑客行为至关重要,但更深层的目标是训练出从一开始就不作弊的模型。这是我们希望在模型训练中看到的更广泛范式转变的基础——从自然生长转向有意图的塑造。
可解释性乐观的理由
对这一计划常见的反对意见在于速度。模型正以惊人的速度进步。如果可解释性的进展跟不上怎么办?
没有任何保证;科学对不确定性并不陌生。但过去几年、尤其是过去一年的证据,让我们有理由保持乐观——我们相信,可解释性正处在一场剧烈加速的前夜。
模型拥有丰富的内部结构
我们解读模型的能力,取决于模型是否具有结构化的内部表征。早期关于可解释性的许多悲观情绪,源于一些证据表明模型并不能干净地表示概念。
我们的经验恰恰相反。我们所到之处皆能发现结构,从生物学到机器人学再到大语言模型,跨越各种模态。研究者发现,当模型从提示中的示例学习一项任务时,少数几个注意力头会将这项任务压缩成一个单一的功能向量——一种可移植、自包含的表征,当它被加到新情境下模型的激活中时,便能执行同一任务。我们在块稀疏特征器上的工作,将概念还原为可解释的多维区域,而非单一方向;我们的神经几何工作则表明,这些区域呈现出丰富的几何形状,映照着这个世界。
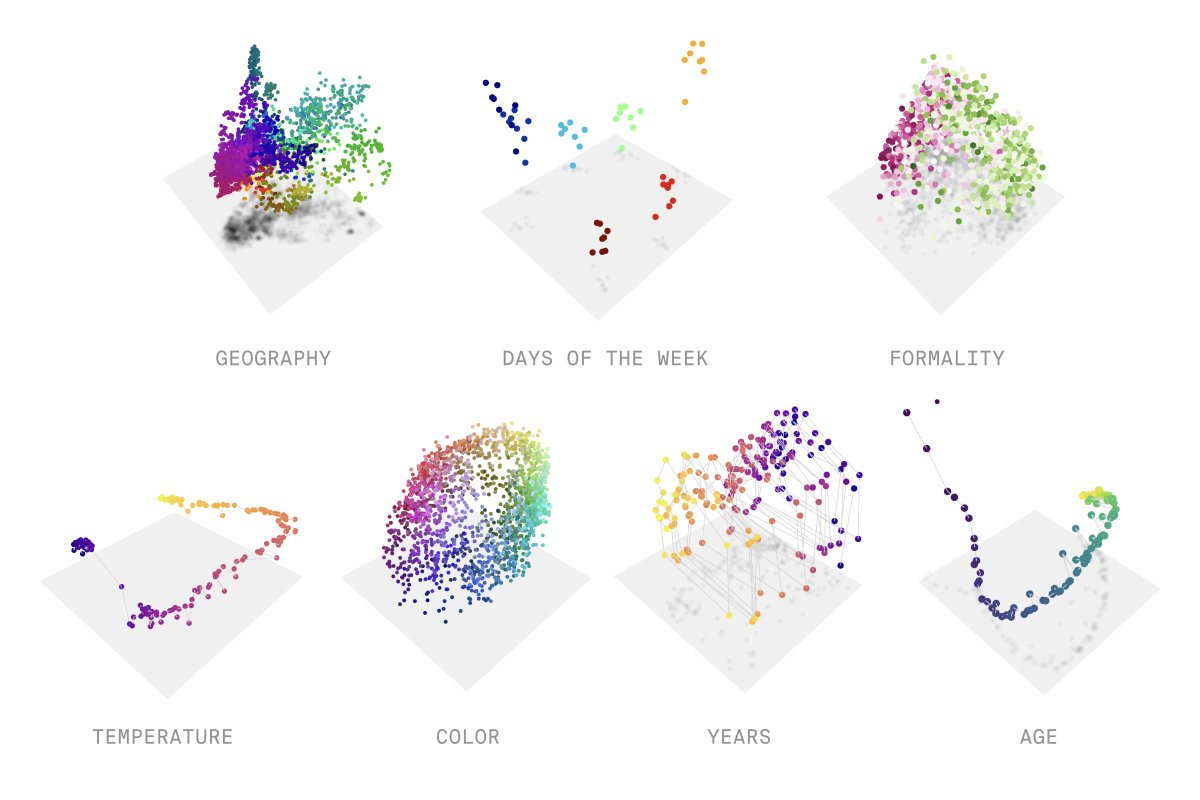
事后看来,这是很直观的。为了良好运作,模型需要保持思路清晰。训练会给模型施加很强的压力,促使它们高效利用参数,这使它们倾向于采用结构化表示,并在相关任务之间共享,从而实现组合与泛化。神经网络在融合各种想法时展现出美妙的复杂性,而在理解这些想法时往往又美得出奇简单。这种简单性让它们易于理解。
更大的模型拥有更清晰的结构
另一种担忧是,模型随着规模扩大而变得更加难以理解。但相反,我们观察到,更大、能力更强的模型拥有更清晰的表示。研究人员发现,更大的模型比更小的模型更清晰地表示真伪、空间和时间等概念。我们的研究人员已经表明,更大的模型能更快地学会执行任务所需的概念,而某些概念可能只有更大的模型才能学会。
AI 智能体正在加速可解释性研究
可解释性也格外适合由智能体驱动的加速。与生物大脑不同,我们能够完全访问这些新的数字心智。我们可以记录它们的内部活动、更改单个组件,并完全在软件中运行实验。
我们还可以验证结果。如果我们假设某种表征与奖励黑客行为相关,我们可以观察它何时被激活、对它进行干预,并衡量这种干预如何影响模型行为。完全访问、并行实验和可验证的结果,是研究智能体的理想条件。这些也正是我们致力于完全逆向工程一个语言模型的原因。
结语
可解释性与对齐是难题,需要众多个人、团队和组织持续不断的努力才能解决。它们将需要我们今天无法预见的巧思与突破。
它们也将需要信念。
技术史上最艰难的问题,都需要雄心勃勃的人们凭借才华与坚持,去攻克从未有人做过的事情。阿波罗计划依靠大约 40 万名工作者,在无人知晓如何做到之前,就相信我们能把人送上月球。对齐感觉也是一项同样艰巨的任务。我依然乐观地认为,我们能够也将会解决可解释性与技术对齐问题。Goodfire 有意帮助引领这条道路,但这些是极其艰难的难题,绝非一家公司、一种方法或一个学派所能解决。
专注的科学努力已为 AI 的能力带来了令人难以置信的进步。我们需要同等程度的雄心,致力于构建我们可以信任的超级智能。
致谢
感谢 Goodfire 团队提供的想法与讨论,它们塑造了本文,尤其感谢 Tom McGrath 和 Daniel Balsam 的关键见解,以及 Danielle Zhang 和 Tucker Fross 在起草过程中的帮助。
参考文献
- An Alien Mind [链接]
Jakub Pachocki,2026。OpenAI。
- OpenAI Cancels Release of New AI Model Over Safety Concerns [链接]
《华尔街日报》,2026。
- White House Releases Accord Between Billionaire AI Execs—Here's What It Says [链接]
Sara Dorn,2026。《福布斯》。
- Generalization (learning) [链接]
维基百科。
- Models know when they're reward hacking — and we can catch them at scale [链接]
Leon Bergen 等,2026。
- Intentionally designing the future of AI [链接]
Thomas McGrath,2026。
- Predictive Data Debugging: Reveal and Shape What Your Model Learns, Before You Train [链接]
Leon Bergen 等,2026。
- Features as Rewards: Using Interpretability to Reduce Hallucinations [链接]
Aaditya Prasad 等,2026。
- How to build fast, efficient monitors for AI models using probes [链接]
Goodfire,2026。
- The case for reasoning transparency [链接]
Rohin Shah 和 Anca Dragan,2026。Google DeepMind。
- 可解释性的紧迫性 [链接]
Dario Amodei,2025。Anthropic。
- 大型语言模型中的函数向量 [链接]
Eric Todd 等,2023。ICLR 2024。
- 用块稀疏特征器揭示视觉模型中的神经几何 [链接]
Thomas Fel 等,2026。
- 神经网络内部的世界 [链接]
Atticus Geiger 等,2026。
- 真理的几何:大型语言模型对真/假数据集表征中的涌现线性结构 [链接]
Samuel Marks 和 Max Tegmark,2023。COLM 2024。
- 语言模型表征空间与时间 [链接]
Wes Gurnee 和 Max Tegmark,2023。arXiv。
- 为何更大的模型学得更多:容量、干扰与稀有任务保留的影响 [链接]
Jing Huang、Daniel Wurgaft 等,2026。arXiv。