
用 Jev 构建执行框架
Jev 不生成文本,专做快速结构化分类决策,推理快至 200 倍、成本低至 400 倍,与 LLM 分工驱动智能体。

智能体在一个循环中运行:LLM 决定做什么,工具执行,模型评估结果,然后继续这一循环,直到任务完成。
智能体和 LLM 最初很难集成到软件应用中,因为软件应用依赖结构化数据和可预测的接口。后来出现了两个原语,让这件事变得容易得多:
但即便有了这些,智能体循环依然缓慢且昂贵:每一次决策都需要再调用一次模型。
于是,Jev 登场了。Jev 是 TypeSafe AI 发布的一款新模型。该公司报告称,在分类任务上,其推理速度最高可提升 200 倍,成本降低 400 倍,优于同类 LLM。
本文将介绍 Jev 的工作原理、它在智能体循环中的定位,以及如何配合 LangChain 使用它。
关于 Jev 的一切
Jev 其实不是传统意义上的 LLM,它不生成文本。它是 TypeSafe AI 团队所称的 System One 模型:
📖 System One 模型是一类 AI 模型,旨在做出快速、结构化的决策,供软件直接使用。System One 模型会评估一个 状态,并返回带类型的答案和概率。
它使用用于校准决策的强化学习(RLCD)进行训练。你的代码利用这些结果来指导智能体下一步做什么,而无需为每个决策都调用完整的聊天 LLM。
要调用 Jev 模型,你需要向它发送一个状态(即上下文)以及关于该状态的问题。下面是其文档中支持工单示例的单问题版本:
{
  "model": "jev-latest",
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "questions": {
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
文档中的示例给出了这样的紧急程度答案,此处省略了响应的其余部分:
{
  "is_urgent": {
    "type": "noul",
    "noul": 0.999
  }
}
这表示该消息有 99.9% 的概率是紧急的,你的应用程序可以据此对工单进行优先级排序。
支持三种类型的问题:
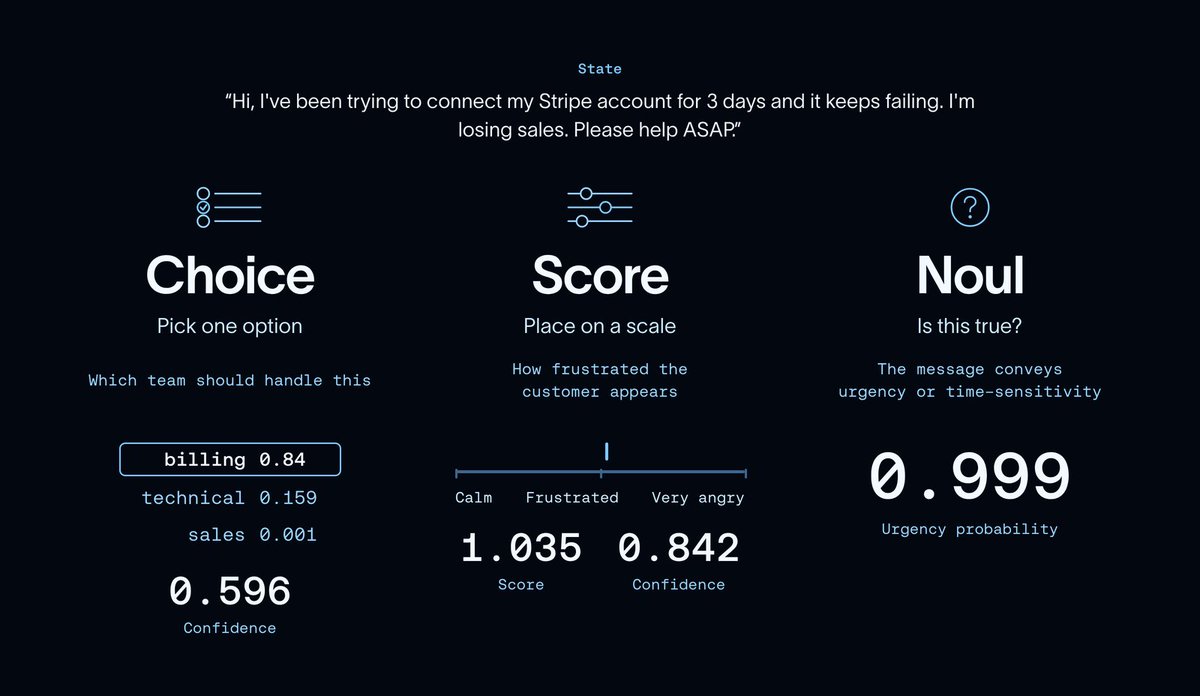
- 选择(Choice): 从一组选项中挑选。为每个选项返回一个概率,以及一个整体置信度分数。
- 评分(Score): 按照有序等级对输入进行评分,例如低、中、高。返回一个连续分数、底层分布以及一个置信度值。
- Noul: 回答一个是非题。返回某个陈述为真的概率。
这里的一个关键特性是,你可以在一次请求中针对同一状态提出多个问题。
💡 System One 模型会并行评估一次请求中的每个问题。增加问题几乎不会改变响应时间,只会消耗额外问题对应的 token,而这些 token 很便宜。
关于针对一张支持工单提出多个问题的示例,请参阅 TypeSafe 快速入门。
总之,与传统 LLM 不同,Jev 既不受文本生成的限制,也不受顺序决策的限制!
如何将 Jev 与 LangChain 配合使用
LangChain 的提供商无关模型非常适合在支持 Jev 的同时,兼容数千种其他集成和模型提供商。
LangChain 集成通过 TypeSafeClassifier 暴露 Jev。你将状态和问题传给 .invoke(),得到的是分类结果,而不是聊天响应。
安装 langchain-typesafe 并设置你的 TYPESAFE_API_KEY,然后发起调用:
from langchain_typesafe import Noul, TypeSafeClassifier

classifier = TypeSafeClassifier()

response = classifier.invoke(
    state=(
        "The deploy failed twice and customers are seeing 500s. "
        "Can someone look now?"
    ),
    questions={
        "urgent": Noul(
            instructions="Does this need attention right now?"
        ),
    },
)

urgency = response.nouls["urgent"].noul
状态可以是文本、结构化数据或 LangChain 消息。这样一来,使用你的 agent 已有的上下文,从节点或中间件钩子中调用 Jev 就变得非常简单。
你可以把它构建到自定义中间件或工具中!
使用场景
Jev 并不是 LLM 的即插即用替代品。它不生成文本,但能处理我们如今常用 LLM 完成的分类任务,且没有同样的延迟和成本。这使它成为驱动你智能体的模型的有力补充:用 LLM 进行开放式推理和生成,用 Jev 在过程中做快速、结构化的决策。
模型路由
一个简单的查询不需要和困难的调试任务使用同一个模型。模型路由中间件让 Jev 评估请求,并根据你定义的标准选择模型,从而让简单任务用快速且低成本的模型,复杂任务用能力更强的模型。
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
    ModelChoice,
    ModelRouterMiddleware,
)

router = ModelRouterMiddleware(
    choices={
        "fast": ModelChoice(
            model="openai:luna",
            criteria="Direct lookups, extraction, and localized changes.",
        ),
        "powerful": ModelChoice(
            model="openai:sol",
            criteria="Architecture and high-stakes decisions.",
        ),
    },
    instructions="Choose the least costly model that can complete the task.",
)

agent = create_agent("openai:gpt-5.6-luna", middleware=[router])
路由器从最新的用户消息中选择一个模型,并在整个运行过程中使用它。概率和置信度同样保留在智能体状态中。
自动模式
智能体本质上仍然不值得信任。智能体可能接收到糟糕的指令(无论是自然产生的,还是来自一个足够有动机的攻击者),这些指令可能说服它采取我们并不希望它采取的行动。
像 claude、codex、cursor 这样的编码工具链已经推出了某种方式,在危险操作被采取之前对其进行分类,这逐渐帮助建立了对智能体的信任。到目前为止,这个分类器步骤一直被锁在工具链的闭源部分中。
既然现在已经有了一个廉价且高性能的分类器模型,我们就可以采用同样的模式,并将其应用到所有智能体上!
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
    AutoModeMiddleware,
)

guardrail = AutoModeMiddleware(tools=["bash"])

agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])
AutoModeMiddleware 使用 Jev 检查工具调用中可能采取的冒险决策,并在工具执行之前阻止这些调用。
开始使用!
我们对 Jev 以及它带来的各种可能性感到非常兴奋。我们已经看到了一些很酷的项目:Browserbase 的 Kyle Jeong 正以极低的成本驱动浏览器使用代理,Jarrod Watts 构建了一个实时交易代理,而 Ryan Vogel 正在大规模地进行邮件分类处理。
如今几乎每周都有新模型发布,但这一款的反响格外热烈。我们很期待看到你用 LangChain 和 Jev 构建出什么。
欢迎在论坛上告诉我们你的想法,在 X 上标记我们并分享你正在构建的东西,或者参与 LangChain issues 的讨论!
致谢
感谢 @huntlovell、@hwchase、@ccurme、@veryboldbagel 和 Nathan Drenzer 的悉心审阅与贡献。