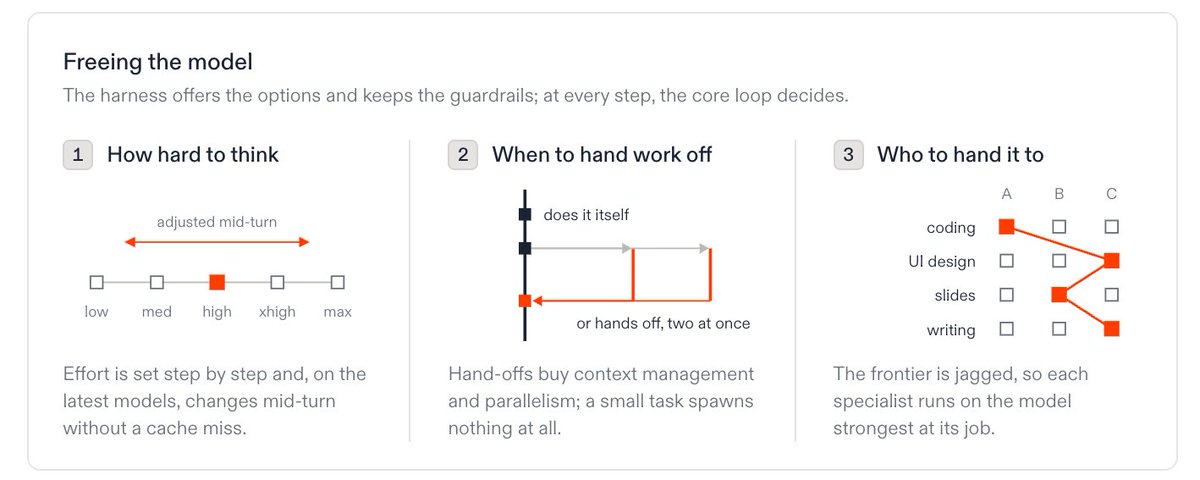
解放模型:前沿的驾驭设计
Replit Agent 抛弃模型路由器,让核心循环自主选择子代理的层级与投入,在两项基准上同时赢得成本与得分。

模型路由器如今无处不在,但它们有一个根本性的局限。无论基于高级启发式规则,还是基于一个读取每轮对话并挑选使用哪个 LLM 的小模型,路由器的能力始终不如它所选择的模型。Replit Agent 则让模型自己来做决定。
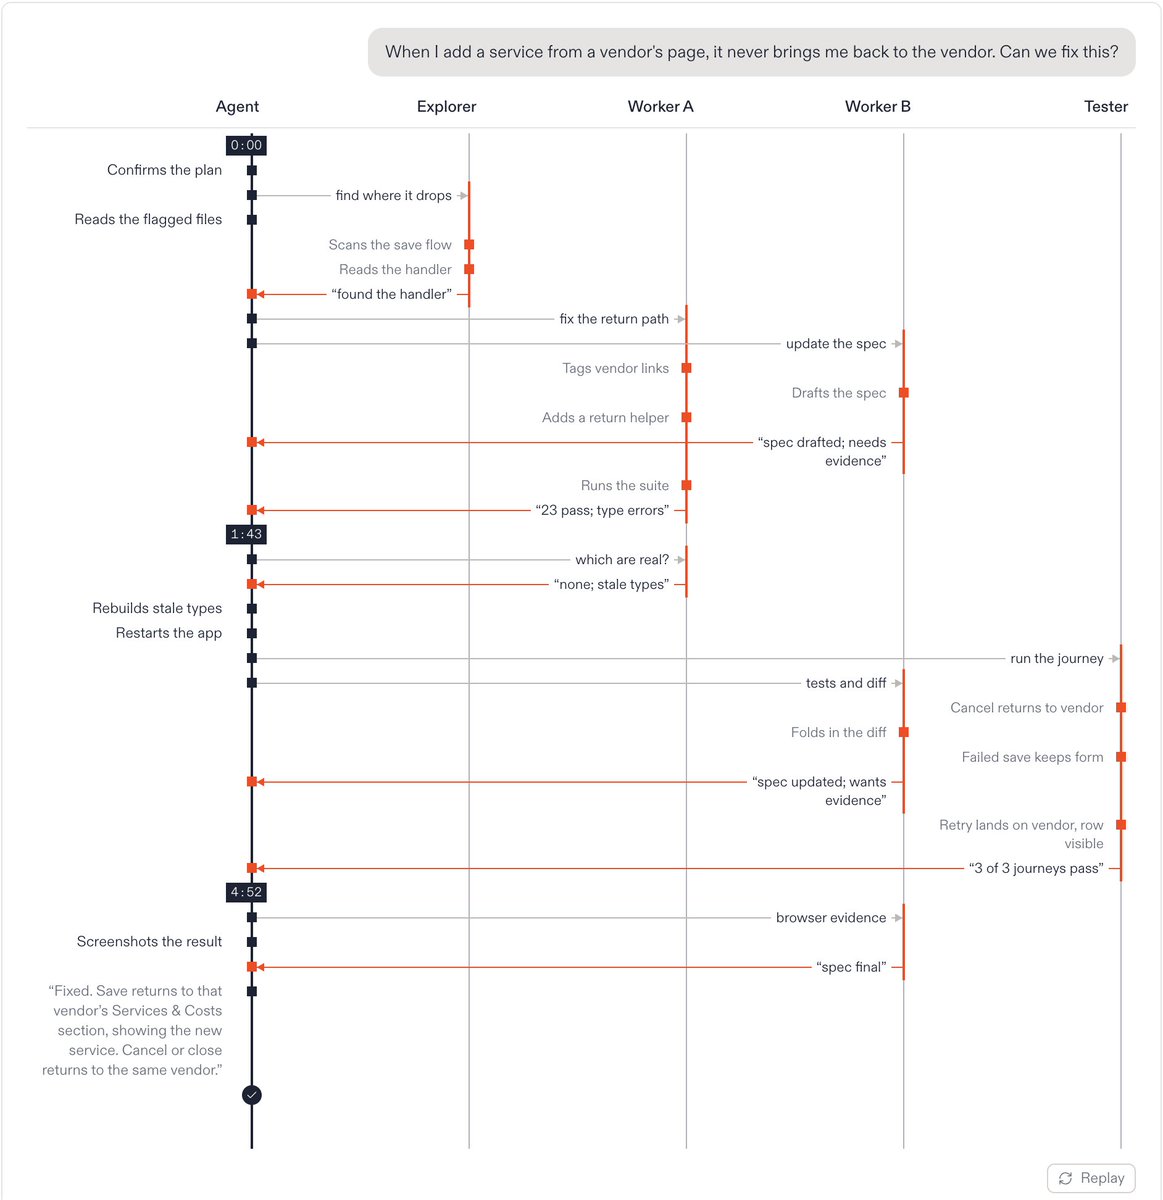
主智能体,也就是核心循环,会选择其子智能体的层级和投入程度,并随着任务推进调整自身的层级和投入。有了这种自由,GPT-6 Astra 将常规实现交给成本更低的子智能体,并自行决定把 token 花在哪里才值得。在 DeepSWE 和 Terminal-Bench 上,Replit Agent 相对单独的 Astra 都达到了帕累托最优:没有任何已发布的 Astra 基线成本更低且得分更高。它还以 11 分和 16 分的优势击败了助手架构——即同样配置但只有一个长期存活的执行者。
如需包含动画和脚注的完整文章,请访问 https://replit.com/blog/free-the-models
为什么我们减少脚手架
每一次模型发布都会让工具层中固化的假设失效。
随着模型在长周期任务上越来越强,它们在工具层所需的脚手架也越来越少。在实践中,我们观察到它们会自行倾向于委派:使用子代理进行上下文管理和并行处理。近期的突破——其中包括 Navier–Stokes——部分就来自协调由前沿模型驱动的代理集群 1。
但前沿是参差不齐的。最强的编程模型未必最擅长设计 UI 或制作幻灯片,也未必最擅长写邮件。
因此我们设计工具层,让每个模型按自己的方式工作,同时保留它仍然需要的护栏,并以最低成本实现质量为目标。
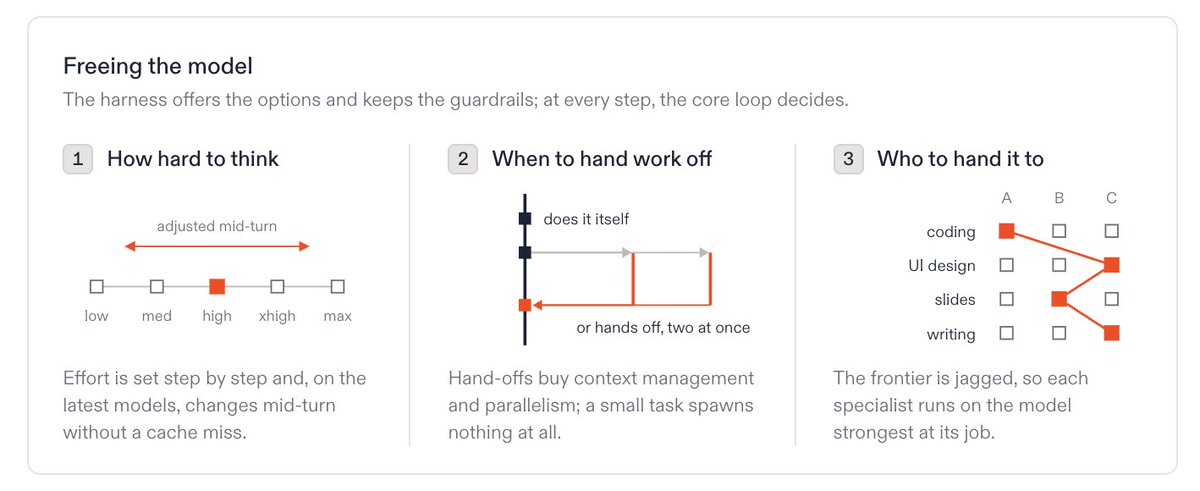
每一个新模型都会让我们回头重新检验那些曾坚信不疑的东西,并快速试验那些建立在涌现行为之上的技术。那么,解放模型,就意味着让它决定该思考多深、何时把工作交出去,以及交给谁。
用于委派的组合式原语
当我们开始试验 GPT-6 Astra 2 时,我们发现该模型很擅长委派。GPT-6 系列也是 OpenAI 首个支持在回合中途更改 effort 而不破坏缓存的产品。
为了利用这些能力,我们改进了四个 harness 原语。它们让核心循环在每一步都有一小组选择:派发什么样的子代理、以什么规模和 effort、是否回到已经交代过任务的某个子代理,以及思考得多用力:
- 领域感知子代理。 除了通用工作代理,harness 还提供专家代理:只读探索者、浏览器测试者、审查者,以及用于幻灯片和 UI 的设计子代理,每个都有自己的模型和工具。目前,harness 仍然决定存在哪些专家;核心循环决定何时以及如何使用它们。
- 子代理层级与 effort。 分为小、标准、大三档,每一档在成本和能力上都更进一步,并且档位内还有 effort 级别。两者都适用于每个子代理,核心循环在每次派发时选择它们。例如,机械式重命名交给低 effort 的小档,而为顽固 bug 生成假设则交给高 effort 的大档。
- 可复用子代理。 核心循环可以回到已经交代过任务的子代理,而不必从头开始。并不存在一个在整个会话期间保持存活的单一助手:任意数量的子代理会跨种类和层级保持热状态,由核心循环挑选唤醒哪一个。OpenAI 较新模型上更长的缓存生命周期降低了这样做的成本。
- 动态 effort 调优。 既然在某些模型上回合中途更改 effort 能保留缓存,我们训练了一个升级系统,它在每一步检查轨迹,并让 effort 与任务难度相匹配。与路由器不同,它会针对正在进行的工作在回合中途采取行动,而不是对请求只行动一次。
Astra 和 Fable 5.1 的代码质量 3 也让我们减少了代码审查子代理的使用,而评估分数并未下降。我们此前从未在任何模型上见过这种水平的工程品质。
较新的模型会自行委派任务
像 Astra 和 Fable 这样的前沿模型每 token 成本更高,这让它们在更小的模型面前显得不划算。我们观察到,它们会自然地委派给成本更低的子代理,把自己的 token 留给真正需要它们来做的决策。
Replit Agent 从不强制核心循环生成子代理。表 1 展示了三个模型在生产环境中如何处理这一决策:
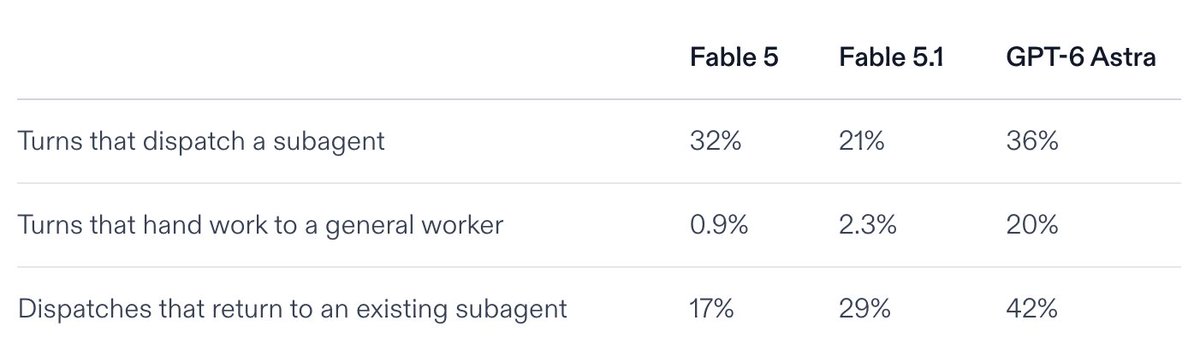
三个模型都会委派,但各有各的方式。在中等投入程度下,Fable 系列模型很少把工作交给通用工作代理:它们派出只读的探索者和审查者,把实现留给自己。Astra 是我们见到的第一个无需指示就会例行委派给通用工作代理的模型,而且一旦它向某个通用工作代理交代过任务,它往往会回头继续找它,而不是重新开始。这一回头率随着每一代模型都在上升。
结果
我们在两个软件工程基准测试上评估了 Max 模式下的 Replit Agent——这是我们质量最高的设置,以 Astra 作为核心循环:DeepSWE 和 Terminal-Bench。我们与两个基线进行比较:一是 Astra 单独运行于 mini-swe-agent 中,即各排行榜上公布的结果;二是 sidekick 架构,配置相同,仅做一处改动:将其子代理原语替换为单个长期存活的 worker。每张图都以得分为纵轴、每任务成本为横轴,因此最高效的配置位于左上方。
在 DeepSWE v1.1 4 上——该基准测试考察对活跃开源仓库的长周期改动——Replit Agent 得分为 72%,每任务成本 $2.11。Astra 在 mini-swe-agent 中以低 effort 运行得分为 67%,成本 $1.60;以 xhigh effort 运行得分为 74%,成本 $4.43;sidekick 架构得分为 61%,成本 $1.34。Terminal-Bench 4.0 5 考察完全在 shell 中完成的多步骤工作。Replit Agent 达到 49%,每任务成本 $2.53;相比之下,Astra 在低 effort 下为 42%、成本 $2.25,在 xhigh 下为 60%、成本 $5.86。sidekick 架构则为 33%,成本 $1.84。
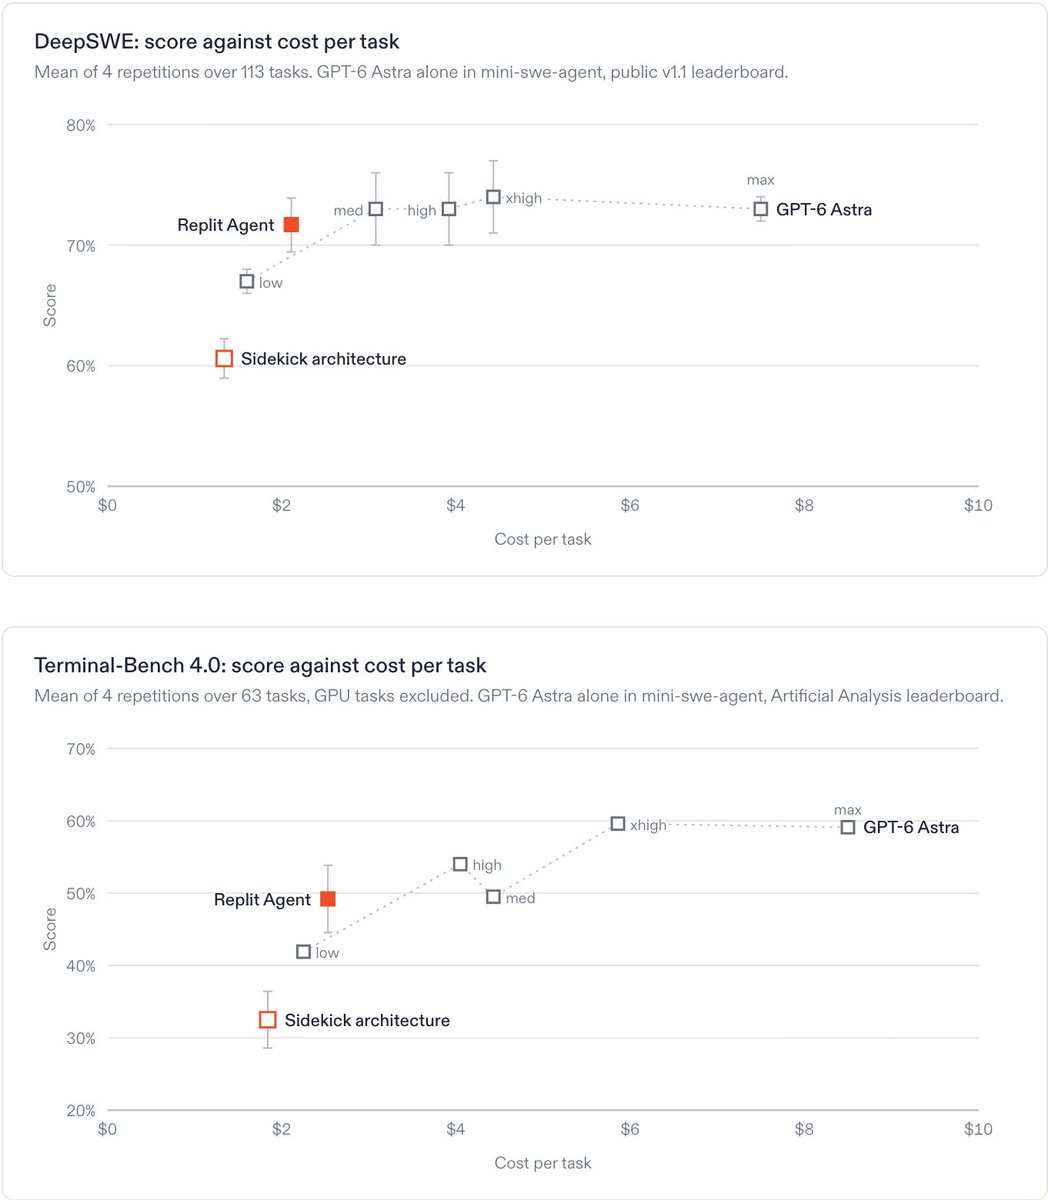
Replit Agent 在两个基准测试上都击败了 sidekick 架构,分别高出 11 分和 16 分。sidekick 成本更低,但为此放弃了六分之一到三分之一的得分。Astra 单独运行只有在花费更多时才能取得更高分数:其最佳设置比 Replit Agent 高出 2 分和 11 分,但成本超过两倍。两个基线都无法在成本和得分上同时取胜。我们完全按照向用户交付的方式运行 Replit Agent,未对提示词或测试框架做任何改动。
编排设计的苦涩教训
我们将这些结果视为萨顿苦涩教训的一个实例 6。将人类知识硬编码进智能体在短期内有所帮助,但长期来看会陷入停滞,最终被随计算规模扩展的通用方法所超越。僵化的编排迫使模型只能以一种方式工作;可组合的编排则让它自行选择。模型越聪明,编排就越不该替它做决定。
与规定性更强的架构相比,这种方法为我们带来了三点好处:
- 它押注于模型扩展定律。 依赖模型自身品味的委派方式会随着每一次发布而改进。下一代模型的早期预览延续了这一趋势。
- 它贴合任务。 小任务不派生任何子智能体,搜索任务派生一个探索者,而当构建工作分解为独立部分时则派生一个团队。
- 它复用而不持久化。 子智能体会保留其上下文,以备模型想要取回;除非模型这么做,否则什么都不会持久保留。
用萨顿的话说,编排应当让模型去发现如何执行工作,而不是规定我们会怎么做。解放模型吧。
致谢
本文由 Daniel Furman、Jacky Zhao、Vaibhav Kumar、Ed Sioufi 和 Michele Catasta 撰写。感谢 James Austin、Toby Ho、Preeya Kirani、Zhen Li、Robin Newhouse、Devanshu Sen Pandey、Ibrahim Sheikh、Samuel Spitz、Peter Zhong 以及 Replit AI 团队的其他成员对这项工作的贡献。如果你想在 Replit 从事 AI 方面的工作,我的团队正在招聘;请联系 pirroh@repl.it。