
重塑深度智能体中的技能
Deep Agents 为 Agent Skills 加入工具绑定、技能固定与线程中途重载,让数千技能库可规模化且不挤占上下文。

技能是为智能体赋予领域知识的最佳方式之一。一个技能就是一个包含指令、脚本和参考文件的文件夹,它教会智能体如何做事,比如按照你们销售团队的方式准备客户会议或审阅通话记录。Agent Skills 是一项开放标准,适用于任何模型,并受到数十种智能体产品的支持。你也不需要具备技术背景就能编写一个技能:从本质上讲,技能就是一个 markdown 文件。
技能之所以有效,是因为渐进式披露。智能体一开始只能看到每个技能的名称和描述,只有当任务需要时才会读取完整的指令。这样可以让上下文保持精简,而上下文工程正是构建高效智能体的关键。
随着使用规模不断扩大,团队对技能的需求也在发生变化。我们看到企业技能注册表已增长到数千个技能,在团队和智能体之间共享。我们改进了 Deep Agents 中的技能支持,以回应一些常见需求:
- 将工具绑定到技能: 绑定到某个技能的工具只有在智能体读取该技能时才会加载。
- 固定技能: 当用户明确请求某个技能时,比如 /meeting-prep,你的应用可以在下一次模型调用之前加载它。
- 技能重新加载: 长时间运行的线程可以获取新增或变更的技能,而无需重新开始。
技能如何运作
一个技能就是一个包含 SKILL.md 文件的目录:YAML frontmatter 中有 name 和 description,后面是 agent 遵循的指令。一个技能还可以在 scripts/、references/ 和 assets/ 下捆绑支持文件(规范)。

只有技能的 name 和 description 始终在上下文中。agent 按需读取指令,仅在需要时才加载 scripts、references 和 assets。
在本文中,我们将以我们的 GTM agent 作为贯穿始终的示例。它构建于 Deep Agents 之上,其包含 50 多个技能的库覆盖了销售代表的日常工作,例如 meeting-prep、call-transcripts 和 competitive-intel-card。
- 发现。 启动时,agent 在其系统提示中看到每个技能的 name 和 description。
- 激活。 当任务匹配某个技能时,agent 用 read_file 读取完整的 SKILL.md。
- 执行。 agent 遵循指令,仅在需要时才读取 scripts 或 reference 文件。
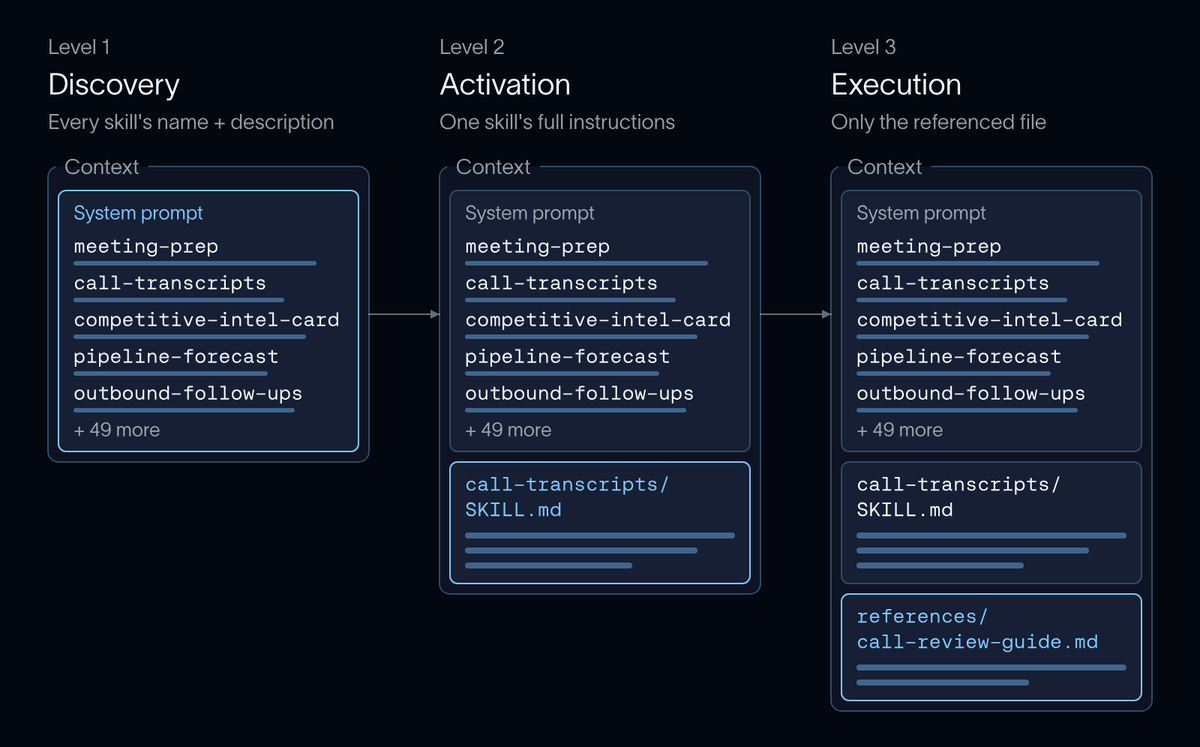
agent 的上下文只随任务所需而增长:启动时是每个技能的 name 和 description,然后是一个技能的指令,再然后是一个 reference 文件。
在技能被使用之前,它只占用系统提示中的一行,因此一个技能库可以容纳大量技能的引用,而不会挤占上下文。现在,让我们来看看我们在 Deep Agents 中做出的增强。
将工具绑定到技能
技能通常会告诉智能体如何使用特定的工具,而有些工具只有在智能体阅读了这些说明之后才能很好地工作。在此之前,技能和工具是分别披露的。你可以通过工具搜索将工具 schema 排除在上下文之外,但没有任何机制将工具与解释它的技能绑定在一起:智能体可能找到并调用某个工具,却没有阅读它的技能;或者阅读了技能,却仍然不得不去搜索它的工具。
现在你可以将工具绑定到技能,这样技能及其工具就会一起披露。绑定的工具在智能体阅读其技能之前不会被加入上下文,在此之前调用它会因工具未知而失败。这既保持了上下文的精简,也意味着智能体在能够调用某个工具之前,已经阅读了如何使用它。在我们的 GTM 智能体中,call-transcripts 说明了如何搜索通话和阅读转录文本,因此它是绑定这些工具的天然位置。
在技能 frontmatter 的 metadata.include_tools 下列出这些工具:
name: call-transcripts
description: Find and read customer call transcripts. Use when a rep asks what was said on a call or needs context from past conversations.
metadata:
  include_tools: search_calls get_transcript
将这些工具传给 SkillsMiddleware,而不是传给智能体。在智能体阅读 call-transcripts 之前,它们会一直保持隐藏:
from deepagents import create_deep_agent
from deepagents.middleware import SkillsMiddleware

agent = create_deep_agent(
    model="anthropic:claude-sonnet-4-6",
    backend=backend,
    middleware=[
        SkillsMiddleware(
            backend=backend,
            sources=["/skills/"],
            tools=[search_calls, get_transcript],
        ),
    ],
)
读取调用记录会解锁 search_calls 和 get_transcript。它们会出现在一条新的系统消息中,因此其上方已缓存的前缀保持不变。
过去,在对话进行到一半时添加工具意味着要修改请求的工具列表,这会使提示缓存失效。Anthropic 和 OpenAI 现在允许较新的模型在对话中途接受工具,因此在这些模型上,Deep Agents 会在技能被读取后立即添加该技能绑定的工具,而已缓存的前缀保持不变(参见 Anthropic 和 OpenAI 集成文档)。在其他模型上,工具仍像以前一样追加到请求中。
一个列表就能覆盖大多数技能。若需要更多控制,技能可以列出一个标签而非工具名称,而你传给 SkillsMiddleware 的函数会将每个标签转换为工具。这样一来,你可以:
- 一次性披露整个工具组,比如某个 MCP 服务器上的所有工具,只需一个名称,而无需在技能中逐一列出每个工具。
- 根据运行时权限来限制工具。 该函数会接收图的运行时,因此它可以检查用户是谁,并只返回该用户被允许使用的工具。
在这里,call-transcripts 获得了 calls MCP 服务器上的所有工具,而 pipeline-forecast 获得了 CRM 工具,但只有经理才能更新预测:
# call-transcripts/SKILL.md
metadata:
  include_tools: call_tools

# pipeline-forecast/SKILL.md
metadata:
  include_tools: crm_tools
call_tools = await mcp_client.get_tools(server_name="calls")
def resolve_skill_tools(name: str, runtime: Runtime) -> list[BaseTool]:
if name == "call_tools":
return call_tools
if name == "crm_tools":
if "manager" in runtime.server_info.user.permissions:
return [get_pipeline, update_forecast]
return [get_pipeline]
return []
SkillsMiddleware(backend=backend, sources=["/skills/"], tools=resolve_skill_tools)更多内容(例如将一个名称映射到 MCP 服务器上的所有工具)请参见向技能添加工具。
固定技能
有时用户已经知道自己想要哪个技能。在我们的 GTM 智能体中,销售代表可以输入 /meeting-prep 来为明天的 Acme 通话做准备。如果不固定,模型只能看到技能的描述,必须去读取它。这会在工作开始前增加一次往返,而且模型并不保证会加载正确的技能。使用固定技能时,你的应用会在消息中找到技能名称(或从 UI 中解析),并将它们传入 pinned_skills,中间件会在下一次模型调用前将每个技能的指令添加到对话中。Deep Agents 不会自行解析消息,因此语法由你决定:

输入 /meeting-prep 即指定了该技能,因此应用可以为智能体的下一次模型调用固定它。
message = "/meeting-prep for my Acme call tomorrow"
pinned = re.findall(r"(?<!\S)/([a-z0-9-]+)", message)  # ["meeting-prep"]

agent.invoke(
    {"messages": [{"role": "user", "content": message}], "pinned_skills": pinned},
    config=config,
)
固定技能的指令已经在对话中,因此智能体在模型调用 1 时就开始工作,而不是等到模型调用 2。
这缩短了延迟,也让行为更可预测:指令保证在上下文中,固定技能绑定的工具也随之而来。每个固定技能都作为一条带标签的消息添加一次,因此更早的消息永远不会改变,提示缓存保持有效,聊天界面可以将该技能显示为一个标签,而不是它的全文。
在线程中途重新加载技能
技能在每个线程开始时加载,并保存在智能体状态中,因此之后的每一轮都会复用同一组技能。现在,你可以在调用智能体时将 skills_metadata 设为 None 来使这个列表失效。如果队友向库中添加了一个 competitive-intel-card 技能,应用程序可以选择使技能列表失效,下一次运行将重新扫描每个来源:
agent.invoke(
    {"messages": messages, "skills_metadata": None},
    config=config,
)
将 skills_metadata 设为 None 会让下一次运行重新扫描技能库,并拾取自上次运行以来新增的技能。
重新加载并发现新技能会改变系统提示词,从而使提示词缓存失效。对于闲置已久的线程,这一成本通常已经付过了:提供商的缓存通常在闲置几分钟到一小时后过期(Anthropic、OpenAI),所以当代表回来时,缓存已经冷了。
由于重置只是运行输入,你也可以把控制权交给用户。例如,客户端上的一个 /reload 命令:
payload = {"messages": [{"role": "user", "content": message}]}
if message.startswith("/reload"):
    payload["skills_metadata"] = None

agent.invoke(payload, config=config)
你也可以从 update_state 或中间件进行重置,这样你的应用就能控制技能重新加载的时机。参见重新加载技能。
开始使用
技能是为智能体提供有组织的领域知识的行业标准机制。这些更新让技能更容易大规模运行:工具仅在技能需要时才加载,工作流所需的技能会预先加载,长时间运行的线程会随着你的技能库变化而保持最新。而且由于技能是开放标准,你的团队编写的技能可跨模型和智能体使用。
所有这些都已在最新的 deepagents 中提供。阅读技能文档开始使用,并通过 GitHub issues、论坛或 X 告诉我们你的想法。
致谢
感谢 Rich Scarrott 主导开发这些新功能,感谢 Hunter Lovell 对功能及博客的审阅!