AI智能体如何使用硬件
AI智能体的真实硬件瓶颈不在生成速度,而在上下文保留、工具执行与工作环境对CPU/内存/存储/网络的持续占用。

过去几个晚上,我一直在翻阅关于编码智能体的论文以及API提供商的使用数据,想弄清楚AI智能体在编写代码、运行测试或完成研究任务时,是如何使用硬件的。
很多关于推理的讨论都聚焦于模型生成答案的速度,通常以每秒token数来衡量。这固然重要,但我同样关心其余时间花在了哪里:工作在哪里运行,模型调用之间什么留在内存中,以及智能体等待时发生了什么。
下面的大部分测量数据来自编码智能体研究,我在讨论时会附上链接。
智能体实际在做什么
一个编码智能体可能会编译项目并运行测试。一个研究智能体可能会抓取文档并处理它们。一个计算机使用智能体操作浏览器或桌面。有些智能体启动模拟,另一些则运行有助于训练模型的工作负载。
这些活动对硬件的要求可能截然不同。它们也会相互重叠。一项研究任务可能涉及代码,而一项编码任务可能启动GPU作业。
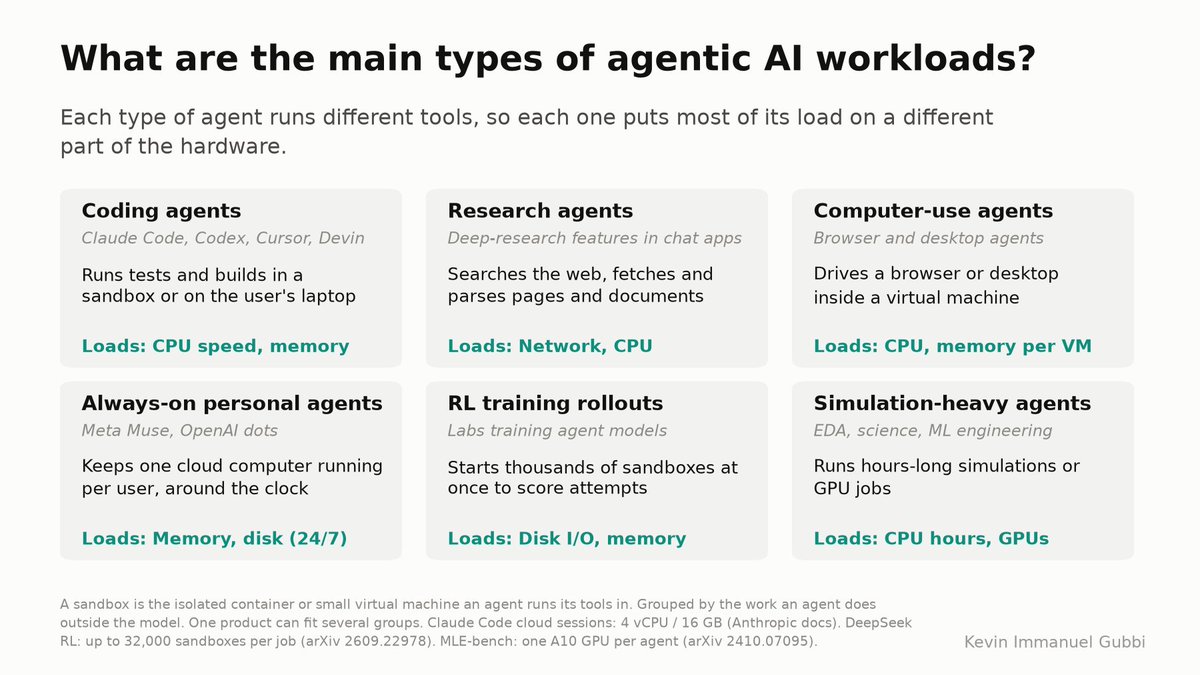
一项编码任务可能在完成之前多次将智能体送回模型。模型决定做什么,工具运行,结果成为下一次模型调用输入的一部分。随着智能体读取文件、修改代码并检查其工作,这一过程可能反复发生。
模型及其工具可以运行在不同的硬件上。在一种常见的配置中,GPU或其他AI加速器运行模型。CPU运行普通程序,如shell命令、构建工具和测试。磁盘和网络处理诸如读取项目文件和抓取文档之类的工作负载。
工具也可以使用 GPU,但前提是其软件支持 GPU 加速。普通程序并不会因为有了 GPU 就自动变快。NVIDIA 的编程模型
它们复用了多少上下文
模型以称为 token 的片段来处理文本。一个 token 可以是一个词、词的一部分,或一个标点。对于 Claude Code,TraceLab 报告的中位数是每步约 126K 个缓存输入 token 和 857 个未缓存输入 token。模型为了相对很小的一点新增内容,读取了大量已有的历史记录!
KV 缓存存储模型已经处理过的上下文中的注意力数据。复用这些数据可以避免从头处理相同的上下文。保存的数据仍然需要有地方存放,并且必须在模型再次需要它时可用。TraceLab
下图结合了对数据的两种不同视角。左侧的数字是 Claude Code 各自的单独中位数。右侧的百分比是整个 TraceLab 数据集中的 token 总量占比与估算成本占比。
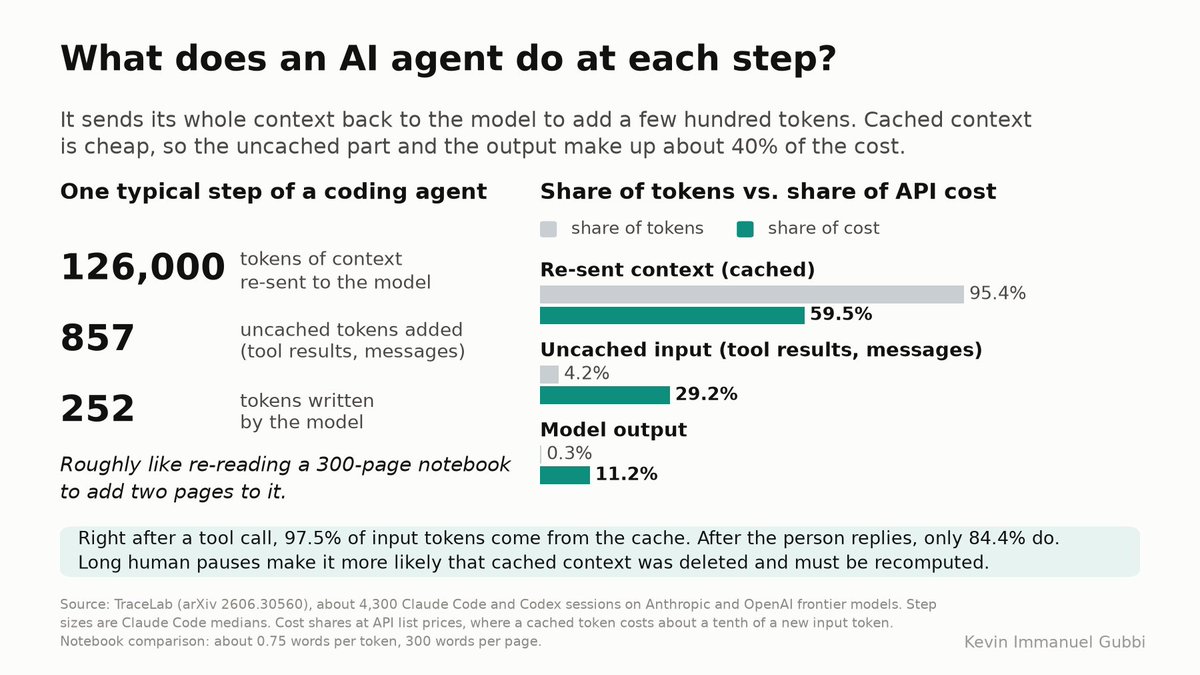
在 TraceLab 的数据中,缓存输入约占估算 API 账单的 60%。缓存 token 比新的输入 token 更便宜,但它们的数量如此之多,以至于仍然是最大的成本类别。
未缓存输入并不一定意味着新信息。该研究估计,只有约 19% 的追加输入是有价值的内容。其余大部分是在缓存未命中后不得不重新处理的已有上下文。
该图还显示,由工具结果触发的步骤上缓存复用率高于由人的下一条消息触发的步骤。TraceLab 发现,步骤之间的间隔越长,缓存未命中越多。
缓存复用避免了重复计算,但保留的状态仍会占用容量,并且在模型再次需要时必须被移动。TraceLab
时间花在了哪里
在 TraceLab 中,工具约占响应一个请求所花时间的 60%。这包括运行测试、构建代码和搜索信息等工作。工具总共花费的时间超过了模型生成。
在完整的记录会话中,请求之间的间隔约占经过时间的 92%。这些间隔包括人离开时仍保持打开的会话,因此不应全部被解读为主动阅读或思考。
工具持续时间也不均衡。相对少量的长时间运行调用占据了工具总时间的大部分。一个运行数分钟的测试或构建会让智能体的其余部分等待其结果。
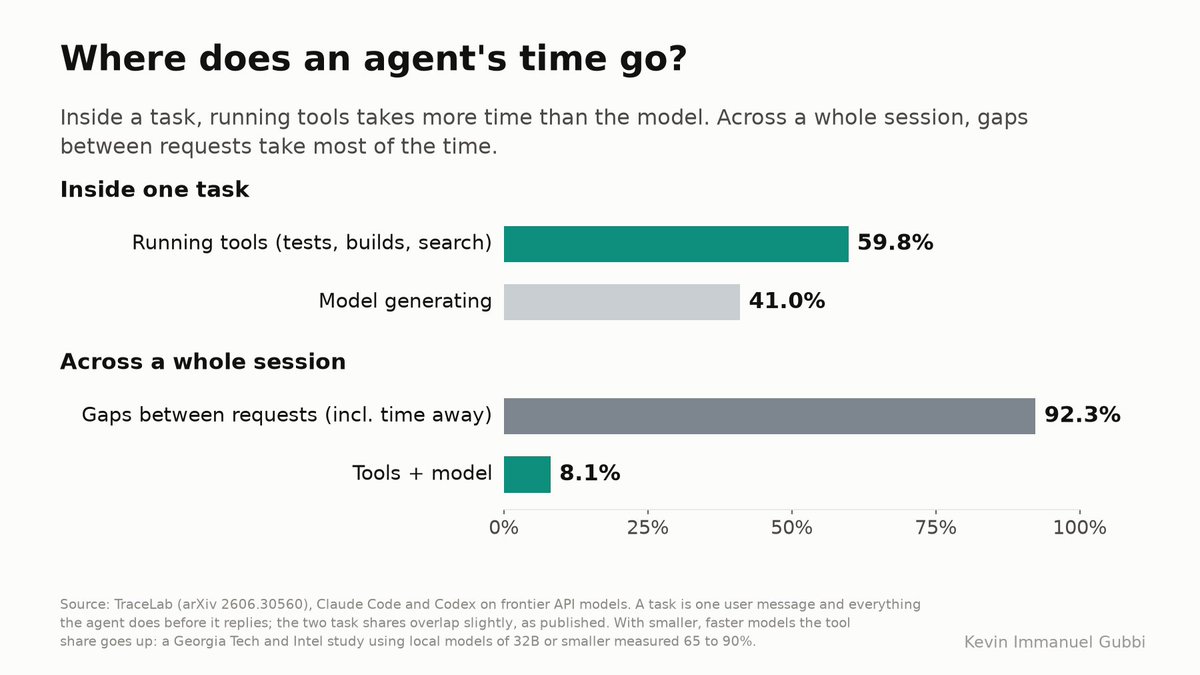
这些测量描述了两个不同的时段。工具时间是在智能体响应请求期间测量的。会话间隔测量的是请求之间的时间,并不能告诉我们当时人在做什么,也不能告诉我们提供方将缓存保留了多久。TraceLab
上下文占用多少内存
上下文所需的内存量随模型的注意力设计而有很大差异。
对于一条 126K token 的序列,根据已发布的模型配置所做的 BF16 缓存理论估算显示,Llama 3.1 405B 约为 65 GB,而 DeepSeek-V3 约为 9 GB。BF16 用两个字节存储每个值。
这些是跨模型所有层计算出的总量。它们不包括模型权重和实现开销,而且缓存也不一定非要放在一块 GPU 上。
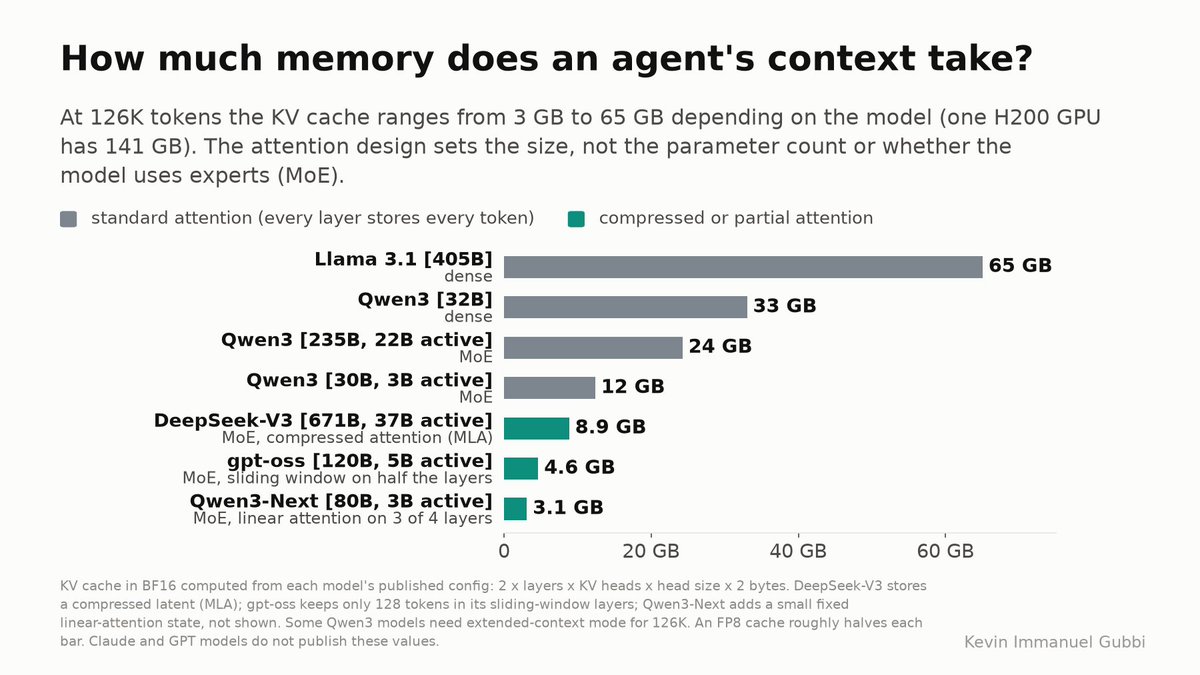
在这个比较中,更大的模型反而拥有更小的缓存。DeepSeek 存储的是一种压缩后的注意力表示,这减少了每个 token 所保留的状态。
混合专家是另一项独立的架构选择。它决定哪些专家网络参与某个 token 的计算。它本身并不会让注意力缓存变小。
当我审视推理硬件时,我想同时理解每个 token 所需的计算量,以及调用之间保留的状态。仅凭参数数量无法同时解释这两者。
步骤之间哪些资源保持占用
假设智能体运行一个测试,并且需要拿到结果才能继续。服务系统可以把智能体的缓存保留在 GPU 显存中,也可以把它移到系统内存或另一层存储,或者直接删除、之后再重建。
测试跑得更久,并不会让这份缓存变大。如果保留它,它占用容量的时间就更长。如果删除它,下一次模型调用可能不得不重新处理同一段历史。
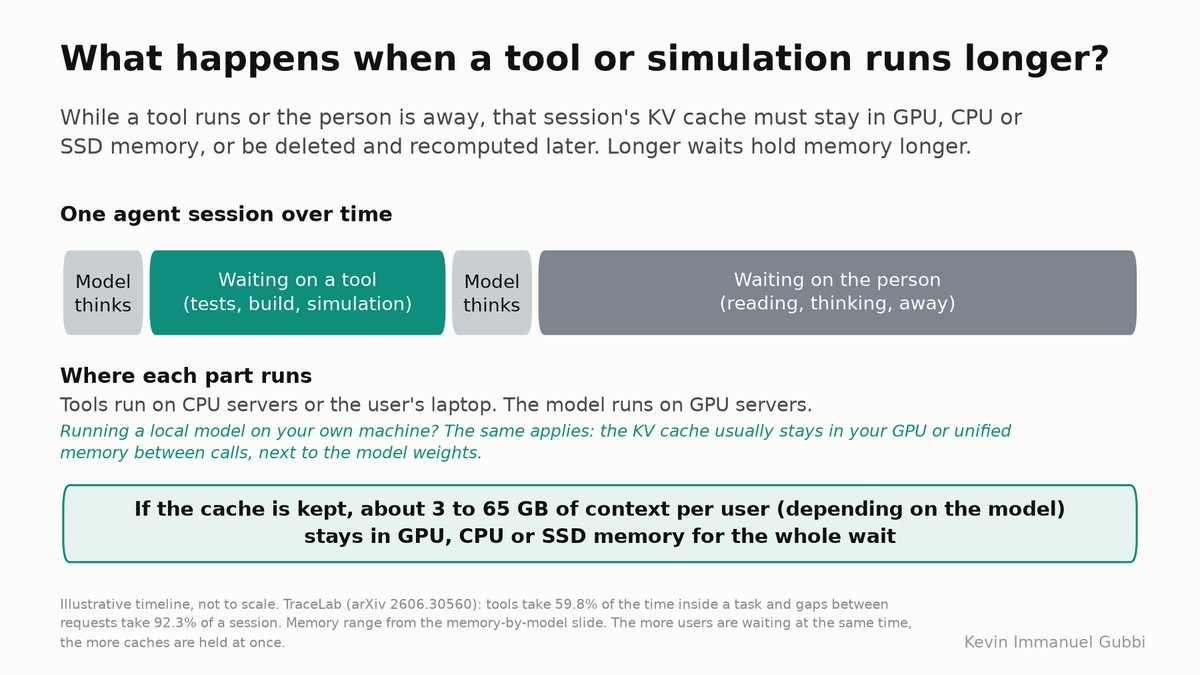
如果新任务以稳定速率持续到达,更长的工具调用可能让更多智能体同时处于等待状态。当系统在这些等待期间保留它们的缓存上下文时,就需要更多内存或存储容量来存放这些上下文。Continuum
智能体的工作环境需要什么
智能体还需要一个环境来运行它的代码。这可能是一个隔离容器,或一台小型虚拟机,里面包含任务所需的文件、程序和服务。论文通常把这种工作环境称为沙箱。
该环境使用的资源与模型的 KV 缓存相互独立。如果它在步骤之间保持可用,那么即使它几乎不做 CPU 工作,也可能继续占用内存。
DeepSeek 报告称,在一次强化学习部署中,并发环境超过 38 万个,智能体的尝试为训练提供了反馈。在其利用率样本中,大约每 10 个环境里有 9 个平均使用的 CPU 容量不超过其申请量的 5%。DeepSeek DSec
另一项名为 AgentCgroup 的研究发现,在其实验中,内存限制了可以同时运行的编码智能体环境数量。AgentCgroup
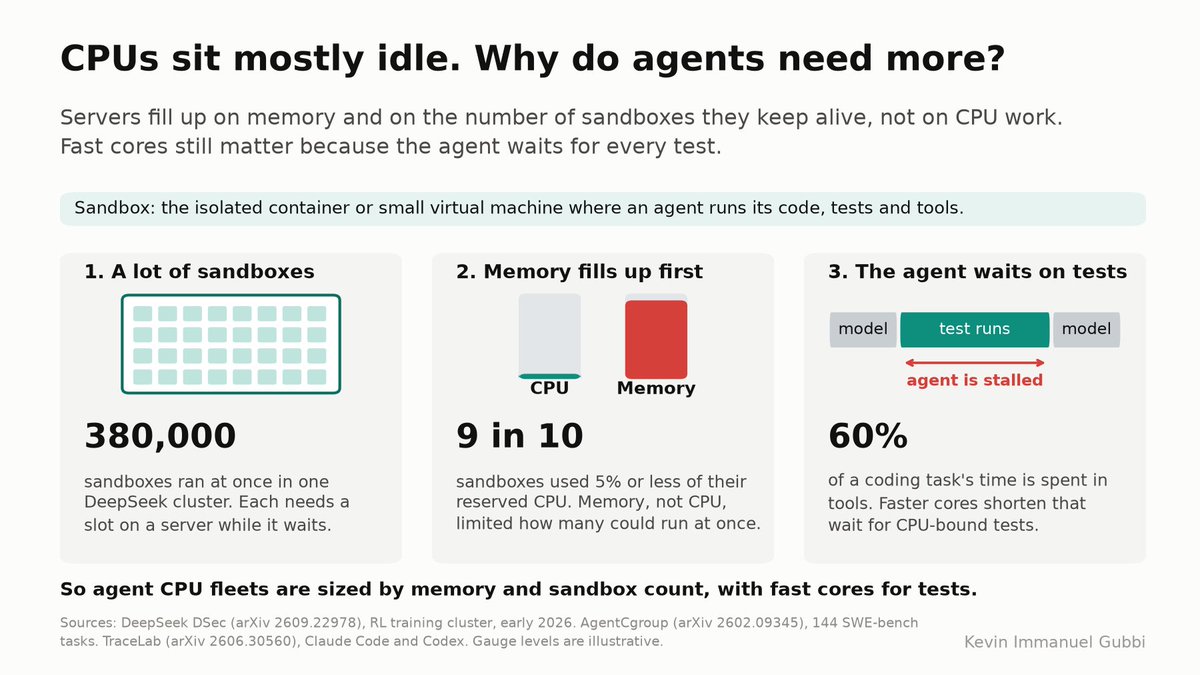
这些研究共同指向两个彼此独立的制约因素。内存及其他共享资源决定了同时能有多少个环境保持活跃。CPU 速度则决定了 CPU 密集型工具一旦开始运行后多快能完成。
如果智能体需要等待构建或测试的结果才能继续,那么更快完成这项工作也会缩短下一次模型调用前的等待时间。
这对硬件意味着什么
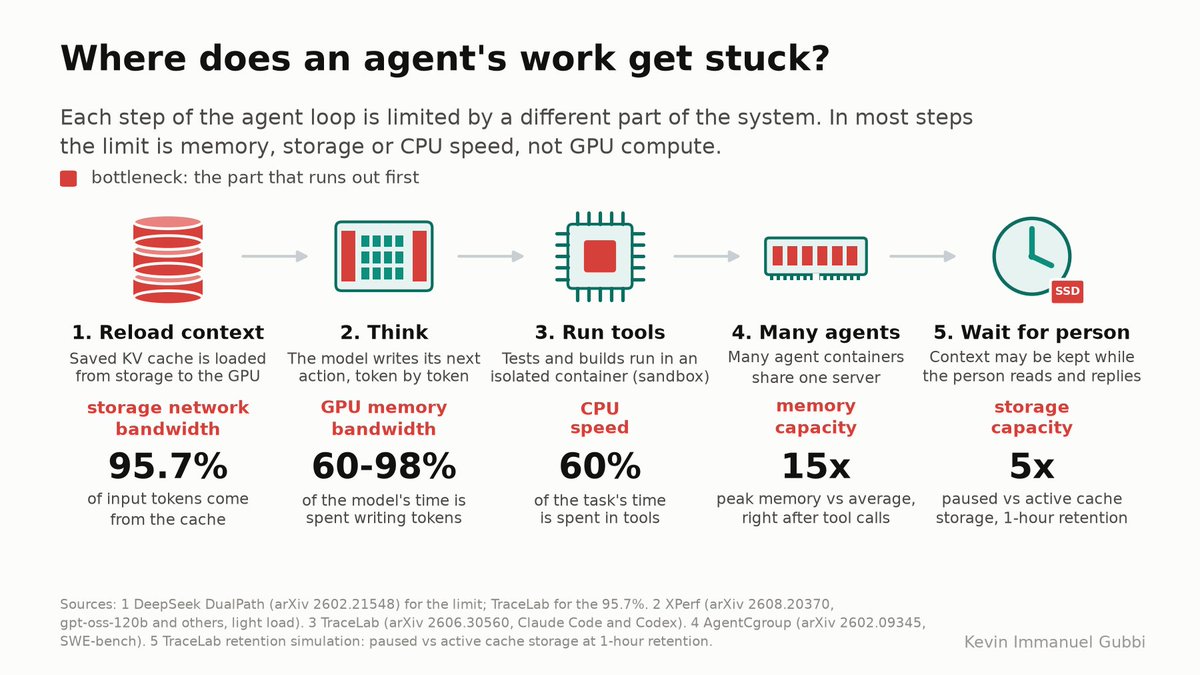
避免重复计算并不能消除硬件层面的工作。它只是将其中一部分工作转移到了上下文的保留与搬运上,而工具和工作环境本身也会对 CPU、内存、存储和网络提出各自的需求。
DeepSeek 的 DualPath 研究让这一问题的一个方面变得具体。其智能体轨迹的缓存命中率高达 98.7%,因此几乎不需要从头处理输入。但在研究者所评估的系统中,加载已保存的上下文使处理这些输入的机器上的存储网络连接达到了饱和。
作者改变了上下文在系统中的传输方式,利用那些尚有闲置带宽的连接。在他们的评估中,这使得每秒可服务的智能体运行次数几乎翻了一倍。缓存复用节省了计算,而更好的数据搬运则让系统得以利用这一节省。DualPath
我们已经看到一些设计将模型的工作拆分到不同的硬件上。AWS 和 Cerebras 宣布了一个系统,使用 Trainium 处理输入,然后用 Cerebras CS-3 生成响应。
NVIDIA 的 Rubin 与 Groq 3 LPX 设计将生成过程本身一分为二。Rubin 负责对已保存上下文执行注意力计算,而 LPX 则运行前馈网络,逐个处理每个 token。AWS 与 Cerebras 公告,NVIDIA 架构
软件同样影响着有多少工作会落到这些硬件上。一位 Hermes Agent 贡献者报告称,在做出让重复的系统提示词在消息之间保持一致的改动后,缓存复用率大幅提升。改变输入的组装方式使得更多已有上下文得以复用,从而减少了重新处理那段历史的需要。Hermes Agent 贡献者的测量结果
智能体软件将持续改变这些需求。例如,世界模型可能会在采取行动之前加入更多内部预测与比较。V-JEPA 2 论文
这一切让我对那些能出色完成特定任务的芯片架构格外感兴趣——它们同时为软件留出空间,去改变工作的划分方式。我很期待看到加速器、内存以及在整个系统中搬运上下文的连接技术方面出现下一批进展。