AI 工程师需要了解的 GPU 一切
理解GPU硬件差异后,租用前用「权重÷显存」判断能否装下、用「活跃权重÷带宽」判断跑多快,即可完成绝大多数AI部署决策。

GPU 内部有什么,训练和推理对它的用法有何不同,代际划分,你实际租到的是什么,NVIDIA 的竞争对手,以及在本地运行模型。
如果你用 AI 做开发,你每天都在用 GPU。但我们大多数人从不看硬件。我们管它叫 GPU,然后就不管了。
这在你需要做真正决策之前都没问题:该租哪块 GPU,为什么一个模型放得下而另一个会崩,或者为什么 H200 在纸面算力相同的情况下能胜过 H100。
本文按你实际接触硬件的顺序来讲,用两个真实开放权重模型的精确计算和真实价格。不需要硬件背景。
这两个模型:
- 来自 OpenAI 的 gpt-oss-120b:1170 亿参数,每 token 激活 51 亿。小到可以放进一块 GPU。
- 来自 Moonshot AI 的 Kimi K3:2.8 万亿参数,激活 1040 亿。2026 年最大的开放模型之一。
两者都是混合专家模型。每一层都包含许多小的专家网络,而每个 token 只经过其中少数几个:gpt-oss-120b 是 128 个中的 4 个,Kimi K3 是 896 个中的 16 个。所以有两个数字很重要。总参数决定你需要多少内存。激活参数决定每个 token 要花多少计算和数据搬运。
1. GPU 的种类
GPU 分为三种:
- 数据中心级: 机架式服务器,GPU 之间拥有高速互联。例如:NVIDIA B200。
- 工作站级: 面向专业桌面的一张大卡。例如:RTX Pro 6000。
- 个人级: 游戏 PC。例如:GeForce RTX 5090。
数据中心 GPU 运行在三种场所之一:云端(AWS、GCP,或 CoreWeave、Nebius 这类“新云”)、本地部署(公司自有的数据中心),或气隙隔离环境(本地部署且无外部网络)。
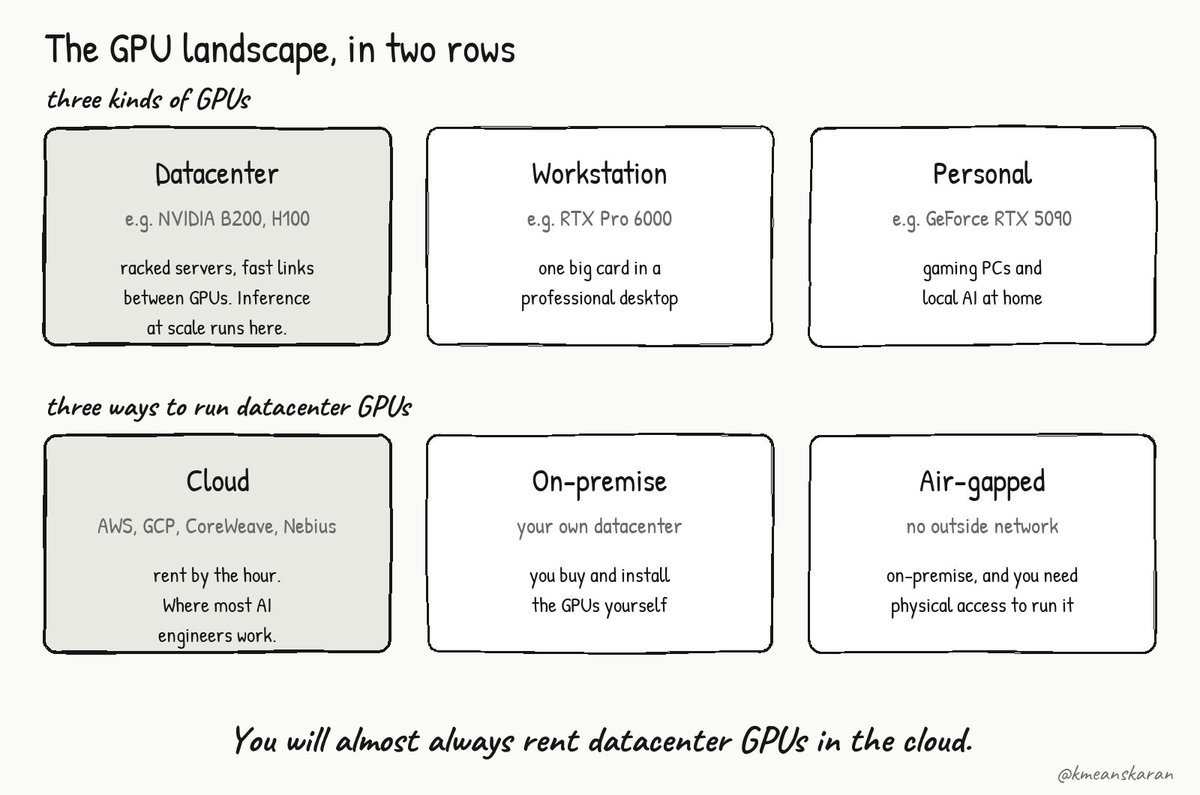
这对你意味着什么: 除非你在大型企业或政府机构工作,否则你会在云端租用数据中心 GPU。本文大部分内容讲的正是这些。
2. GPU 的内部
CPU 擅长一件接一件地处理复杂的事情。GPU 则是一台吞吐机器:它对成千上万个数字同时执行同一个简单运算。AI 主要是矩阵乘法,而这恰恰就是那类工作。
下面是拆掉散热器后的 H100 外观:
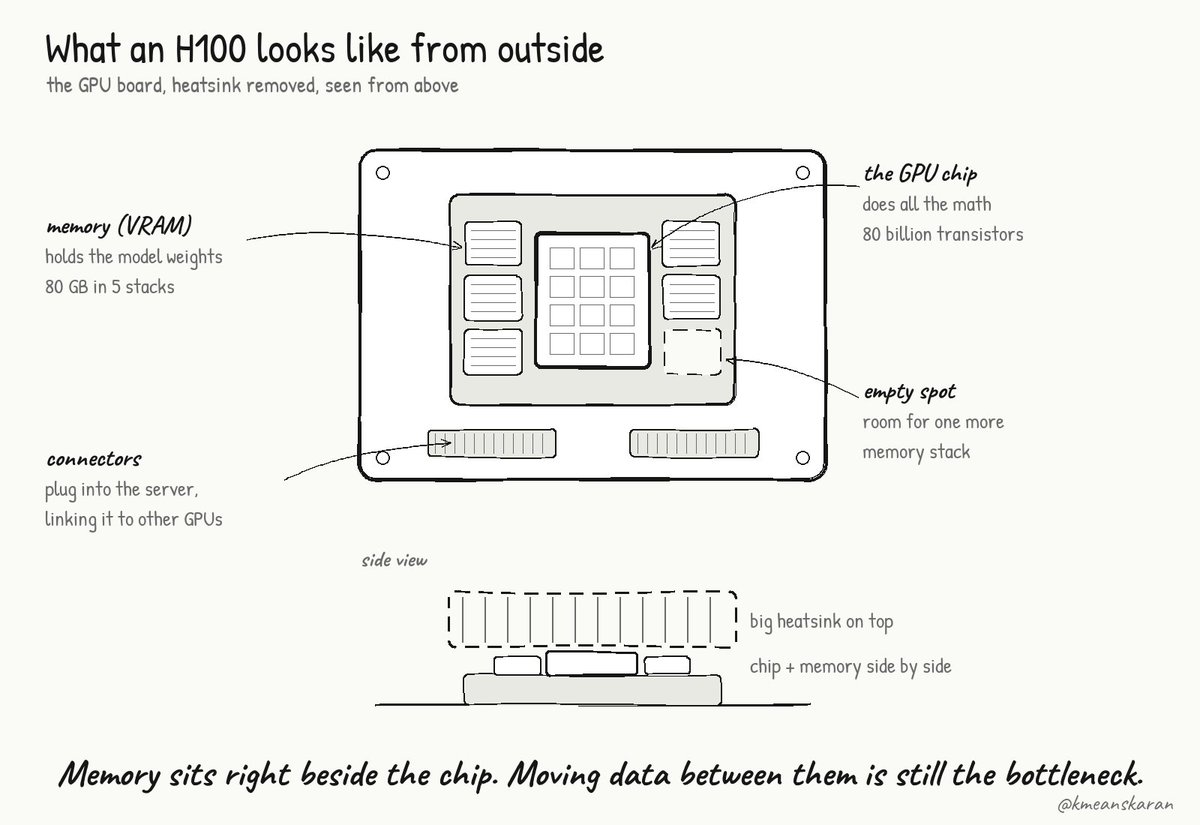
中间的方形是芯片,根据 NVIDIA 的 Hopper 深度解析,它有 800 亿个晶体管。它周围是五个内存堆栈,总计 80 GB。GPU 本质上就是这两样东西:计算,以及紧挨着它的内存。
计算
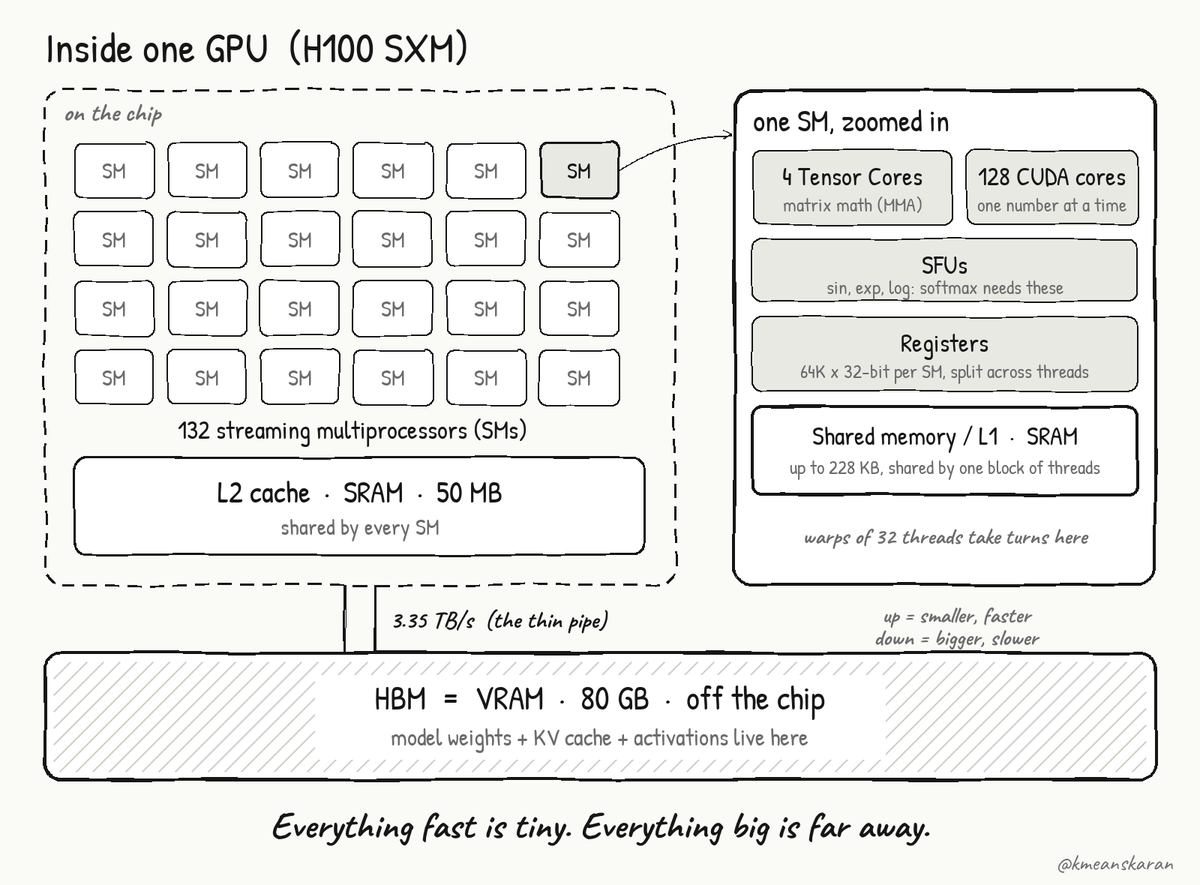
芯片由流式多处理器(SM)构成。一块 H100 有 132 个。每个 SM 有三种计算单元:
- CUDA 核心: 处理单个数字。
- 张量核心: 一次处理小矩阵。它们负责矩阵运算,因此对 AI 最为关键。
- 特殊函数单元: 处理 sin、cos 和 log。Softmax 需要用到它们。
张量核心只做一种运算——矩阵乘加:将 A 乘以 B,加上 C,存储结果。
这些工作由线程完成。CPU 有几十到几百个线程。GPU 有数万个,以 32 个为一组,称为线程束(warp)。当一个线程束等待数据时,GPU 会在一个时钟周期内切换到另一个线程束,因此数学运算几乎不会停顿。
这些线程运行的代码是一个 CUDA 内核:你启动一次的函数,成千上万个线程在不同的数据上同时运行它。最简单的例子,来自 NVIDIA 的 CUDA 编程指南:
__global__ void vecAdd(float* A, float* B, float* C, int vectorLength)
{
    int workIndex = threadIdx.x + blockIdx.x*blockDim.x;
    if(workIndex < vectorLength)
    {
        C[workIndex] = A[workIndex] + B[workIndex];
    }
}
没有循环。每个线程将一对数字相加。当你在 PyTorch 中调用 model(x) 时,每一次矩阵乘法、归一化和 softmax 都会变成这样一个内核。
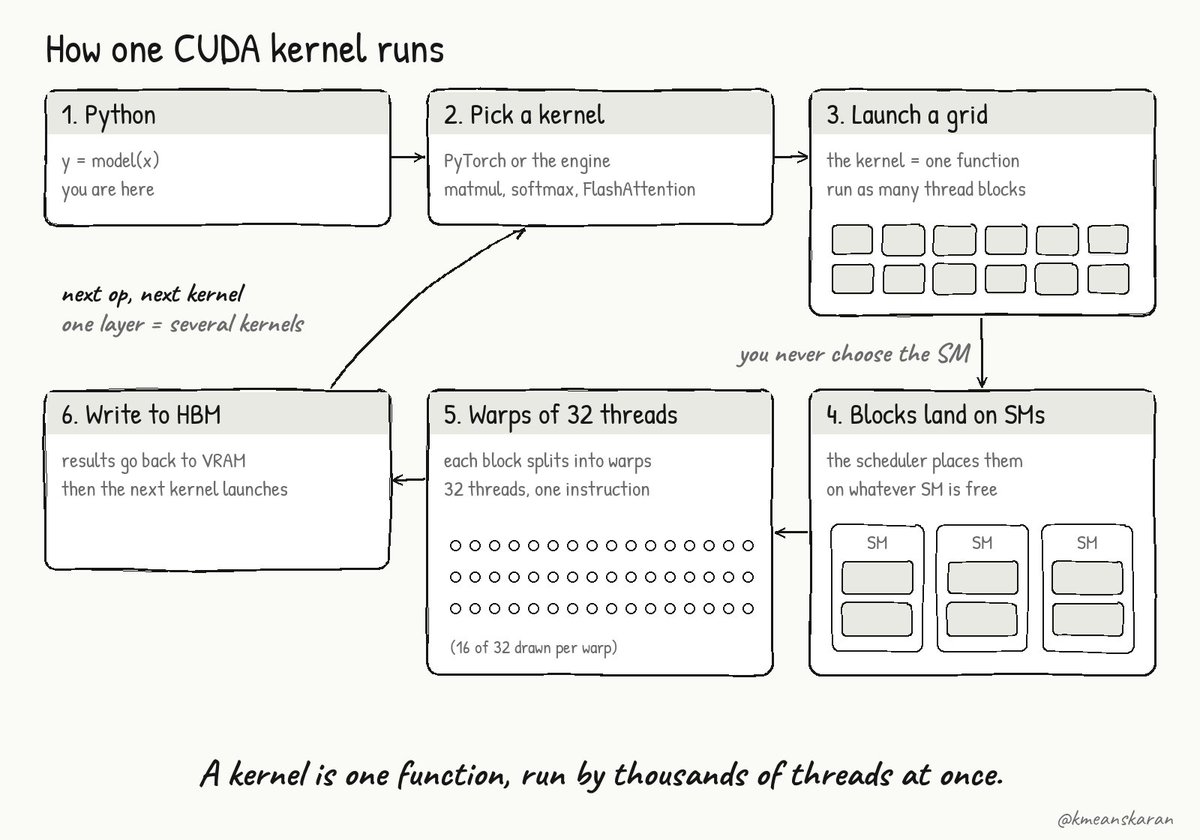
一个真实的例子是注意力机制中的 Q、K 和 V。在 vLLM 的 gpt-oss 代码中,三个权重矩阵并排存储,并在一次乘法中计算。对于 gpt-oss-120b,每个 token 的 2,880 个数字经过一个 2,880 × 5,120 的矩阵,一次性得到 Q、K 和 V。GPU 将其拆分成小块,每组线程处理一块。

算力以 FLOPS(每秒浮点运算次数)衡量。关于规格表有两点提示。第一,使用稠密数值,而不是“含稀疏性”的数值:H100 页面列出 BF16 含稀疏性为 1,979 teraFLOPS,所以稠密约为 990。第二,精度每减半一次,FLOPS 大致翻倍,所以比较 GPU 时务必使用相同精度。
现在来看精确的数学。一次前向传播每个 token 每个活跃参数大约花费 2 FLOPs,一次乘法加一次加法。
- gpt-oss-120b: 2 × 51 亿 = 每 token 10.2 GFLOPs。1,000 token 的提示词是 10.2 TFLOPs:在 H100 上以满血 990 teraFLOPS 运行约需 10 毫秒。
- Kimi K3: 2 × 1,040 亿 = 每 token 208 GFLOPs,大约多 20 倍。同样的 1,000 token 提示词是 208 TFLOPs:在一块 H100 上约需 210 毫秒。
这些都是最佳情况。真实内核永远达不到规格表上的满值。
内存
GPU 有两种内存:
- VRAM(DRAM): 大容量内存,以 GB 计。“V”代表 video(视频),源自图形时代。如今它是 HBM(高带宽内存)。
- SRAM: 芯片上的小型快速内存,用作缓存。共有三级:每个 Tensor Core 的 L0、每个 SM 内部的 L1(H100 上为 256 KB),以及所有 SM 共享的 L2(50 MB)。
VRAM 的重要性体现在两方面:
- 容量决定能装下什么。 它必须容纳权重加上 KV 缓存,即过去 token 保存的键和值。一条常见规则:权重加上至少 50% 的额外空间用于缓存。gpt-oss-120b 约为 65 GB,所以能装进 80 GB 的 H100,剩下约 15 GB 用于缓存。这少于规则要求。H200 的 141 GB 才是舒适的配置。
- 带宽决定 token 产出速度。 每生成一个新 token,GPU 都要从 VRAM 读取每一个活跃权重。
以下是 gpt-oss-120b 在一块 H100、单用户场景下的数学计算。每个 token 在 36 层中每层使用 4 个专家:约 1.9 GB 的 4 位专家权重。再加上保持 BF16 精度的注意力、路由器和输出层:约 3.1 GB。即每个 token 约读取 5 GB。
- 搬运权重: 5 GB ÷ 3.35 TB/s ≈ 1.5 ms。
- 做计算: 10.2 GFLOPs ÷ 990 teraFLOPS ≈ 0.01 ms。
GPU 等待的时间大约是计算时间的 145 倍。单用户的上限约为每秒 670 个 token,这还没算上 KV 缓存和实际开销分走的部分。
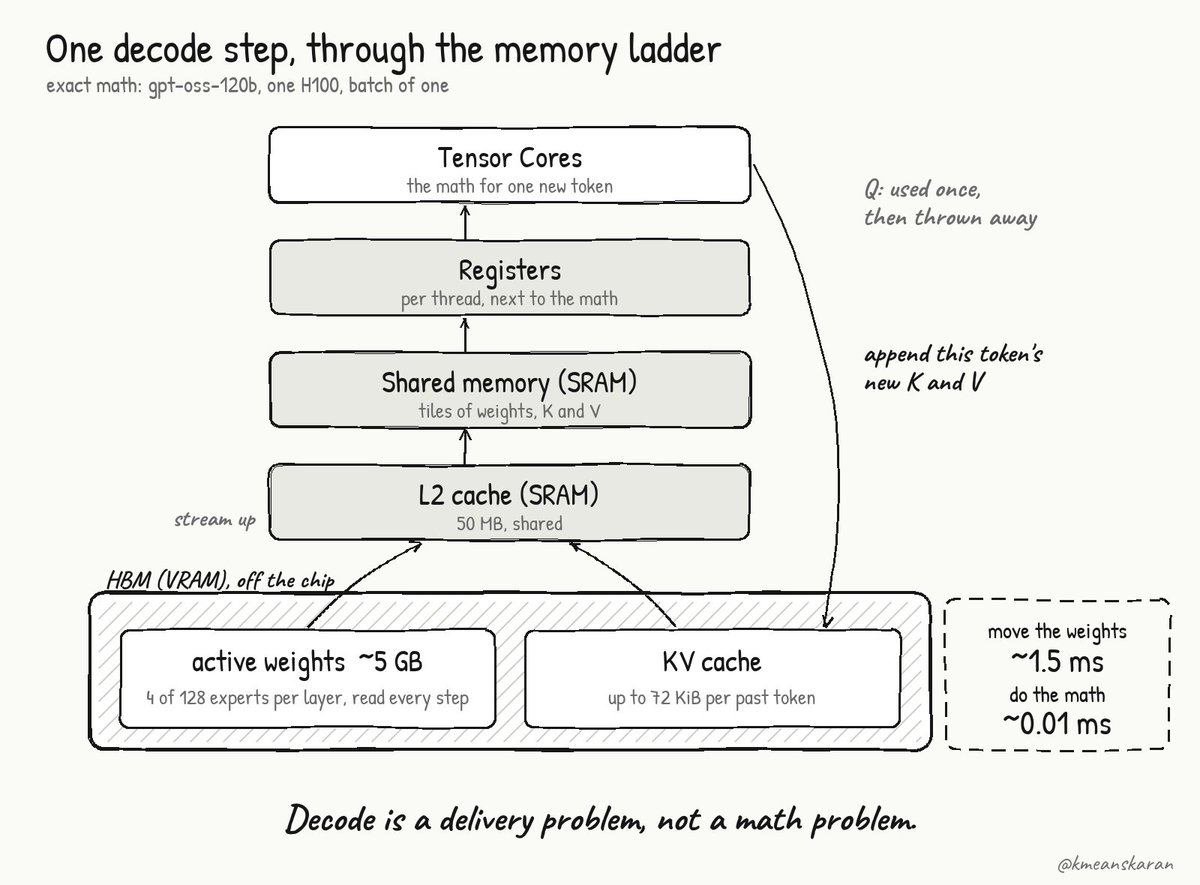
这对你意味着什么: 经验法则很简单。计算(FLOPS)是读取提示词(称为 prefill)以及图像和视频生成的瓶颈。内存带宽是生成 token(称为 decode)的瓶颈。这就是 H200 存在的原因:计算能力与 H100 相同,但141 GB 4.8 TB/s 取代了 80 GB 3.35 TB/s。
3. 训练与推理
同一块 GPU 承担着两种截然不同的任务。多年来,训练一直是 GPU 的主要用途。如今,推理正成为主导。
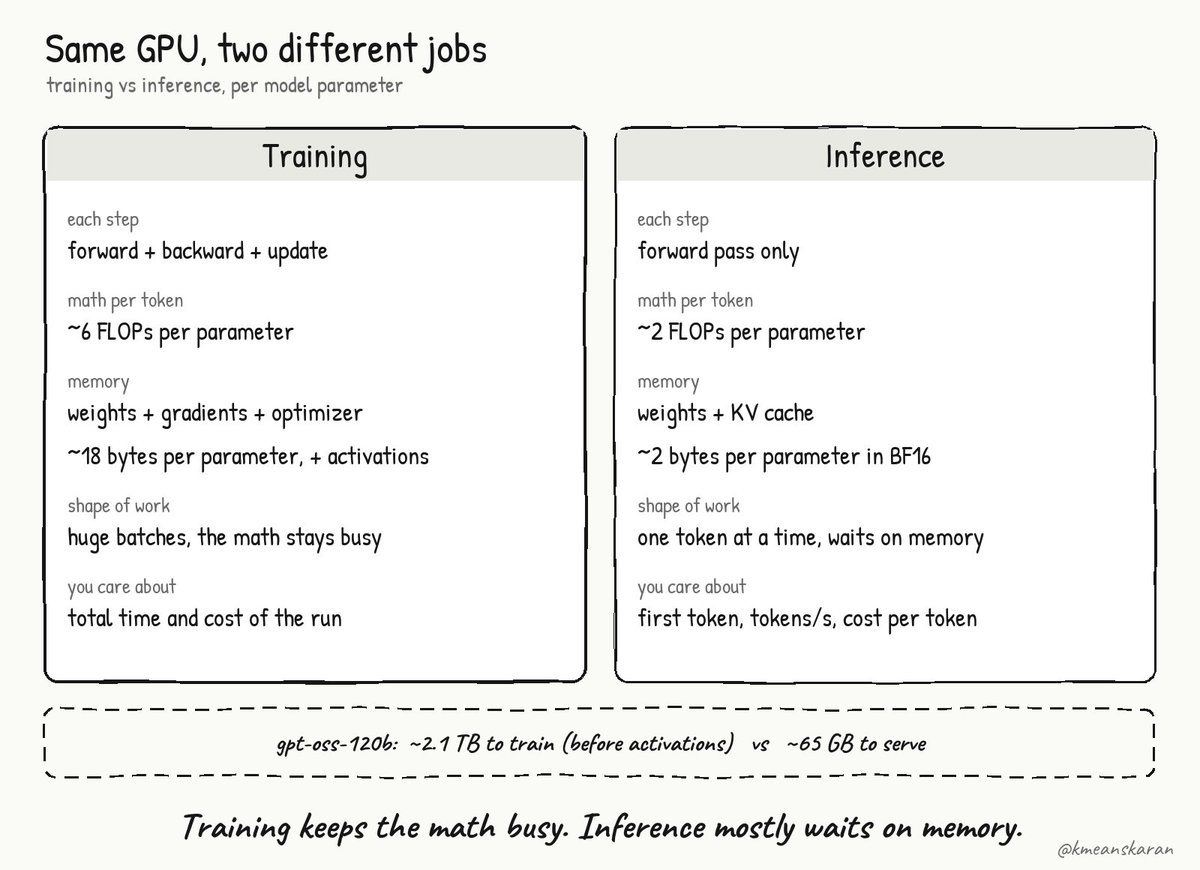
训练对每个批次执行三个步骤:前向传播以生成预测,反向传播以计算梯度,以及更新权重。缩放定律论文估计,这大约需要每个参数每个 token 6 FLOPs,因为反向传播的开销约为前向传播的两倍。对于 gpt-oss-120b,即 6 × 51 亿 = 306 亿 FLOPs 每训练 token,是推理成本的三倍。
训练还需要多得多的内存。Hugging Face 的训练内存指南针对使用 Adam 优化器的混合精度训练做了如下拆解:
- 权重: 每个参数 6 字节(一份 16 位副本用于计算,一份 32 位副本用于稳定更新)。
- 优化器状态: 每个参数 8 字节。
- 梯度: 每个参数 4 字节。
- 激活值: 在前向传播中保存以供反向传播使用,且随批次大小和序列长度增长。
在激活值之前,这大约是每个参数 18 字节,而且这里每个参数都要计入,不只是活跃参数。对于 gpt-oss-120b:1170 亿 × 18 字节 ≈ 2.1 TB,仅仅是训练所需,而推理只需约 65 GB。
推理只运行前向传播:大约每个活跃参数每个 token 2 FLOPs。内存中保存权重(BF16 下每个参数 2 字节,量化后更少)和 KV 缓存。仅此而已。
工作的形态也不同。训练一次性推送巨大的批次,因此从内存中取出的每个权重都会被多次使用,Tensor Core 保持忙碌。解码则每个用户一次只生成一个 token,因此 GPU 大部分时间都在等待内存。
这对你意味着什么:“适合训练”的 GPU 并不自动就是最适合推理服务的。训练时,你关心的是 FLOPS、总显存以及 GPU 之间的通信速度。推理时,你关心的是内存带宽、KV 缓存的空间,以及每个 token 的成本。
4. 量化
如果每个权重占 2 个字节,你可以用更少的位来存储它。这就是量化:8 位是原来的一半大小,4 位是四分之一。
诀窍在于共享的缩放因子。Hugging Face 的量化指南将其写作 x = S * (x_q - Z)。一个小例子:权重 0.50、-1.27 和 0.03,缩放因子为 0.01,存储为 50、-127 和 3。乘以 0.01 就能还原。
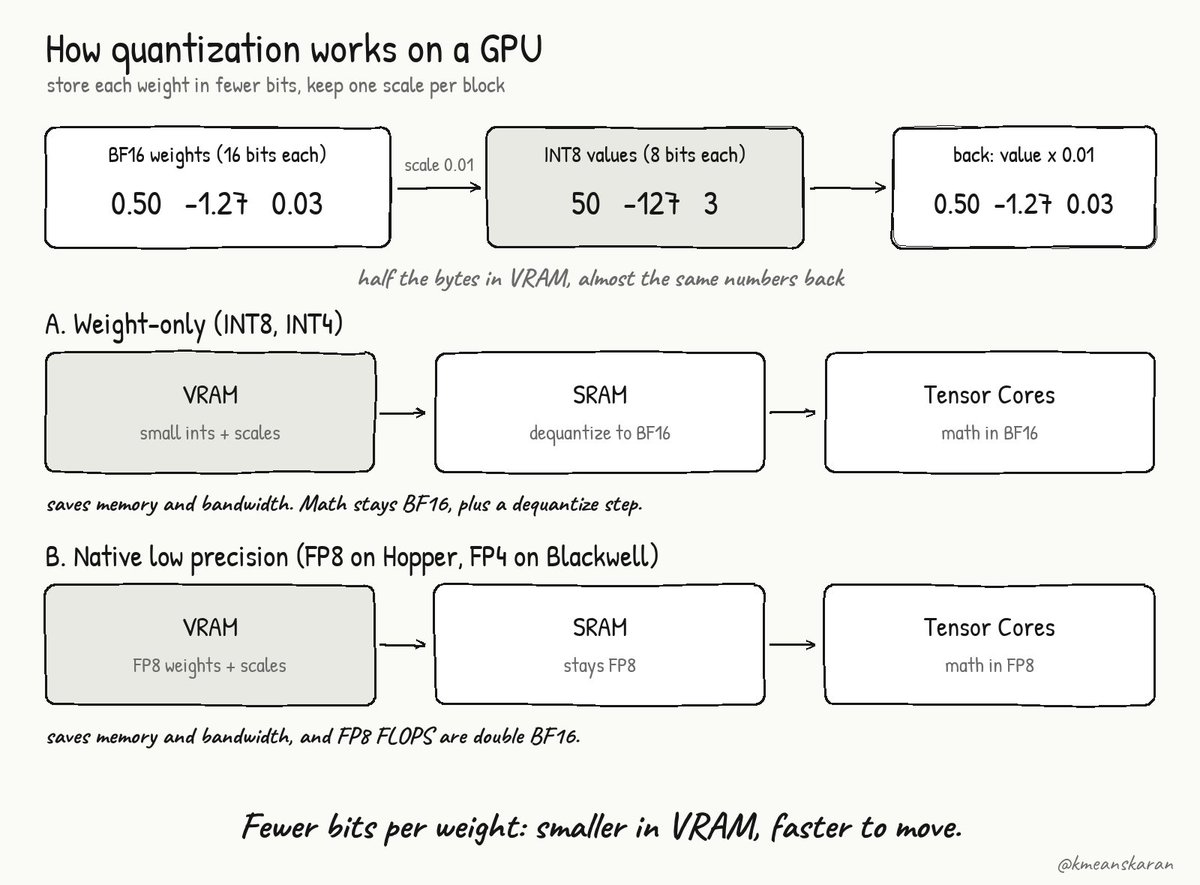
较老的 GPU 会存储小权重,并在做数学运算时把它们转回 BF16。较新的 GPU 则直接以低精度计算:Hopper 上用 FP8,Blackwell 上用 FP4。FP8 在纸面上快一倍,但这并不会转化为实际速度的两倍。
真实例子:gpt-oss-120b 以名为 MXFP4 的 4 位格式发布。1170 亿参数在 BF16 下会是 234 GB,但它发布时只有约 65 GB,而且 Hugging Face 的 gpt-oss 博文证实“120B 能装进单张 80 GB 的 GPU”。Kimi K3 被训练为以 4 位权重运行,这叫做量化感知训练。它的 2.8 万亿参数在 BF16 下约为 5.6 TB。检查点约为 1.56 TB。
这对你意味着什么:量化主要换来的是显存,让模型能装进更少或更便宜的 GPU 上。始终要在你自己的任务上测试质量。
5. GPU 世代
NVIDIA 的命名有两部分:字母代表世代,数字代表规模。H100 接替了 A100。H200 是更大的 Hopper。世代以科学家命名。
在较老的系统中,你仍会看到 Turing(T4)和 Ampere(A10、A100)。如今真正重要的几款:
- Ada Lovelace(L4、L40): 更便宜,支持 FP8,但没有 NVLink——那种快速的 GPU 间互连。适合小模型。
- Hopper(H100、H200): 新增了 FP8。足够新,所以快;也足够成熟,所以每个框架都支持它。大多数推理都跑在这里。
- Blackwell(B200、B300): 新增了 FP4,因此像 gpt-oss-120b 和 Kimi K3 这样的 4 比特模型可以原生运行。B200 有 180 GB,B300 有 288 GB。大模型的新黄金标准。
- Rubin(2026): HBM4 显存,每 GPU 最高 288 GB、22 TB/s,自 2026 年 10 月起开始出货。此外还有 Rubin CPX,一款专为 prefill 设计的独立芯片,预计 2026 年底推出。
- Feynman(2028): NVIDIA 路线图上的下一款。
NVIDIA 自家的 Grace 和 Vera CPU 以 900 GB/s 的速度连接 GPU 显存,快到足以把旧的 KV cache 存放在更大的 CPU 内存里。
这对你意味着什么: 世代字母告诉你,你能获得哪些精度、是否有 NVLink,以及软件有多成熟。关于新世代,我的建议是:等真实的基准测试出来,因为软件大约需要一年才能跟上。
6. 你实际租到的是什么
在云端,你租的是一个实例,而不是一块 GPU:GPU 加上 CPU、内存、存储、网络,以及 GPU 之间的互连。其中任何一项都可能成为你的瓶颈。
当模型太大时,多块 GPU 需要协同工作。标准单元是节点:一台服务器内八块 GPU,通过 NVLink(Hopper 上每块 GPU 900 GB/s,Blackwell 上 1,800 GB/s)和 NVSwitch 相连,后者将每块 GPU 与其余所有 GPU 互连。节点之间通过 InfiniBand 连接,这种网络大约比 NVLink 慢十倍。
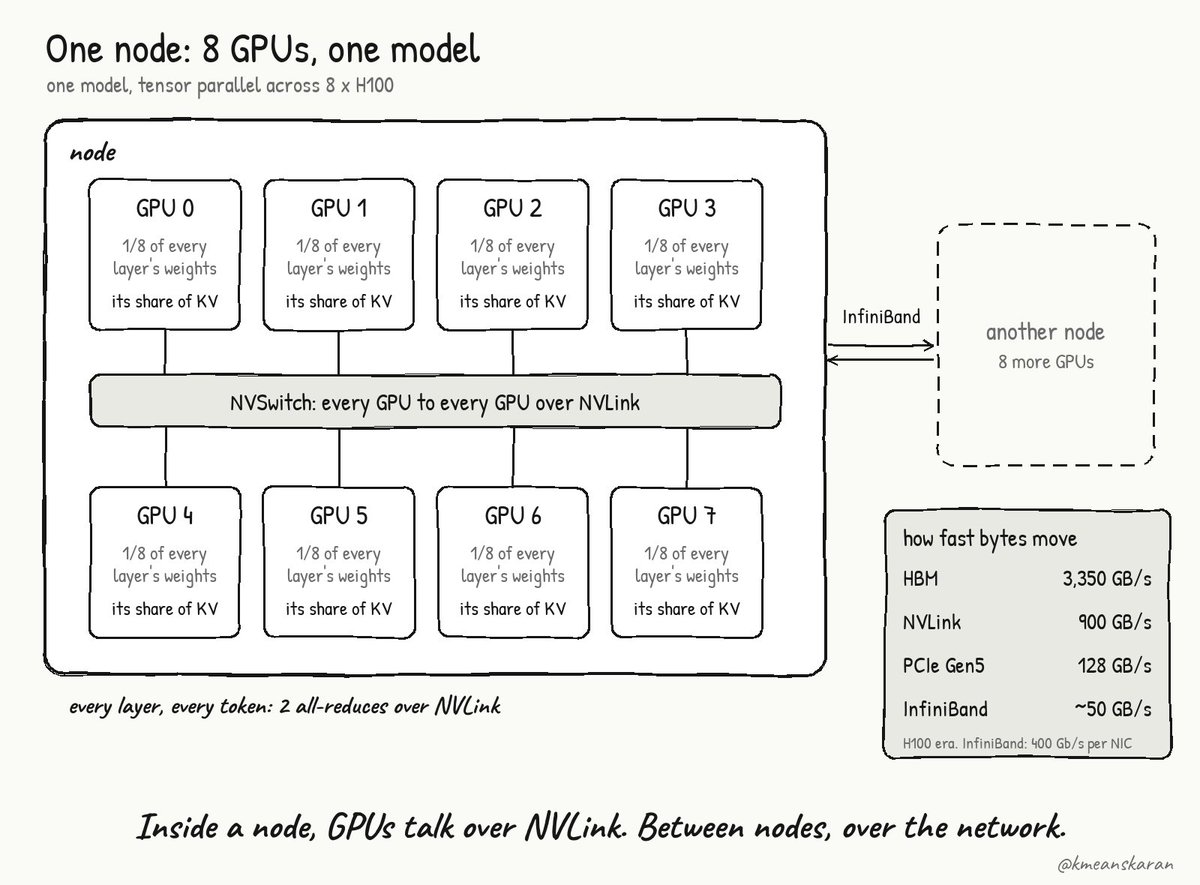
由于这一速度差距,vLLM 的文档建议将每一层拆分到节点内的各块 GPU 上(张量并行),并将成组的层拆分到不同节点上(流水线并行)。Kimi K3 就是一个真实例子。它的权重约为 1.56 TB,超过一个 8 × H200 节点所能容纳的量(8 × 141 GB = 1,128 GB)。NVIDIA 自己的 Kimi K3 方案将其运行在 32 块 H200 上:在每个节点的 8 块 GPU 之间做张量并行,在 4 个节点之间做流水线并行。总计 4,512 GB,因此大部分内存都用于 KV 缓存。在 Blackwell Ultra 上,一个 8 × B300 节点(2,304 GB)自身就能容纳这些权重。
当模型太小时,你会遇到相反的问题。一个只有几十亿参数的模型无法让一块 H100 保持忙碌。MIG 可以将一块 GPU 拆分为最多七块更小、相互隔离的 GPU,每块都拥有自己的一份内存。
7. 如何挑选 GPU
五个快速步骤:
根据 Hugging Face Inference Endpoints 价格(AWS 上),我在 2026 年 9 月底查看时:
- gpt-oss-120b(约 65 GB),最便宜: 1 × A100 80 GB,$2.50/小时。它能装下,还剩约 15 GB 给 KV 缓存。
- gpt-oss-120b,多用户: 1 × H200,$5/小时。141 − 65 = 76 GB 给 KV 缓存,而 4.8 TB/s 把每 token 的上限降到 5 GB ÷ 4.8 TB/s ≈ 1 ms。
- Kimi K3(约 1.56 TB): 对列表上最大的实例来说太大了,8 × H200 共 1,128 GB,$40/小时。你需要像第 6 节那样的多节点设置。
8. 英伟达之外
英伟达领先,但并非一枝独秀。替代方案包括 AMD 的 Instinct GPU、AWS 的 Inferentia 和 Trainium、谷歌的 TPU、Cerebras 的晶圆级芯片,以及 Groq 基于 SRAM 的 LPU。近期有两个变化:AMD 已转向 MI400 系列,英伟达则获得了 Groq 的技术授权,NVIDIA Groq 3 LPX 现已全面投产。
每家都押注一个优势:内存带宽(Cerebras、Groq)、能效(Furiosa、高通),或云集成(亚马逊、谷歌)。它们面临同一个挑战:没有 CUDA,就必须重建整个软件栈。
这对你意味着什么: 替代芯片在特定工作负载上可能更快或更便宜,但先确认它对你所用具体模型的软件支持。
小结
就我个人而言,我专注于 LLM 的基础知识和一点 GPU 知识,这已经足够有用了。那些让你先学 CUDA 的人,是把这个领域最后百分之十的内容当成了入门门槛。
如果你从这篇文章中只记住一个习惯:在租用任何东西之前,先做两次除法。权重 ÷ 显存,告诉你它装不装得下。活跃权重 ÷ 带宽,告诉你它能跑多快。
一句实话:我并没有亲自对这些 GPU 做过基准测试,所以这里的速度是规格表上的算术。而且硬件事实老化得很快:我核查时发现,仅仅几个月前的资料在苹果、AMD 和 Groq 上就已经过时了。
谢谢。
关注 @kmeanskaran