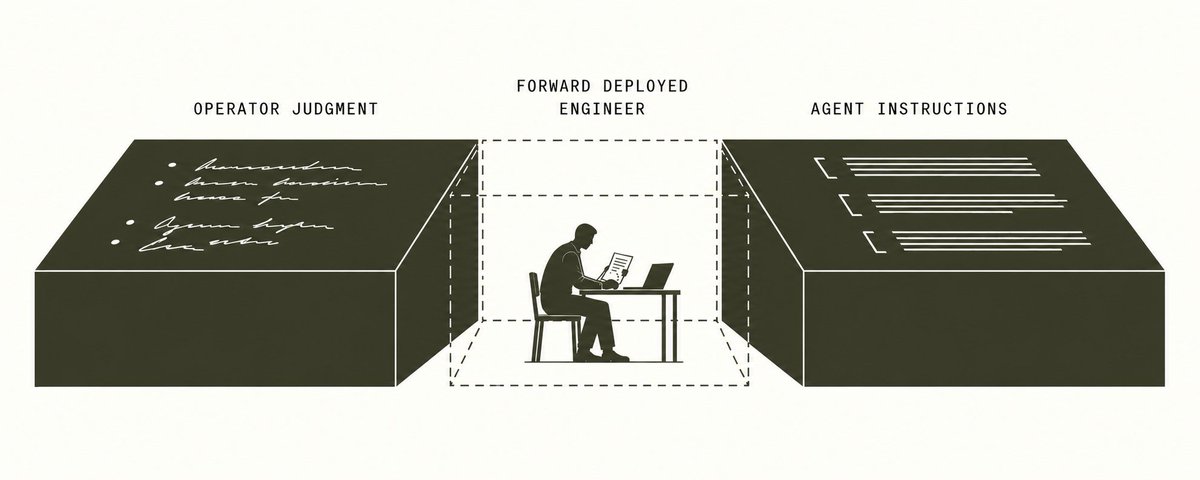
FDE 热潮是产品缺口的体现
行业用招聘FDE绕过缺失产品;真正解法是把运营证据与专家判断转化为可测试、可维护的智能体指令,并靠学习循环持续扩大可执行覆盖率。

这个行业正用招聘来绕过一款缺失的产品。
每一家试图让智能体投入工作的企业,都会撞上同一个问题:智能体不了解公司如何运转,而真正懂运转的操作者,又没有便捷的方式去教它们。
针对这个问题,有两种流行的做法。第一种是招聘前置部署工程师(FDE)。操作者与一名 FDE 坐在一起,由后者把公司的运作方式转化为智能体可以遵循的指令。这就是 FDE 无处不在的原因。操作者教 FDE,FDE 再教智能体。这向来是一项高溢价的服务,而在每一次运营变更中都夹着一名工程师,是无法规模化的。
另一种做法是构建上下文图谱,把公司的记录与决策连接起来,让智能体能够调用其积累的经验。这种方式更具可扩展性,但如果仅仅把智能体接入公司的历史就足够了,FDE 就不会如此抢手。
真正的挑战在于,把操作者的判断转化为智能体能够遵循的形式,并在业务变化时让这些指令保持最新。
多年来,做这项转化工作的人就是我们。Yannis 和我曾在 Palantir 领导前置部署 AI 工程团队。
曾有一家大型电信公司,把涉及数百亿美元供应链支出的数据交给了我们。他们想要自动化控制机制,用来识别那些偏离业务应有运作方式的设备订单。识别趋势很容易。要厘清那些真正重要的细微差别,却并不容易。
在某个设备系列中,某一电压等级的单元大多数时候会被更换,但并非总是如此。哪些工单属于违规操作,哪些又是从未被记录下来的高效工作方式?我们把这个模式拿给了负责这项工作的人。他们确认了电压规则,并解释了为什么有些工单偏离了规则。有些是错误:人们没有遵循流程,往往是因为他们不知道有这个流程存在。另一些则反映了书面流程从未记录过的合理区域要求。
这家电信公司的工单历史本身就是一个上下文图谱!它不加区分地同时记录了错误和合理例外。FDE 能发现模式;但只有运营人员才能决定哪些做法应当停止,哪些应当成为正式流程的一部分。
AI 既大幅降低了构建和维护对智能体友好的知识库的成本,也提高了拥有此类知识库的回报。
问一家公司,它是否有一份足够详尽、能让聪明的新员工照着做的流程现况记录。大多数人会对此一笑置之。
维护一份最新的现况记录过去是件苦差事。回报是更好的文档,但人们仍然得逐案阅读、记忆和应用。大多数组织从未接近过一份完整、最新的现况记录。
在大型组织中,没有哪一个人了解整个流程。然而,智能体可以通读数千个案例,浮现候选规则,识别矛盾之处,并把提案呈交给流程的负责人,由他们分辨哪些是错误、哪些是合理的未记录规程。智能体让汇编和维护知识的工作变得更便宜。
智能体可以大规模执行已批准的流程。于是,维护这些指令就成了维护生产基础设施的一部分。
想想看,如果有了这种新获得的能力,这家电信公司的项目本可以如何运作。
这一次,智能体读取订单历史并识别出电压模式。它们起草一条拟议规则,附上支持该规则的案例,并标出不符合的案例。供应链负责人确认了这条电压规则,将第一组例外标记为不合规,将区域组标记为合理,补充一行说明理由,然后批准了它。
由此形成的书面流程记录了通用规则、区域例外,以及需要人工判断的情形。在部署之前,它会用代表性案例进行测试。
流程负责人现在可以更改操作说明,而无需 FDE 翻译每一次修订。
每一次升级都能改进下一个案例
这在重复性运营中影响最大(例如设备申请、事故、索赔、客户支持,以及任何有一组人做同样工作的场景)。一个案例到来,智能体找到适用的流程,并使用工具来完成工作。
这些流程需要随着业务变化和新案例暴露出缺口而演进。运营人员应当能够从正在完成的工作中审查拟议的更新,直接引入政策变更,并在部署前测试其效果。
我们把持续运行这一工作的纪律称为 ContextOps:将运营证据和专家判断转化为经过测试、获得批准的指令,并在业务变化时维护这些指令。
流程负责人对指令的内容负责。AI 帮助汇集和更新它们,而工程团队维护执行它们的系统。
你的可执行覆盖率是多少?
可执行覆盖率,是指一个流程中,智能体能够依据当前已批准的程序正确处理、无需他人补充缺失操作判断的案例占比。
取一百个设备请求作为代表性样本。其中有多少符合这一标准?这就是你的起点。
如果你对一个已经想让智能体运行的流程都答不上来这个问题,那你就还没有弄清楚,你的运营模式中有多大一部分已经足够明确,可供智能体使用。
学习循环才是复利所在
有效运行 ContextOps 的最大收益,会在几个周期之后才显现出来。
假设一个来自某个地区的设备请求到达,而现有程序并未覆盖该地区。智能体将其上报给运营人员,运营人员解决了该案例并记录了推理过程。随着类似案例不断积累,智能体提出对程序的更新建议,并附上支持性证据和任何矛盾之处。负责的运营人员审核后,决定哪些判断应成为常设指令,并批准该变更进入测试和部署。
该程序现在覆盖了一批此前需要有人补充缺失判断的案例。每个使用该程序的智能体都能从运营人员所教的内容中受益。
更新后的程序为每个使用它的智能体扩大了可执行覆盖率。
上报、解决、更新程序:这就是学习循环。曾经需要 FDE 回来转化新的操作判断,如今变成了运营人员可以持续运行的流程。
企业现在拥有了学习循环,而不是租用它的。
“我们为什么不直接微调自己的模型?”
但这不是有条显而易见的捷径吗?既然可以直接用公司的历史数据来训练模型,何必费这么大劲去构建带学习循环的智能体?
遗憾的是,这条路失败的原因和上下文图谱如出一辙。你永远无法确定历史数据中的人当时做的是对的事,所以你很可能只是在用坏习惯训练模型。况且业务从不停滞。每新增一个供应商、一个地区或一项政策,就意味着要重新收集样本、重新训练模型。
你可以要求供应链运营人员维护一份书面流程。你没法要求他们把某个行为从模型里微调掉。
上下文的开发生命周期
组织应当像软件团队对待代码那样,对待学习循环所产生的知识。
智能体的指令需要有负责人和版本号。提出的变更要附带证据。它们要经过评审、测试、部署,并且可以回滚。你应当能够看到是哪一版指令支配了智能体的某次决策。
GitHub 为这种纪律提供了一个有用的范本。但运营人员的工作流有所不同。
一条拟议的规则可能是从数百个案例中、由许多人做出的决策综合而来的。文本差异能显示改了什么。但要批准它,运营人员需要看到其背后的工单、日志和判断:哪些案例支持这条规则,哪些与之矛盾,哪些只是一次性的例外。
运营人员应当能够贡献、质疑并批准其 AI 所遵循的指令。这些指令必须传达到正在执行工作的智能体,并在公司更换模型、增加智能体、拓展新流程的过程中始终留在公司内部。
Edra 正在为运营人员打造一个类似 GitHub 的平台:一个集中式界面,用于创建、审查、测试、部署并改进每个智能体背后的指令。我们的使命是让每家公司都能实践 ContextOps:把运营人员的判断力转化为知识,让每个智能体都能使用,让每位专家都能改进。
关于公司如何运转的知识,是企业最宝贵的知识产权。它理应得到更好的对待,而不是散落在工单里、过时的文档中,或仅仅停留在最优秀员工的记忆里。