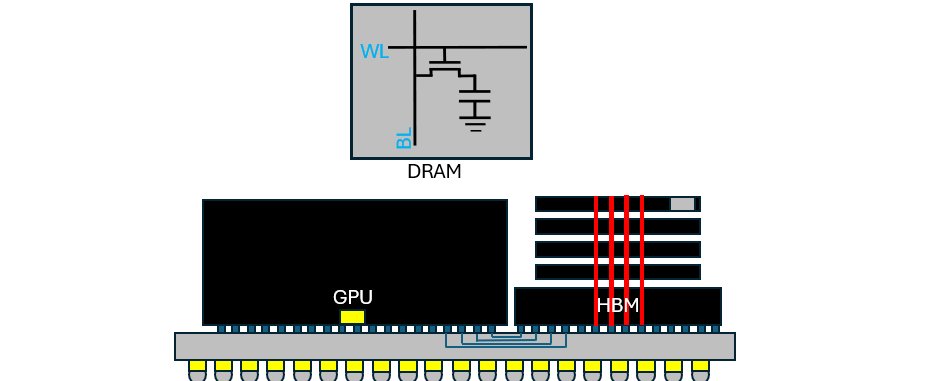
HBM系统架构概览
HBM 以「宽而慢」架构破解冯·诺依曼瓶颈,成为 AI 算力核心,但热梯度、互连与良率挑战正逼近极限,替代方案各有取舍。

在这篇文章中,我将对 HBM 做一个宏观概述,并附上一篇更深入探讨的文章链接。
目录:
- JEDEC 标准
- 从大宗商品到 AI 最关键组件
- 为什么 AI 需要 HBM?
- HBM 的替代存储方案
当前的 HBM 架构正面临若干扩展性挑战,涉及热性能、互连 shoreline 限制以及制造良率。
在我看来,HBM 的首要问题是堆栈中的热梯度。堆栈内不同层的温度可能差异很大,需要精密的传感器和电路来补偿热失配。
HBM 的简明历史:从大宗商品到 AI 最关键组件
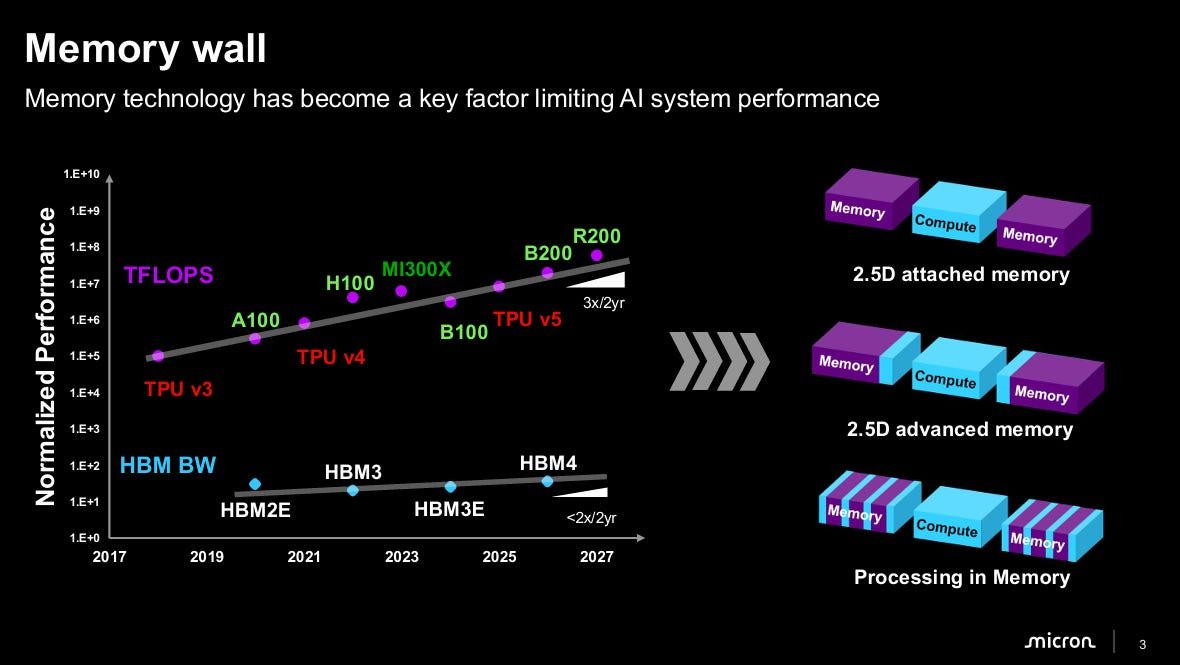
高带宽存储器(HBM)可以说是 AI 加速器中最重要的单一组件,因为其容量足够大,能够存储 AI 计算所涉及的大量数据,包括模型权重、梯度、优化器状态和激活值。
高数据带宽至关重要,因为大多数 AI 计算的瓶颈在于内存与计算之间的数据搬运,而非计算本身的原始算力。遗憾的是,内存带宽未能跟上计算扩展的步伐,从而导致了众所周知的冯·诺依曼瓶颈。
JEDEC 标准
在其发展历程的大部分时间里,内存行业一直非常保守,以承受繁荣与萧条的周期。内存产品历来在高度商品化的大规模市场中运作,受严格的 JEDEC(联合电子设备工程委员会)标准驱动。这种标准化对于使内存芯片在不同供应商之间在功能上可互换是必要的;任何电子产品制造商都可以从任何内存供应商处购买标准 DRAM 芯片,该芯片可以插入任何内存控制器,而无需定制 PHY 或定制协议桥接。请注意,JEDEC 标准化仅适用于外部引脚接口;内部裸片实现由制造商决定。
JEDEC 标准化使得内存制造商之间的竞争几乎完全基于纯粹的经济优势,包括每比特价格和制造良率。与拥有专有 ISA 的 GPU 和 CPU 不同,内存制造商历来难以在系统功能上实现差异化。
DRAM 因其高容量和高带宽而成为 GPU 的主要内存来源,适用于高度并行化的计算。DRAM 的主要类别包括:
- DDR(双倍数据速率) - 针对系统主内存优化。模块化、容量和多通道灵活性被优先考虑。
- LPDDR(低功耗 DDR) - 针对功耗受限的移动和边缘设备优化,具有电源门控状态和更低工作电压等特性。
- GDDR(图形 DDR) - 针对高吞吐量图形、游戏主机和边缘 AI 硬件优化,在窄总线(约 32 位/通道)上通过标准多层 PCB 布线实现极高的引脚时钟频率。
GDDR 通常被认为是 HBM 的历史前身。GDDR 常被称为“快而窄”,并且历史上放置在离 GPU 较远的位置(大约 30 - 100mm)。
从商品到 AI 最重要的组件
2010 年,GDDR 在 GPU 上撞上了严重的功耗与引脚数扩展墙。要提升内存性能,要么增加更多 GDDR,要么推高每引脚数据速率。这两种选择都极不可取,因为增加 GDDR 数量会突破标准芯片封装的物理海岸线限制和面积限制。更高的频率则会导致信号完整性在长互连距离上退化。功耗也会随 CV^2*f 上升。
为克服这些挑战,AMD 与 SK 海力士合作,放弃长 PCB 走线,提出了一种激进的新架构:在靠近 GPU 海岸线的基础裸片上采用超宽、低数据速率接口。随后,DRAM 裸片通过硅通孔(TSV)垂直堆叠在该基础裸片上。这通常被称为“宽而慢”方案,其中每引脚的低时钟频率改善了每比特能耗。
SK 海力士于 2013 年制造出首个可工作的 HBM 硅片,促使 JEDEC 于 2013 年 10 月正式采纳 JESD235 标准,正式标准化 HBM 接口。
HBM 于 2015 年 6 月在 AMD 的 Fiji GPU 架构(Radeon R9 Fury X)上首次商业亮相。HBM 在当时是革命性的——在 GDDR5 所需板卡面积的一小部分内提供了 512 GB/s 的聚合带宽!然而,HBM 最初被视为高端消费级图形产品的昂贵奢侈品。
从 2016 年至今,随着新模型架构的发明以及 GPU 成为最高效的 AI 加速器之选,HBM 在性能和表现上逐步提升,并在企业级 AI 应用中站稳了脚跟。
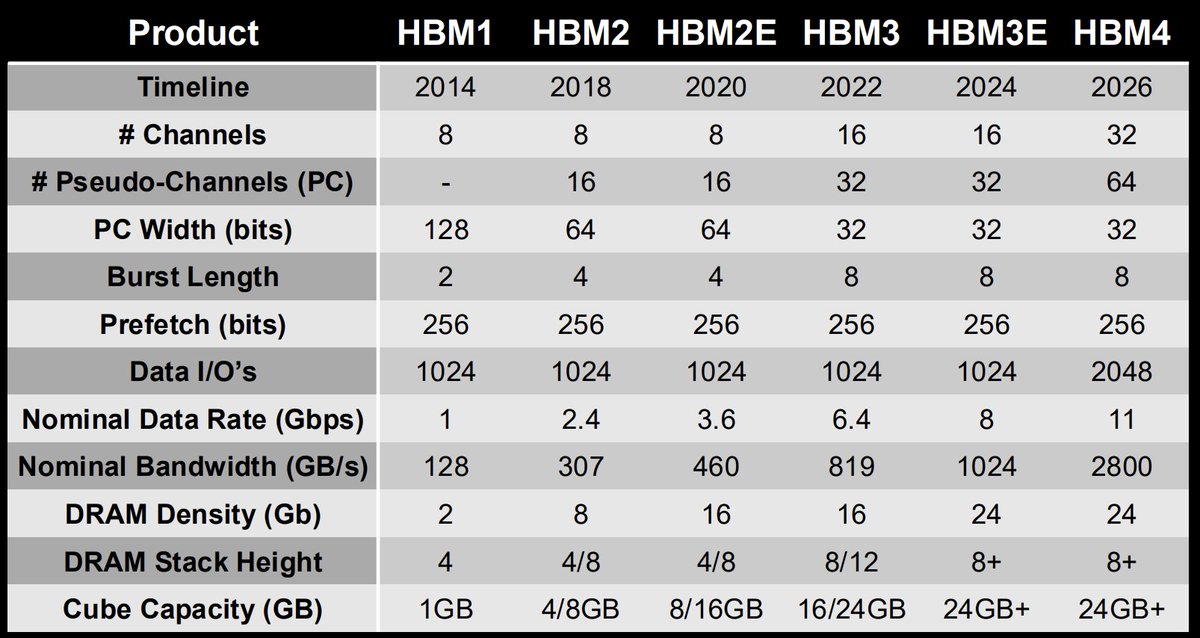
2025 年,JEDEC 发布了 JESD270-4 (HBM4),为内存制造商正式制定了一套统一标准。这些标准定义了以下内容:
- 物理接口与总线宽度
2,048 位宽接口
32 个独立通道
64 个伪通道,其中每个独立通道被拆分为两个通道,以减少总线争用
- 传输速率与带宽
每引脚 8 Gbps 的基准传输速率,每个堆栈可提供 2.0 TB/s 的总带宽
2.0 TB/s 总带宽
支持最高 16 层 DRAM 裸片堆叠,容量可达每个立方体 64 GB
- 裸片堆叠与最大容量
正式标准化 4 层、8 层、12 层和 16 层 DRAM 堆叠。
采用 32 Gb 裸片时,每个堆栈的最大封装密度为 64 GB
简而言之,得益于 JEDEC,只要内存制造商遵守这些标准以保持互操作性,裸片内部发生什么并不重要。然而,为了保持竞争力,内存制造商必须实现差异化,并努力将最大总带宽推高至 JEDEC 最低标准之上。
为什么 AI 需要 HBM?又有哪些替代方案?
高带宽之所以必要,是因为大多数 AI 计算都涉及重复的 MAC 运算,以及计算与内存之间持续不断的数据搬运。
AI 算力的主要驱动力——LLM,包含两个主要处理阶段:预填充(prefill)与解码(decode)。解码往往是耗时且受内存带宽制约的操作,因为 token 是从庞大的 KVCache 中自回归地逐个生成的。计算核心大部分时间都处于完全“数据饥饿”的状态,等待权重从内存中搬运过来。投机解码(speculative decode)等技术有助于缓解内存带宽的压力。
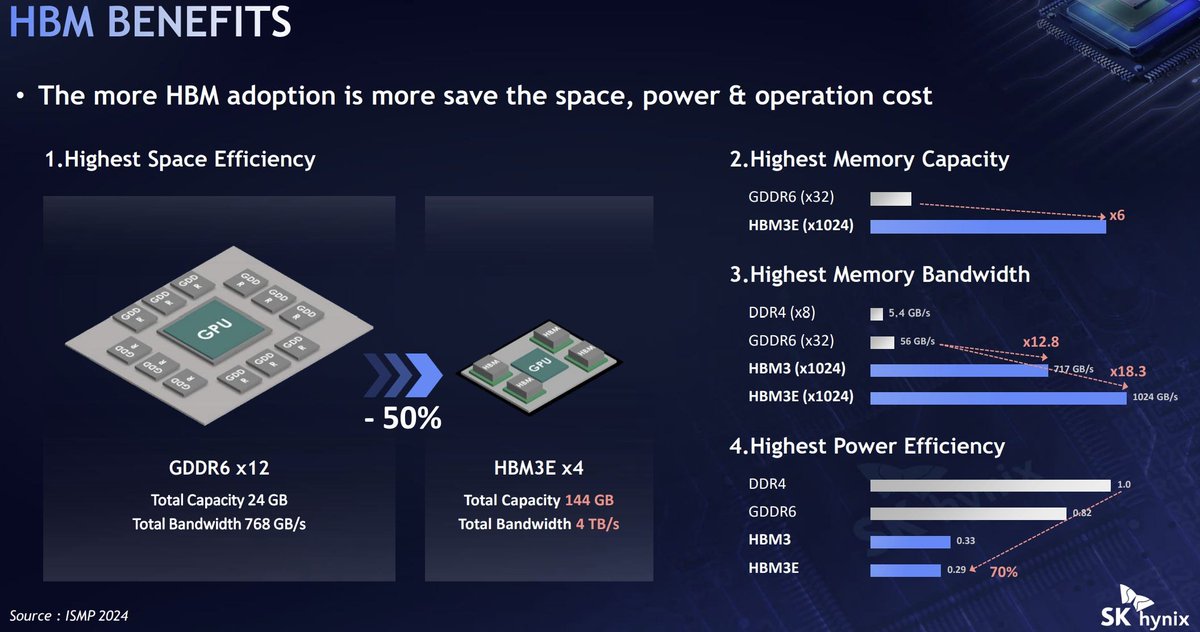
然而,在算力建设热潮中,对 HBM 的需求急剧飙升,导致严重短缺。在内存短缺的背景下,HBM 有哪些替代方案?
- GDDR7 - 采用 PAM3 实现每引脚 28-40Gbps 的速率。GDDR7 还使用标准的表面贴装 BGA 技术,而非 HBM 复杂的 2.5D/3D 先进封装。
引脚数量的限制导致其每比特能耗显著更高(5-6 pJ/bit,而 HBM 低于 1pJ/bit)
目标应用: 中端、对成本敏感的企业级 AI 工作负载,这类场景无法接受供应链瓶颈,且不需要极致性能。
- 纯片上 SRAM(晶圆级与 LPU) - 将大规模 SRAM 阵列嵌入逻辑裸片或跨硅晶圆分布。计算单元通过宽而超高速的交叉开关直接紧邻 SRAM 块,从而在解码阶段消除外部内存墙。
SRAM 的存储容量极其有限,这意味着一个 70B 参数的模型需要将数百个分立 SRAM 芯片组网连接。
目标应用: 超低延迟的 LLM 工作负载
- 聚合式 LPDDR5X / LPDDR6 阵列 - 将现有的移动端 LPDDR6 通过宽内存控制器总线进行拼接。
这带来了巨大的容量(128 - 512 GB)以及通常在移动端才有的功耗水平下的统一内存架构。
然而,其带宽比 HBM 慢 2-4 倍,为 500GBps/1TBps。高走线数量也带来了封装问题。
目标应用: 本地及低功耗 AI PC
- 存内计算(PIM)/ 近存计算。 将简化的处理引擎集成到 HBM 堆栈附近,无论是在基础裸片(base die)中还是紧邻 DRAM。这绕过了 D2D 通信,直接在数据存储体(data bank)内部对数据进行操作
PIM 计算单元往往速度较慢、效率较低,并占用本可分配给其他功能的空间。它们还要求编译器工具链增加额外的复杂性。
目标应用: 定义明确、高度受限于内存的逐元素操作。
- 解耦内存池(CXL 3.x / DDR5)。 使用 CXL 3.x 或 PCIe 6/7 将标准 DDR5 DRAM 的外部池聚合到共享内存结构(shared memory fabric)上
这解决了容量限制问题,可以挂载 TB 级的共享系统内存。
然而,由于信号需要经过的网络复杂性,延迟非常高
目标应用: 大型多租户 KV 缓存、托管超出 GPU 内存的推荐模型嵌入

- 高带宽闪存(HBF)。 采用与 HBM 相同的堆叠技术,堆叠 3D NAND 闪存裸片而非 DRAM。
相比 HBM,这将封装内内存密度提升了 8-16 倍。
然而,它继承了 NAND 的所有物理局限:严重的写入耐久性限制、读写性能不对称,以及更高的访问延迟,这意味着**它通常不适合频繁写入。
目标应用**:从静态模型权重进行读密集型的 LLM 推理,混合 HBM+HBM 内存方案中的高容量扩展层。
第 2 部分:HBM 的系统拆解
这是更大规模多部分文章的第 1 部分。在下面的 Substack 文章中,我将进一步详细拆解和分析 HBM:
https://www.siliconcodesign.com/p/the-system-architecture-of-hbm-how