Jev 详解
Jev 用固定答案类型+显式概率替代生成式输出,专攻代码已知答案空间的高频小判断,是 LLM 的伴侣而非替代。
我们一直把 LLM 当成一把锤子,用来敲打每一个 AI 问题,哪怕只是简单的决策。Jev 能在毫秒级处理这些决策,成本却只是零头。让我们来了解它的工作原理,以及它适合用在什么地方。
TypeSafe AI 于 2026 年 9 月 15 日发布了 Jev,而外界对它的反响异常强烈——对于一个既不会聊天、不会写代码、也生成不出一段有用文字的模型来说,这很不寻常。
嗯,这种局限恰恰就是它的意义所在。
大多数软件并不需要又一个聊天机器人。它需要做出成千上万个微小的判断,比如:这张工单紧急吗?这个请求该由哪个模型处理?这条 shell 命令危险吗?检索到的这段内容能回答问题吗?
团队常常把每一个判断都丢给通用 LLM。模型一个 token 一个 token 地生成答案,应用再解析、校验,形状不对就重试。这确实可行,但对于一个只有五种可能答案的决策来说,既慢又贵。
Jev 正是为这类决策而专门构建的。TypeSafe 称它为 System One 模型:非结构化状态输入,带类型的答案和概率输出。
让我们来拆解这意味着什么、它适合用在哪里,以及哪些营销话术需要收敛一点。

首先是 Jev 要解决的问题
自从工具调用和结构化输出出现后,LLM 与软件对接变得容易多了。
工具调用让模型能够以可预测的形式请求某个函数。结构化输出则让它返回符合 schema 的 JSON。两者都消除了大量脆弱的解析工作。
但底层模型仍然是生成式的。即便答案只是一个词“billing”,它也是逐个 token 生成的。你为输入付费,等待生成,而且往往为输出付更多钱。
现在把它放进一个 agent 循环里。
while not done:
    action = llm(context)
    result = run_tool(action)
    context += result
模型可能会被再次调用,用来选择工具、判断结果、检测风险、决定任务是否完成,以及选择下一个模型。一次 agent 运行可能包含许多需要判断、但不需要生成文本的调用。
Jev 瞄准的正是这些调用。
它的赌注很简单:当代码已经知道可能的答案时,语言生成就是错误的接口。
Jev 究竟是什么
最简短而准确的说法是:一个语义决策引擎。
你向 Jev 发送两样东西:
- 状态:描述当前情况的文本或 JSON。
- 问题:你希望它就该状态做出的决策。
每个问题都会预先声明其答案形态。Jev 支持三种原语:
- Choice 从你定义的列表中挑选一个选项,并为每个选项返回一个概率。
- Score 将输入放置在你定义的有序刻度上,例如低、中、高。
- Noul 通过返回问题为真的概率来回答一个是非题。
Noul 是 TypeSafe 对布尔型原语的命名。这个不寻常的名字并不重要,重要的是输出(一个介于 0 和 1 之间的数字,你的代码可以据此采取行动)。
{
  "model": "jev-latest",
  "state": "The deploy failed twice and customers are seeing 500s.",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "Does this need attention right now?"
    },
    "owner": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "engineering": "Product failures and outages",
        "billing": "Charges, invoices, and refunds",
        "sales": "Pricing and new accounts"
      }
    }
  }
}
响应中包含一个紧急程度概率,以及三个团队上的概率分布。没有需要解读的段落,也没有模型可以凭空捏造的第四个团队。
你的程序保持控制权:
if urgent > 0.9 and owner == "engineering":
    page_on_call()
elif confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(owner)
这就是为什么人们总把 Jev 称作智能 switch 语句。这个说法听起来带有贬义,但它抓住了设计中真正有用的部分。普通代码掌管分支。模型提供的是普通代码无法可靠计算出的模糊判断。

与 LLM 的重要区别
传统 LLM 和 Jev 都能对支持工单进行分类。它们得出答案的方式不同,在系统中适用的环节也各不相同。

TypeSafe 表示,Jev 会并行评估一个请求中的每个问题。这改变了你设计工作流的方式。你不再需要先问一个问题、等待结果、再决定下一个问题是什么,而是可以在一次请求中针对同一状态提出所有相互独立的问题,让代码按需取用相应的答案。
该公司报告称,端到端延迟在 70 到 500 毫秒之间,价格为每百万输入 token 0.042 美元,输出免费。其主打宣传声称,相比同类 LLM 工作流,速度约快 200 倍,成本约低 400 倍。
这些巨大的倍数来自 TypeSafe 自身的工作流评估,且处于对比中最有利的一端。应将其视为上限,而非对每个应用的承诺。其底层优势仍然可信,即 Jev 避免了冗长的推理轨迹和生成式输出,因为它是为有界决策而设计的。

为什么概率很重要
有类型的答案只解决了一半问题。
假设 Jev 将一张工单路由到账单部门。选中的标签告诉你谁赢了。概率分布则告诉你这场竞争有多接近。
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.52,
    "technical": 0.46,
    "sales": 0.02
  },
  "confidence": 0.18
}
自动路由那张工单会是鲁莽的。账单部门赢了,但只是险胜。低置信度的答案应该触发另一条分支。
这给开发者提供了一个实用的模式:
- 高置信度:当后果较小时,自动执行。
- 中等置信度:请求确认,或调用更强的模型。
- 低置信度:将案例交给人工,或收集更多信息。
阈值应该放在代码里,这样它们可以被审查和修改。仪表盘上的标签或许能容忍一个弱的预测。而一条删除数据的命令则应该要求高得多的门槛。
TypeSafe 使用「校准决策强化学习」(Reinforcement Learning for Calibrated Decisions,简称 RLCD)来训练 Jev。目标是让置信度在大量预测中反映准确率。如果一个模型对一组答案给出 90% 的概率,那么这些答案中大约 90% 应该是正确的。
幻觉这一说法需要更精确
TypeSafe 称 Jev 不会产生幻觉。这个说法只有在狭义定义下才成立。
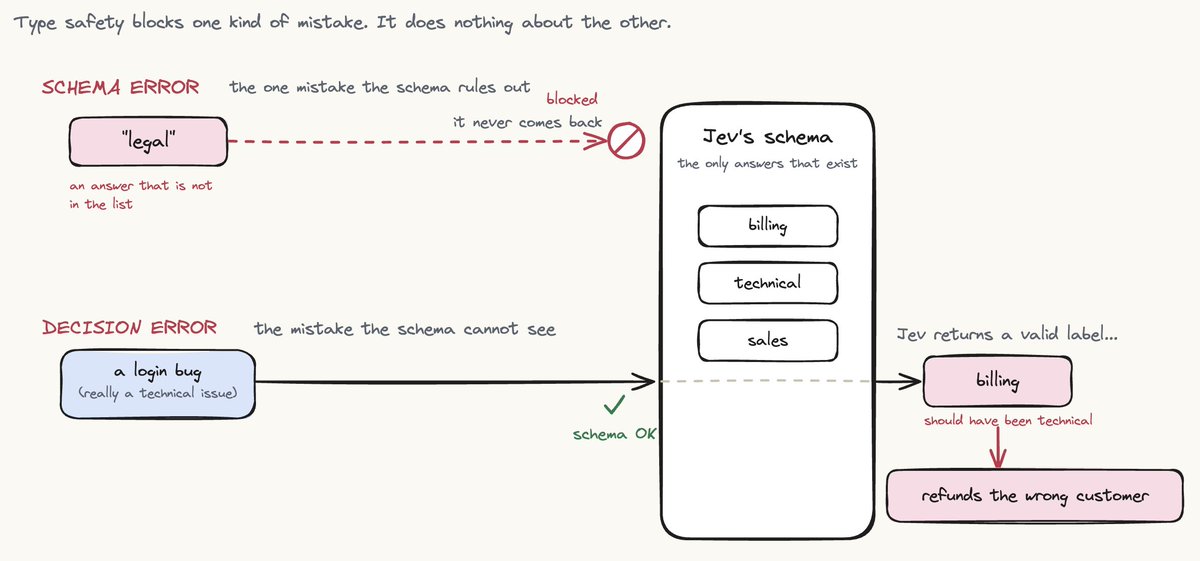
Jev 无法返回 schema 之外的选项。如果你定义了 billing、technical 和 sales,回复就不可能凭空捏造出 legal。它也不会产出格式错误的文本——即你的代码期望一个标签、却得到一段乱码的情况。
但它可能自信满满地选错一个有效的选项。
类型安全防止的是无效的形状,它并不保证判断正确。这一区别很重要,因为一个 schema 层面合法的错误,仍然可能退款给错误的客户、错误地分派事件,或批准一条危险的命令。
更稳妥的说法是:“Jev 不会破坏已声明的输出 schema,但它仍然可能出错。”
Jev 在 agent 中的定位
Jev 最适合与 LLM 配合使用,而非取代 LLM。
LLM 负责需要语言能力或更深层推理的工作。它做规划、写作、解释和使用工具。Jev 则负责围绕这些工作的高频决策。
有三种场景尤其值得采用。
模型路由
一个简单的查找不需要和架构评审用同一个模型。Jev 可以对请求进行评分,然后选择最有可能完成该请求且成本最低的模型。
route = jev.choice(
    state=user_request,
    options={
        "fast": "Lookups, extraction, and small local edits",
        "powerful": "Architecture, ambiguity, and high-stakes work",
    },
)

model = fast_model if route == "fast" else powerful_model
路由器并不负责回答请求,它只决定应该由哪个模型来回答。
工具风险门控
在智能体执行 shell 命令之前,Jev 可以将其归类为只读、可逆或破坏性操作。可以通过一些独立的问题来检查它是否会删除文件、更改 Git 历史、触碰生产环境,或者离开仓库。
高置信度的只读操作可以继续执行。破坏性或不确定的操作可以暂停,等待人工批准。LangChain 的 Jev 集成通过中间件应用了这一模式,在执行前检查工具调用。
验证与监督
智能体可能声称任务已完成,而测试仍然失败。Jev 可以检查状态并回答有边界的问题:测试通过了吗?智能体是否在重复同一个动作?输出是否符合策略?这个结果是否应该被审查?
当存在硬性测试时,它不会取代硬性测试。它在规则取决于语义的地方增加一层语义检查。

Jev 如今能解决的问题
最佳用例具备三个共同特征:你能列出可能的答案,细心的人能快速判断输入,而且这类决策发生得足够频繁,以至于延迟或成本变得重要。
支持与运营
- 对意图、紧急程度、部门、垃圾信息以及客户的不满情绪进行分类。
- 通过若干小型检查来路由退款与政策例外。
- 在人工阅读之前,按语义严重程度对日志和事件进行排序。
单个请求就可以针对同一张工单提出上述所有问题。随后,代码将各项答案组合成公司实际的工单路由策略。
搜索与检索
- 根据检索到的段落是否回答了查询来对其重新排序。
- 检查引文是否支持某项主张。
- 在将上下文发送给昂贵的 LLM 之前,过滤掉不相关的片段。
嵌入非常擅长找到语义相关的文本。Jev 则能做出更窄的判断:某个特定段落对这个问题是否有用。
质量与安全
- 筛查提示词中是否存在越狱或提示注入。
- 对照政策或评分标准检查生成的内容。
- 在风险代码变更或工具调用执行之前将其标记出来。
这些检查应当与确定性控制措施并存。语义分类器适用于模糊的风险,而权限、沙箱和测试则强制执行软件能够精确验证的规则。
大批量分类
- 为文档、研究论文、产品列表或客户消息打标签。
- 将自由文本转化为传统机器学习模型的特征。
- 按照同一套评分标准对大规模语料库中的每一项进行打分。
这正是低单次调用成本超越基准测试数字意义的地方。一项过去因成本过高而无法逐行运行的判断,如今可以融入常规数据管道。
实时交互界面
- 从已知页面元素中选择下一步浏览器操作。
- 在用户写作过程中评估语气或清晰度。
- 从结构化的游戏或模拟器状态中选择一个动作。
Jev 目前仅支持文本,因此这些系统必须先将环境转换为文本或 JSON。它不会看屏幕,也不会从像素中学习操作。

Jev 不适合的场景
一旦答案空间不再已知,Jev 的用处就会大打折扣。
- 它无法撰写回复、总结文档、生成代码或解释推理过程。
- 它在算术、计数、日期比较或精确字符串操作方面不可靠。这些操作应交给代码处理。
- 当决策需要多个隐藏推理步骤时,它会力不从心。应将判断拆分为更小的问题,或使用推理模型。
- 它无法直接提取未知值。应先找到候选值,再让 Jev 从中选择。
- 无关上下文会降低准确率。只发送决策所需的状态。
- 闭源权重、早期访问、仅支持文本输入以及有限的独立校准数据,使得盲目信任它为时过早。
还有一个更简单的规则:如果确定性代码已经能正确解决问题,就保留代码。一个普通的 if 语句比任何模型都更快、更便宜、更易于测试。
如何在不引入新故障模式的前提下使用 Jev
一个便宜的模型如果其错误会导致重试、人工审核或生产事故,那它依然可能很昂贵。要衡量整个工作流,而不是只看 token 价格。
一个合理的推广方式如下:
- 选择一个边界清晰、风险低、可能答案明确的决策。
- 在调用模型之前先写好评分标准。定义每个选项应包含什么。
- 收集带有预期答案的代表性示例,包括模糊和对抗性案例。
- 让 Jev 以影子模式与当前工作流并行运行,但不让它改变行为。
- 绘制准确率与置信度的关系图,并根据你的数据设定阈值。
- 先自动化最安全的分支,对不确定的情况保留人工或更强的模型。
- 固定或记录模型版本、问题、标准和阈值,以便变更时可以在同一评估集上重放。
问题本身就是程序的一部分。像对待代码一样对待它们:版本化、审查,并在模型或评分标准变化时进行测试。

真正的转变
Jev 的有趣之处,不在于它能在写作上击败 LLM。它拒绝写作。
它的贡献在于一种形如软件的模型接口:固定的答案类型、显式的不确定性、并行提问,以及由代码控制的分支。
这使它成为生成式模型的有用伙伴。LLM 产出计划、解释或代码。Jev 则负责路由请求、把守高风险操作、检查结果,并判断不确定性何时高到需要上报。
即便最终有另一个模型取代 Jev,这个更宏大的理念依然重要。多年来,我们一直要求生成式模型通过文本来完成各种智能任务。许多生产系统并不需要更多的文字。它们需要的是一种小巧、快速、普通软件可以安全使用的判断。
这正是 Jev 试图构建的类别。
从哪里开始
不要一开始就围绕 Jev 重建你的智能体。先找出一个目前需要缓慢的 LLM 调用、或者一个总是出问题的正则表达式来处理的决策。
给 Jev 最小的状态,定义可能的答案,并把它的概率与当前结果一起记录下来。先让它证明自己值得拥有一个分支,然后再把整个工作流交给它。
最有用的心智模型仍然是最简单的那个 → Jev 在普通 if 语句能理解值、却理解不了其含义的地方,补上判断。
来源与延伸阅读
希望你喜欢这篇文章。
我们下期再见。
干杯!:)