
Jev-Mem:无需LLM的记忆决策
Jev-Mem 证明频繁的记忆决策无需会写句子的 LLM,但阈值仅在一个模型一个基准上校准过。

Jev-Mem 表明,记忆决策并不需要一个会写句子的 LLM。它的阈值仅在一个基准上用一个模型做了测试。
每个智能体记忆系统每时每刻都在做大量的小决策。
- 这条新消息是一种偏好,还是一个事件?
- 它和已经存储的某些内容有关吗?
- 这个查询到底该搜索记忆的哪一部分?
- 证据是否已经足够,可以停止查找了?……还有更多。
大多数方案把这一切都交给一个通用 LLM。模型一个 token 一个 token 地写出答案,然后由某段代码去解析它。
对于一个是/否问题来说,这工作量也太大了!!
UT Dallas 的一篇新论文 Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents 基本上是在说:对其中大多数决策,别再这么干了。
以下是概要
Jev 是什么?
Jev 是 TypeSafe AI 的一个模型,它无需写出任何文本就能回答结构化问题。你给它一些状态,比如一个查询和一条记忆、一批问题,它还给你数字。没有散文。
论文使用了两种问题类型:
- Noul: 论文对是/否问题的称呼。你给它一条指令,以及明确的真、假判定标准,Jev 返回一个 0 到 1 之间的值。
- Choice: 从一组固定选项中选一个。你拿回被选中的标签,以及所有选项上的分布。
由于每个问题都有一个很小且已知的输出空间,所以没有什么需要解析的。而共享同一状态的问题会在一次批量调用中一起发出。
论文借用了系统一与系统二的划分作为类比。系统一是一个轻量级控制器,负责做出那些小的记忆决策,而 Jev 是作者为其采用的实现。系统二是写出最终答案的 LLM。成本全在于答案被写出之前发生的那些细小的记忆决策。
Jev-Mem 如何将其用于记忆
论文中的关键观察相当简单。许多记忆操作是语义性的,而非生成性的,这意味着它们需要判断,但输出的是一个标签或分数,而不是一段文字。

写入路径(当一条记忆进入时):
- 每个观察都成为一个记忆节点。
- Jev 给它四个相互重叠的类型分数:情景记忆、语义记忆、程序性记忆、偏好。因此一条记忆可以属于不止一种类型。
- 纯向量搜索、关键词重叠、共享实体和时间戳最多挑选 10 条已有记忆作为候选。
- Jev 只判断这些配对。它们相关吗?一个导致了另一个吗?属于同一段经历吗?
- 当分数达到 0.60 时,就会创建一条边。
- 任何不需要判断的东西都留在普通代码中。时间戳确定顺序,完全相同的共享 ID 创建实体链接。
读取路径(当一个查询进入时):
- Jev 为查询所需的关系类型(语义、时间、因果、实体)打分,并评估它在多大程度上依赖多跳推理和时近性。
- 搜索力度会根据这些分数,分配到上述关系类型上。
- 然后检索以循环方式运行:找到入口点,检查证据是否足够,扩展到邻居,给新候选打分,再检查一次。
- 只有当这个循环停止后,被选中的记忆才会送到 LLM。
Jev-Mem 处于什么位置?
每个记忆系统都做三件事:写入记忆、检索记忆,并把它们交给 LLM 来作答。Jev-Mem 把作答交给 LLM,而把另外两步中的决策权移交给 Jev。
- 写入时,Jev 为新记忆标注类型,普通搜索最多挑出 10 条相关候选,再由 Jev 决定要建立哪些链接(语义、时间、因果、实体)。
- 检索时,Jev 把查询路由到正确的链接类型,设定搜索预算,对找到的内容打分,并决定何时停止。直到这时,LLM 才会看到任何东西。
Jev-Mem 是一套完整的架构,拥有自己的多关系记忆存储,而不是一个即插即用的控制器。
两个有力的想法
- 全部保留,稍后再挑: 他们的配置关闭了准入过滤,因此每一条有效、非空的观察都会被存储。挑剔的部分发生在建立关系时以及读取记忆时。这一推理是合理的,因为今天看起来没用的东西,可能恰恰是未来某个查询所需要的,而写入时的过滤会把它永久丢失。这里的隐患在于更正。如果用户更新了一个事实,两个版本都会留在记忆中,而论文并未测试更新后的版本在作答时是否真的胜出。
- 不删除的整合。 每 20 次写入,Jev 就会对成对的相关记忆进行打分,评估其冗余、矛盾、过时程度,以及建立链接是否有帮助。然后它从四个选项中挑一个:保持独立、合并、提升,或不确定。默认情况下,它只记录链接,原始记忆始终保留。只有当接入 LLM 摘要器时,合并或提升后的记忆才会被写入,而且只有在 Jev 选择合并或提升且得分至少为 0.85、同时矛盾得分保持在 0.85 以下时才会发生。即便如此,新记忆也是与原始记忆并列存放,而非取而代之。
报告
在 LoCoMo 上,以 GPT-4o-mini 作为回答模型:

- 回答质量: LLM-as-a-Judge 评分为 0.777,而最强基线为 0.700,相对提升 11.0%。
- 构建时间: 构建记忆耗时 158 秒,而最快的竞争系统为 1,044 秒,约快 6.6 倍。
- 查询延迟: 平均 0.93 秒,而最快的基于记忆的基线为 1.47 秒,低 36.7%。这包括检索和答案生成。
数字很漂亮。但在你据此行事之前,有几点需要注意:
- 单一基准、单一设置: 只有 LoCoMo、一个回答模型和一个 LLM 评判器。请仅与相同设置下的数字进行比较。
- 6.6 倍是构建时间,不是查询速度: 论文将之归功于类型化、批处理决策,但实现中也做了缓存,因此很难说各自贡献了多少。
- 延迟是平均值: 没有尾部延迟数据,也没有并发写入下的测试,而这恰恰是生产环境真正关心的。
- 控制器的贡献只被部分隔离: 最强基线 MAGMA 来自同一团队,且仓库称在不使用 Jev 的情况下运行即可得到 MAGMA 基线。但论文没有报告仅写入或仅读取的消融实验。此外,正文与表 1 在几个类别分数上存在不一致,因此以表格为准。
真正的陷阱:阈值
整个设计都建立在截断值之上:
- 当分数达到 0.60 时创建一条边。
- 当分数达到 0.10 时,为某个查询激活一种关系类型。
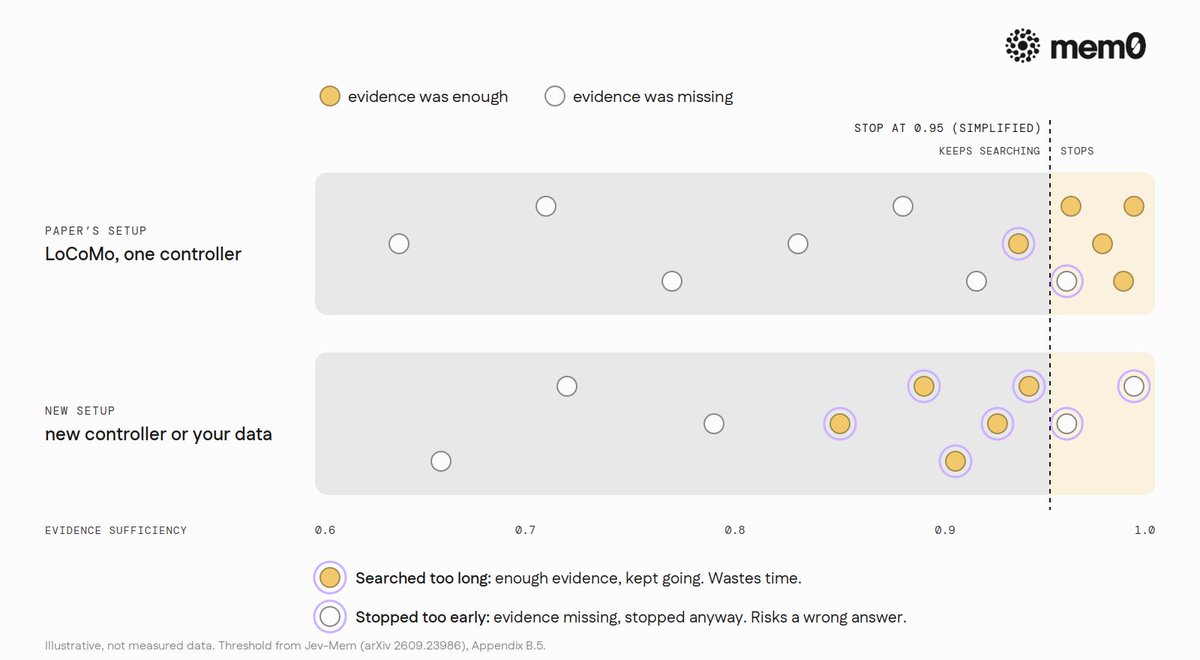
- 当证据充分度至少为 0.95 且 缺失证据分数与矛盾分数均低于 0.15 时,或者当“继续推进”分数降至 0.15 以下时,检索停止。
附录对此相当坦诚:返回的数值并不被假定为经过校准的概率。
说实话,这就是全部了。
0.95 这个截断值只有在 0.95 每次含义都一致时才有意义。这些阈值仅在一个基准上、用一个模型评估过。换掉控制器模型,或者换到与 LoCoMo 完全不同的数据上,同样的截断值就可能过早停止检索,或者让噪声混入。
循环设有上限(深度 8、访问节点 60 个、控制器调用 16 次、15 秒),所以它不会永远跑下去。但它仍然可能做出错误判断,而由于 LLM 只能看到控制器交给它的内容,那个停止阈值恰恰就是速度与正确性权衡的地方。
所以我们的结论不是“把你的 LLM 换成 Jev”。而是:一个快速的分类器完全有能力做记忆决策,但在你信任它的阈值之前,先在你自己的数据上校准它的分数。
如果你已经在使用记忆层,这可以如何融入
你不必为了尝试这个而重建自己的记忆设置。如果你使用 Mem0,搜索已经会返回带有相关性评分和时间戳的排序记忆。在 Platform 上,该评分是一个由语义、BM25 关键词和实体信号组合而成的 0 到 1 的值。
因此,你可以在该搜索与你的模型之间插入一个带类型的分类器,让它在模型看到每条记忆之前,先检查它是否真的与当前查询相关:
from mem0 import MemoryClient

client = MemoryClient(api_key="your-api-key")
THRESHOLD = 0.5  # placeholder: tune on your own labeled queries

def relevance(query: str, memory: str) -> float:
    """Swap in Jev or any classifier that returns a score from 0 to 1."""
    raise NotImplementedError

query = "What should I cook tonight?"
results = client.search(query, filters={"user_id": "user123"})
memories = [
    r["memory"] for r in results.get("results", [])
    if relevance(query, r["memory"]) >= THRESHOLD
]
# Pass `memories` to your LLM as context.
需要说明的是,这是一种需要你自己构建和测试的模式,而不是现成的集成。
Mem0 的自动路径也是累加式的,因此一个旧事实及其更新都可能从搜索中返回。这就是时间戳重要的原因:它们让你的模型能看到哪个版本更新。如果你的应用知道某个事实发生了变化,你也可以直接用 update 或 delete 来更正它。
总结
Jev-Mem 有力地证明了,频繁的记忆决策并不需要一个会写句子的模型。类型化、批量化、有界的决策,是一种把成本从记忆路径上卸下来的干净做法。
仍然悬而未决的是:控制器单独贡献了多少、它在真实生产负载下表现如何,以及那些阈值在测试环境之外是否依然成立。
快速的记忆决策是容易的部分。校准它们才是真正的工作。
如果你正在自己的技术栈里摆弄记忆控制,我们很想听听你看到了什么。
参考文献
论文与代码
- Jiang、Li 和 Li,Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents, arXiv:2609.23986(v1,2026 年 9 月 21 日)
- Jev-Mem 仓库:github.com/libingzheren/Jev-Mem
Mem0
- Mem0,快速开始
- Mem0,搜索记忆
- Mem0,Mem0 的工作原理