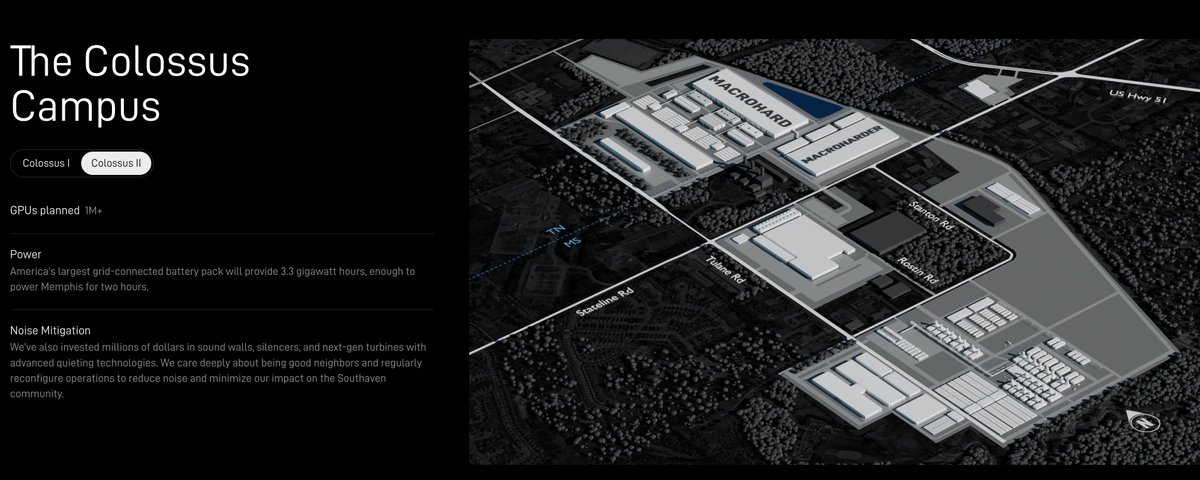
SpaceX的巨型智能工厂
xAI 的 Colossus 到 12 月底 GPU 将从 78 万增至约 144 万(+85%),但以 GB300 为主的换代使有效算力近乎翻倍、峰值 tok

埃隆最近披露的 Colossus 相关数字如此庞大,以至于用超级计算机来称呼它,可能已不足以描述 xAI 正在建造的东西。

据埃隆所说,Colossus 1 包含 150,000 块 NVIDIA H100、50,000 块 H200 和 30,000 块 GB200。
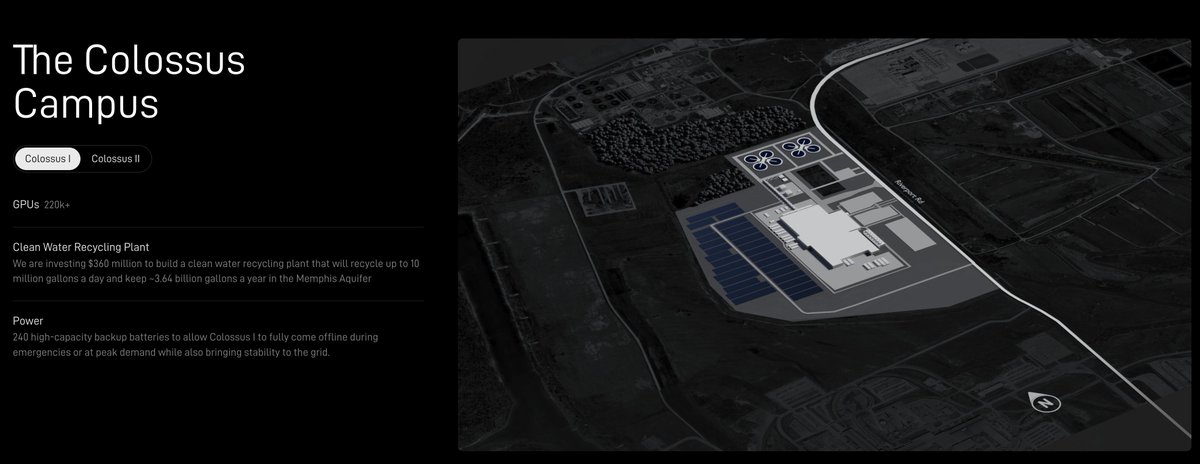
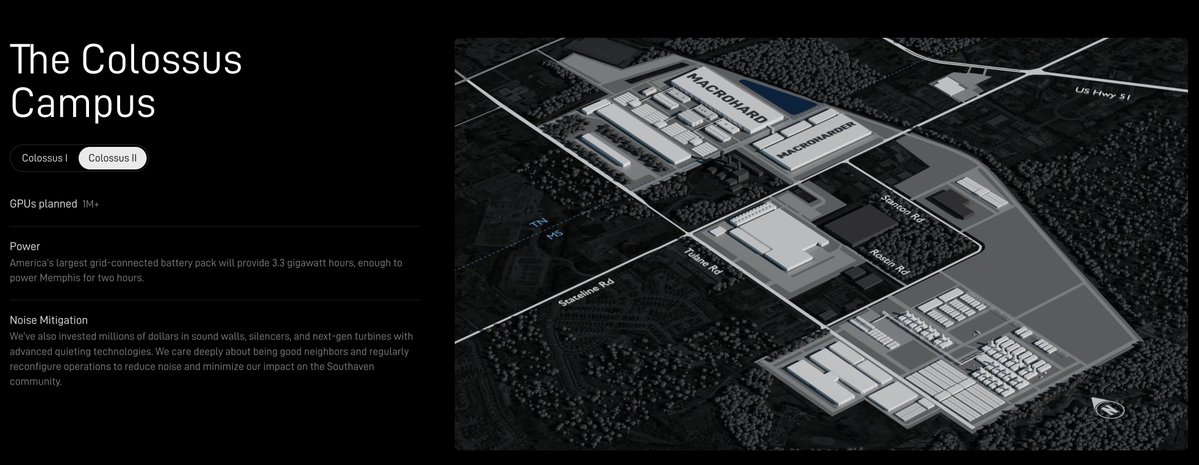
Colossus 2 已经包含 110,000 块 GB200 和 440,000 块 GB300。
这意味着目前合计约有 780,000 块 NVIDIA 加速器。马斯克表示,另有 220,000 块 GB300 应会在下周全面投入运行,11 月再增加 220,000 块,到 12 月下旬可能还会再增加 220,000 块。今天发布的独立报道也印证了这些数字。
如果这一时间表如期推进,进展大致如下:
今天: 约 780,000 块 GPU
下周: 约 1,000,000
11 月: 约 1,220,000
12 月下旬: 可能约 1,440,000

这意味着从现在到 12 月下旬,GPU 数量将增长 85%!
但比 144 万块 GPU 和 85% 的增长率更重要的是这些 GPU 是什么类型。到 12 月下旬,其中多达 110 万块可能是 GB300 Blackwell Ultra GPU。
这不再主要是一个 H100 集群
最初的 Colossus 之所以闻名,是因为 xAI 以惊人的速度组装了大约 100,000 块 H100。如今看来,这一成就几乎显得微不足道。
在 Elon 的年末设想中,Colossus 将包含大约:
- 150,000 块 H100
- 50,000 块 H200
- 140,000 块 GB200
- 1,100,000 块 GB300
到年底,较旧的 H100 将仅占 Colossus GPU 的约 10%。该系统的大部分将围绕 NVIDIA 更新的 GB300 Blackwell Ultra 构建。
GB300 不仅仅是多一块 GPU。对于如今变得至关重要的各类 AI 工作负载,尤其是推理、长上下文模型、AI 智能体以及大型混合专家模型,它的强大程度远超 H100。
NVIDIA 的 GB300 系统还设计为能够以极大规模协同工作。单个 NVL72 机架集成了 72 块 GB300 GPU 和 36 颗 Grace CPU,拥有大约 20 TB 的高速 GPU 内存以及芯片之间极快的连接。这使得这些 GPU 更像一个巨大的计算系统,而不是数十个独立的处理器。
以 H100 等效算力计算
数 GPU 数量可能会产生误导。H100 等效算力会把较新的 GPU 换算成它们相对于 H100 大致代表的算力。可以把它想象成把不同排量的发动机换算成一个通用的马力指标。
因此,虽然图表显示 Colossus 从如今的约 78 万块物理 GPU 增长到 12 月下旬的 144 万块,但其算力增长要快得多。
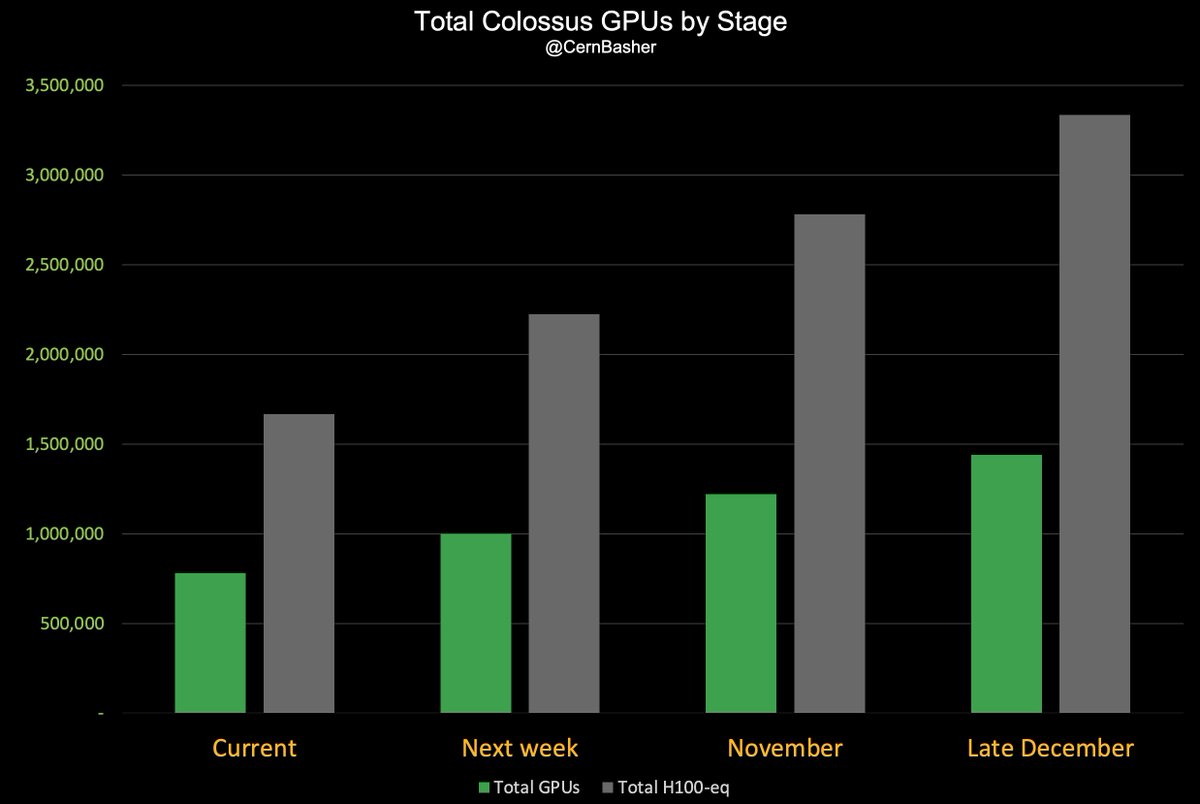
按 H100 等效算力计算,增幅大约为:
当前: 78 万块 GPU → 约 170 万 H100 等效算力
下周: 100 万块 GPU → 约 220 万 H100 等效算力
11 月: 122 万块 GPU → 约 280 万 H100 等效算力
12 月下旬: 144 万块 GPU → 约 330 万 H100 等效算力
因此,Colossus 不只是比今天多出 85% 的 GPU。其有效算力可能大约翻倍。
而且,对于某些现代 AI 工作负载,即便是 H100 等效算力也可能低估了这种提升,因为 GB300 专门针对推理和推断工作负载进行了优化,而这类工作负载正日益主导前沿 AI。
H100 等效算力可能仍低估了这一跃升
即便是 H100 等效算力,也可能无法完全反映正在发生的事情。
H100 等效算力之所以有用,是因为它把不同代的 GPU 换算成一种统一的理论算力单位。但 AI 用户最终买的不是 FLOPS。他们买的是有用的智能,而对于推理来说,衡量这种产出最重要的指标之一,就是硬件能够处理和生成多少 token。
这正是 Blackwell 看起来截然不同的地方。
SemiAnalysis 最近用其 AgentX 智能体编程工作负载,在 H100、H200、GB200 和 GB300 硬件上测试了 DeepSeek V4.1 Flash。看 SemiAnalysis 在所有配置下测得的最高总吞吐量,结果如下:
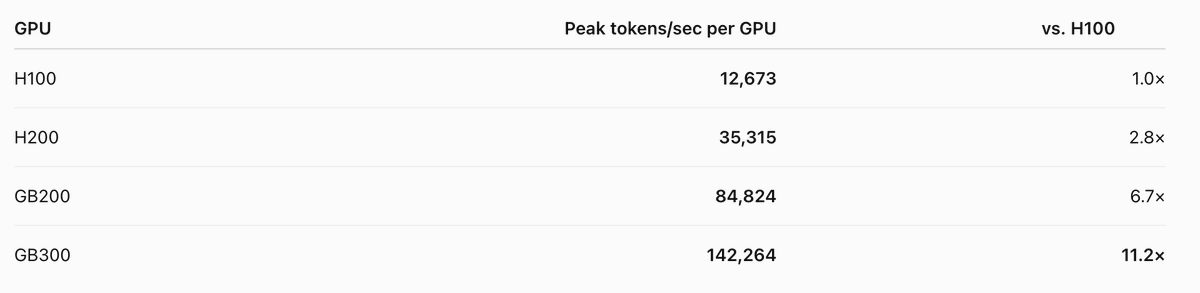
因此,在这个特定的推理工作负载上,一块 GB300 的峰值 token 吞吐量是一块 H100 的 11 倍以上。这比你可能仅凭 GPU 数量——甚至常规的 H100 等效算力计算——所设想的差距要大得多。
用 SemiAnalysis 的峰值吞吐量数据来算,峰值 token 吞吐量大致为:
当前: 约 781 亿 token/秒
下周: 约 1094 亿
11 月: 约 1407 亿
12 月下旬: 约 1720 亿

因此,尽管物理 GPU 数量从 78 万块增至 144 万块,增幅约 85%,但建模得出的峰值 token 吞吐量增幅约为:120%。它翻了一倍还多。
一个有用的类比是工厂。数 GPU 就像数工厂里有多少台机器。H100 等效算力更好,因为它试图考虑到有些机器比其他机器更强这一事实。但工厂能产出多少产品,才是我们真正关心的。
对一座 AI 推理工厂而言,衡量其产出的一种可能单位是 token。而按这种方式衡量,Colossus 的蜕变就显得更加惊人。
在此阅读下一篇文章:Colossus:价值 1000 亿美元的 AI 工厂——出租算力或许是其价值最低的用途
